
14주차: 운영 전환 - 실패 기록, 재현, 수신자 기준
□ 주제
- 최종 프로젝트 개발 및 운영 전환: 실패를 숨기지 않고 같은 조건에서 다시 보는 기록
- 프로토타입에 제공된 로깅·모니터링 코드 연결, 실패 케이스 3건의 재현과 멘토 리뷰 자료 작성
□ 이번 주가 놓이는 자리
- 9주차: 검색한 근거가 답으로 이어지는 경로 확인
- 12주차: 설명과 답, 책임 범위와 개인정보 수집 경계 구분
- 13주차: 연구 주장을 실험 조건과 함께 읽고 적용 범위 판단
- 14주차: 같은 모델 이름이라도 바뀐 입력·프롬프트·평가 기준이 결과에 미치는 영향 기록
- 15주차: 실패와 복구 근거를 포함한 최종 발표·데모
- 이번 주 결과물:
bundle.json,failures.jsonl, 재현 대조 출력, 수신자 기준표, 멘토 리뷰 자료
□ 이번 주 질문
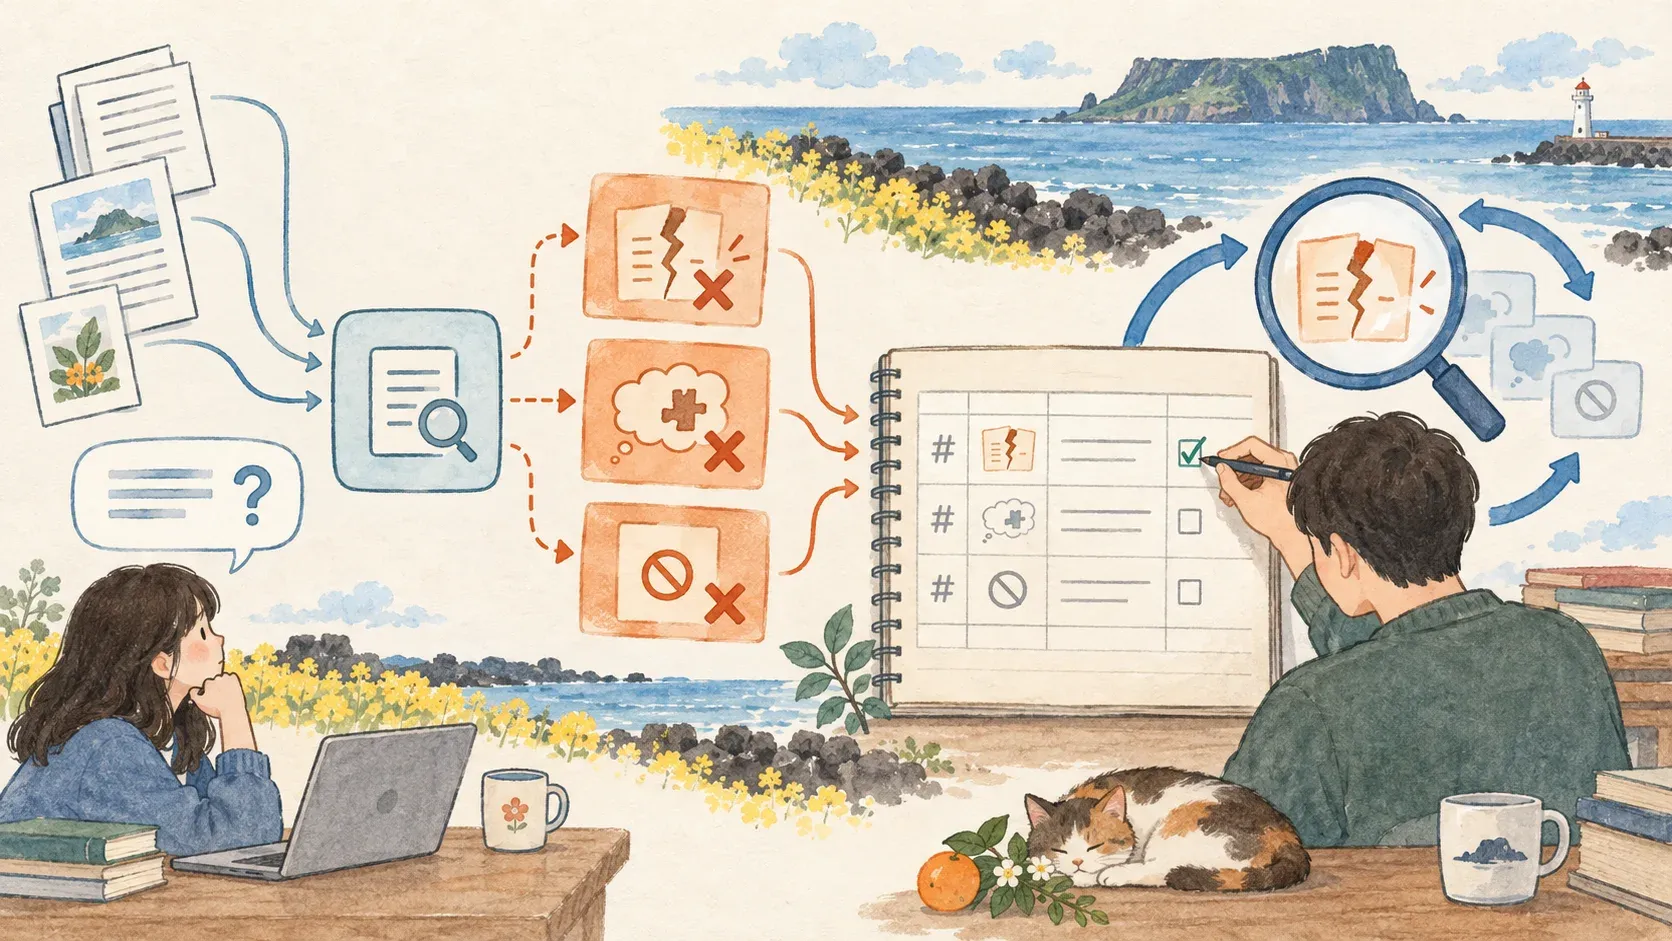
- 어제 실행된 질문이 오늘 실패할 때, 바뀐 것이 입력인지 프롬프트인지 모델인지 구분하는 근거
- 오류 없이 끝난 코드와 수신자가 사용할 수 있는 결과의 차이
- 이전 지표는 통과하지만 지금 필요한 필드가 누락된 경우의 판정
- 원문을 모두 저장하지 않고도 재현 가능한 교육 실험을 만드는 방법
- 한 사람이 개발·운영·소통을 겸할 때 먼저 보호할 역할
□ 읽기 안내와 본문 연결
| 자료와 읽을 지점 | 먼저 찾을 질문 | 본문 연결 |
|---|---|---|
| Sculley 외, Hidden Technical Debt in Machine Learning Systems, abstract와 환경 변화 논의 | 코드 밖의 의존성이 왜 유지 비용을 만드는지 | 실패 경로 분리 |
Python time, perf_counter 문서 | 지연에 시스템 시각 차이를 쓰면 생기는 문제 | 단조 시계와 지연 기록 |
Python logging, Logger·Handler 설명 | 메시지 생성과 전달을 분리하는 이유 | 제공 로거 연결 |
| 공개 문서 고정판 42464087의 행정구역 | 이름과 수의 기준이 무엇인지 | 작성 fixture의 외부 사실 문맥 |
| 이번 노트북 4·5절 | 어떤 파일과 값이 있어야 replay가 가능한지 | 로그·버전 묶음과 재현 |
□ 예제의 출처와 범위
- 공개 출처: 위키백과 「제주특별자치도」 고정판 및 저자 목록, CC BY-SA 4.0
- 교수 작성 자료: 질의 3개, 규칙형 QA 코드, 평가 기준, 역할별 검토안
- 행정시 이름을 실행 시 공개 고정판에서 확인. 조회 실패는 미확인 표시
- 작성 규칙의
rule-v1·rule-v2는 학습된 언어모델 가중치가 아닌 교육용 계산 정책 - 실측: 제공된 코드의 오류·필드·판정·CPU 지연. 실제 기업 시스템·언어모델·멘토 활동 실측 없음
- 현장 수신자 조건은 수업용 상정. 도내 기업 데이터·개인 질의·고객 토큰 없음
온라인 (2시수)
Section titled “온라인 (2시수)”강의: 배포 후 성능이 떨어지는 경로
Section titled “강의: 배포 후 성능이 떨어지는 경로”□ 왜 최종 정확도만으로 실패를 설명하기 어려운가
- 개발 때의 “제주의 행정시는 몇 곳?”에 두 이름과 2곳을 반환하는 프로토타입
- 사용자가 “제주 두 도시의 총 개수는?”로 질문하면 같은 사실을 묻더라도 규칙의 키워드를 벗어나는 상황
- 모델을 고친 적이 없어도 응답 실패 발생. 프롬프트만 바꾸면 이름은 맞지만 count 필드가 사라지는 상황도 존재
- 한 점수로 묶으면 입력 대응 문제와 출력 계약 문제가 같은 “오답”으로 보이는 손실
- 해결 순서: 기준 실행 고정, 변화 항목 기록, 실패 수집, 같은 조건 재실행, 수신자 영향 검토
□ 입력 분포 이동(input distribution shift)
- 개발·평가 때 자주 보던 입력과 실제로 들어오는 입력의 분포가 달라지는 현상
- 질의의 어휘·길이·언어·목적·근거 요구 방식의 변화 가능
- 예제 F1:
행정시라는 표현 대신두 도시의 총 개수라는 작성 질의 사용 - 기준 코드와 프롬프트를 그대로 유지해도 키워드 조건을 통과하지 못해
unsupported_input발생 - 이 한 예시는 입력 표현 변화의 실패 경로 시연. 지역 이용자의 실제 분포 이동을 추정하는 표본 아님
- 운영 확인: 실패 입력의 유형과 변화 시점 관찰. 실패 한 건을 전체 사용자 성능 저하로 일반화 금지
□ 프롬프트 갱신(prompt revision)
- 같은 질의와 같은 계산 규칙에도 출력 지시가 바뀌면 답 형식과 필드가 달라질 수 있는 구조
- 예제 F2:
prompt-v1은 이름과 수 반환,prompt-v2는 이름만 반환 - 공개 이름은 남아 있으므로 사람이 두 곳이라고 추론할 수 있지만 자동 집계는 count 필드를 받지 못하는 상황
- 프롬프트 변경을 “문장만 수정”으로 보지 않고 출력 계약 변경 여부를 검토할 필요
- 실제 생성 모델에는 확률적 변화도 존재. 이번 규칙형 시연에는 난수·모델 호출 없음
□ 모델 갱신(model revision)
- 모델 가중치·토크나이저·추론 구현 등이 바뀌면 입력이 같아도 결과가 달라질 수 있는 경로
- 교육 예제에서는 학습을 하지 않고
rule-v2의 count 계산에 1을 더하는 오류를 삽입 - F3: 두 이름을 그대로 반환하지만 수는 3. 이름 포함 검사는 통과하고 count 검사는 실패
- 실제 모델 갱신의 효과를 재현한 실측이 아니라 변경 경로를 분리하기 위한 정책 모형
- 운영 확인: 모델 버전만 적지 않고 프롬프트·검색 자료·코드·실행 설정 버전도 함께 기록
□ 평가 지표의 노후화(stale metric)
-
시스템에서 필요한 판단이 달라졌는데 평가 기준은 예전 대상을 계속 측정하는 상태
-
예전 과업이 이름 안내였다면 이름 포함 검사는 일부 요구를 반영
-
지금 수신자가 자동 집계 프로그램이라면 count의 존재·형식·정확성도 계약에 포함
-
같은 출력에서 지표만 바꿔 판정이 달라지는 현상. 입력·프롬프트·모델 변화와 다른 관측 경로
-
지표가 나빠진 것인지 서비스 요구가 바뀐 것인지 구분하려면 평가 목적·버전 함께 기록
-
관찰 질문: F2와 F3가 이전 지표를 통과할 때, 어느 변경을 되돌려야 count가 복구되는지 예측
- 그림 해석: 실행 변경 세 종류와 측정 기준 변경 한 종류의 분리. 지표 노후화 자체를 새 모델 오류로 단정하지 않는 원칙
강의: 제공된 로깅·모니터링 코드 연결
Section titled “강의: 제공된 로깅·모니터링 코드 연결”□ 기록 없이 고치는 작업의 비용
- “한 번 이상했음”이라는 기억만 남으면 당시 질의·모델·자료·출력 계약을 알 수 없는 상태
- 최신 코드로 다시 실행하면 이전 실패가 사라져 원인 판단이 어려운 상황
- 단순히 로그를 늘리는 대신 재현에 필요한 식별자와 묶음을 먼저 정의
- 이번 실습: 완성된
attach_monitor와 두 로거 중 하나 연결. 새 logger·replayer를 학생이 작성하지 않는 방식
□ 기록 단위와 재현 단위의 차이
| 단위 | 이번 제공물 | 역할 | 한계 |
|---|---|---|---|
| 실행 기록 | failures.jsonl | ID, hash, 버전, 지연, 오류·판정 기록 | hash만으로 원문 복원 불가 |
| 공개 fixture registry | bundle.json의 fixtures | 작성 질의와 기대 count 연결 | 실제 개인 질의를 복사하는 방식으로 확장 금지 |
| 실행 묶음 | 같은 파일의 코드·config·retrieval | 이전 조건 고정 | 외부 모델 가중치 재현을 보장하지 않는 교육 모형 |
| 재현 대조 | 제공 replay 코드 출력 | 출력 hash·오류·판정 일치 확인 | 현재 CPU 지연의 동일 값 보장 불가 |
□ 최소 로그의 열
id,query_version,query_hash,output_hash: 작성 질의와 결과 식별model_version,prompt_version,config_id,config_hash: 변경 조건 식별retrieval_version,retrieval_hash,source_oldid: 근거 자료 조건 식별code_hash,bundle_hash: 제공 코드와 전체 재현 묶음 대조latency_ms,error,outcome,correct: 실행 상태와 판정metric_version,stale_metric_version,stale_pass: 평가 대상 변화source_verified: 공개 사실 조회가 성공했는지 표시. 규칙 실행 성공과 별도
□ 한 곳 연결의 기본·대안
# 기본: ID·hash·버전·판정 저장run_with_monitor = attach_monitor(minimal_logger)# 제공 대안: 이번 공개 작성 질의 열 추가run_with_monitor = attach_monitor(public_fixture_logger)- 노트북에는 기본 연결 한 줄만 TODO 표시
- 학생 활동: 기본 전체 실행 후
minimal_logger를public_fixture_logger로 교체하고 전체 재실행 - 알고리즘 추가가 아닌 제공 코드 연결 정책 선택
- 두 방식에서 같은 실패 3건과 replay 결과 유지. 대안에서만
public_authored_query열 추가 - 대안은 이번 공개 작성 질의만 허용. 실제 개인 원문·토큰·이름·연락처를 로그에 넣는 정책 아님
□ hash가 개인정보 보호를 보장하지 않는 이유
-
후보가 적은 질의는 후보별 hash를 계산해 원문을 추정하는 공격 가능
-
식별자 자체도 다른 로그와 결합되면 관계 정보가 될 수 있는 구조
-
원문 최소화는 수집량을 줄이는 선택, 법적 익명화나 보안 보장과 별개
-
운영에서는 목적·접근 권한·보존 범위·삭제 조건 검토 필요
-
이번 공개 fixture 파일은 공개 작성 질문의 재현용. 개인 사용자 registry 구축 요구 없음
-
관찰 질문: 로그 파일만 있고
bundle.json이 없다면 질의 hash를 보고 그대로 실행할 수 있는지 예측
- 그림 해석: 로그의 원문 축소와 공개 fixture의 확보를 함께 설계. hash만 저장했다고 재현이 저절로 가능해지는 것은 아님
□ 지연은 시각이 아닌 경과 시간
perf_counter()는 짧은 실행 시간 측정에 사용하는 고해상도 시계- 계산:
latency_ms = (끝 값 - 시작 값) × 1000 - 작은 대입 예: 시작 100.000초, 끝 100.003초라면
(0.003) × 1000 = 3ms. 설명용 수치, 이번 노트북 실측 아님 - 노트북 지연은 현재 실행에서 각 행에 측정. 하드웨어·프로세스 부하에 따라 달라질 수 있는 값
- 버전·출력 hash는 일치 대상, 경과 시간의 byte 일치는 재현 조건에서 제외
- 측정 누락을 0ms로 채우지 않는 원칙. 네트워크 서비스의 지연으로 일반화 금지
강의: 실패 3건과 노후 지표의 차이
Section titled “강의: 실패 3건과 노후 지표의 차이”□ 출력 결과부터 보는 작은 실험
| ID | 변경 조건 | 실제 제공 규칙 출력 | count 기준 | 이전 이름 포함 기준 |
|---|---|---|---|---|
| 기준 | 기본 질의, rule-v1·prompt-v1 | 제주시, 서귀포시, 2곳 | 통과 | 통과 |
| F1 | 표현 이동, 기본 버전 유지 | 판단 보류 | 실패: 값 없음 | 실패 |
| F2 | 기본 질의, prompt-v2 | 제주시, 서귀포시 | 실패: 값 없음 | 통과 |
| F3 | 기본 질의, rule-v2 | 제주시, 서귀포시, 3곳 | 실패: 값 3 | 통과 |
- 표는 노트북의 결정적 작성 규칙을 설명하는 기대 출력. 노트북 실행 결과와 대조할 대상
- 모델 생성 결과·기업 장애 통계·자연 발생 실패 수집이라고 표기하지 않는 원칙
- 실패 케이스 셋만 보면 새 지표 통과
0/3 = 0%, 이전 지표 통과2/3 ≈ 66.7% - 분모 3은 의도적으로 실패를 넣은 교육 집합. 운영 트래픽의 정확도 추정 분모 아님
- 기준 실행은 비교용이며 실패 기록 파일에는 F1·F2·F3 세 행만 저장
□ 무엇이 원인이고 무엇이 관측인가
- F1: 입력에 없는 키워드로 미응답. 모델 변경으로 판정할 근거 없음
- F2: count 누락이지만 예외 없음.
error=None을 성공으로 간주하면 놓치는 출력 계약 실패 - F3: 잘못된 수치지만 예외 없음. 예외 감시와 의미 품질 감시를 따로 둘 이유
- 이전 지표의 2/3 통과: 두 이름 존재만 측정하므로 새 요구의 누락·모순을 놓치는 관측
- 코드 예외, 응답 유무, 필드 계약, 사실 일치의 별도 열 필요
□ 정답 라벨이 없는 실제 입력
-
교육 fixture에는 기대 count 2가 있으므로 exact-count 비교 가능
-
실제 운영에서는 입력이 들어왔어도 정답 검토가 아직 없을 수 있는 상태
-
correct=None,outcome=unknown으로 표시. 실패도 성공도 확정하지 않는 원칙 -
정확도 분모: 라벨 확인된 건수. 함께 보고할 라벨 커버리지: 확인된 건수 / 전체 기록 수
-
예: 5건 중 라벨 3건, 그중 통과 2건이면 정확도
2/3, 라벨 커버리지3/5. 설명용 계산, 이번 실패 표의 실측 아님 -
라벨 없는 2건을 오답으로 채우면
2/5, 제외 사실을 숨기면 커버리지 공백. 둘 모두 오해를 만드는 방식 -
관찰 질문: 이전 지표가 66.7%이면 수신 프로그램에 count를 보내도 되는지 판단
- 그림 해석: 예전 측정 대상이 새 출력 계약을 덮지 못하는 상황. 통과 비율 상승만으로 현재 서비스 요구 충족 선언 불가
수신자와 실패 판정 관찰기
교수 작성 규칙형 예시. 같은 출력에 다른 수신 기준을 적용하는 비교
멘토 의견이나 실제 이용자 만족도 미측정. 수신 조건은 수업용 상정. 재현 성공은 출력 품질 통과와 별도.
□ 재현 성공은 품질 성공이 아님
- 제공 replay는 저장된 코드·질의·검색 자료·config hash와 묶음 hash를 먼저 대조
- 같은 조건으로 F1·F2·F3를 실행한 뒤 출력 hash·오류·판정을 검증
- 세 실패가 그대로 돌아오는 것이 replay 통과
- 품질 관점에서는 여전히 세 실패. 재현을 확보했으므로 변경 전후 비교가 가능해진 상태
- 바뀐 코드를 이전 hash로 속이거나, 최신 자료로 과거 결과를 덮어쓰지 않는 원칙
- 현재 규칙 모형은 결정적. 실제 생성 시스템은 seed·추론 설정·가중치·실행 환경을 추가로 고정해도 완전 일치가 어려울 수 있는 한계
□ 온라인 관찰 순서
- 기준 질의가 2곳을 반환하는지 확인
- 제공 모니터를 기본 로거에 연결하고 실패 3건 실행
- 파일을 다시 읽은 replay 결과 3건과 실패 판정을 함께 기록
- 이름 포함·count 일치 지표의 분모와 통과 수 비교
- 제공 공개 질의 로거로 한 지점 교체 후 저장 열의 차이 확인
- 아래 완성 리뷰안과 자신의 프로젝트 수신자 조건 대조
□ 실행 후 기록 양식
| 항목 | 기본 실행 | 연결 교체 실행 | 해석 |
|---|---|---|---|
| 연결 함수 | minimal_logger | public_fixture_logger | 제공 정책 선택 |
| 실패 행 수 | 실행 출력 기록 | 실행 출력 기록 | 두 실행 모두 3행 여부 |
| replay 일치 수 | 실행 출력 기록 | 실행 출력 기록 | 세 실패 동일 조건 재현 여부 |
| 공개 작성 질의 열 | 존재 여부 기록 | 존재 여부 기록 | 원문 최소화 차이 |
| source_verified | 실행 출력 기록 | 실행 출력 기록 | 조회 성공과 규칙 실행 분리 |
| CPU 지연 | 각 행 실제 값 기록 | 각 행 실제 값 기록 | 값 동일 강제 금지 |
대면 (1시수)
Section titled “대면 (1시수)”□ Q2 이해관계자: 이 시스템의 결과를 누가 받는가
-
공개 정보 독자: 출처와 확인 시점, 잘못된 수치의 영향, 판단 보류 안내 필요
-
자동 집계 프로그램: count 필드의 존재·자료형·의미 계약 필요
-
운영 담당자: 변경 이력, 실패 ID, 재현 묶음, 되돌릴 조건 필요
-
현장 멘토: 실패가 이용자 업무에 주는 영향과 우선순위, 여러 역할을 한 사람이 맡을 때의 부담 검토
-
같은 출력에 대한 평가 기준 차이를 명시. 사람도 이해하기 어렵다는 이유 없이 프로그램 기준을 모든 수신자에게 일괄 적용하지 않는 방식
-
관찰 질문: F2는 사람에게와 프로그램에게 같은 실패 강도인지, 수신자별 근거를 먼저 정리
- 그림 해석: 이름만 보낸 F2는 프로그램 필드 누락 실패. 사람에게는 공개 사실 확인과 직접 답변 여부를 따로 검토할 조건
□ 제공된 수신자 기준 완성표
| 수신자 | 받는 결과 | 상정 수락 기준 | 보류 조건 | 필요한 기록 |
|---|---|---|---|---|
| 공개 정보 독자 | 자연어 안내 | 근거 확인과 이름·수의 모순 없음 | 사실 미확인·모순·무응답 | 출처 판 번호, 확인 상태, 출력 버전 |
| 자동 집계 프로그램 | count 필드 | 정수 2, 확인된 평가 범위 | 값 없음·3·라벨 없음 | schema 목적, metric 버전, count 판정 |
| 운영 담당자 | 실패 요약 | 이전 조건과 결과 재현 가능 | fixture·config·hash 누락 | ID, 버전, bundle·replay 증거 |
| 현장 검토자 | 영향·조치안 | 사례와 수신자 영향 연결 | 재현 없는 원인 단정 | 실패 3건과 질문·우선순위 |
- 위 기준은 이 작성 과업 범위의 검토안. 실제 기관 승인 기준·서비스 계약 아님
- 안전·자격·권리 판단의 자동 확정에 행정시 예제 기준 재사용 금지
□ 멘토 리뷰에 가져갈 자료
- 노트북의
week14-evidence/bundle.json,failures.jsonl, replay 출력 3행 - 실패 카드: 입력 변화 또는 버전 변화, 관찰 출력, 기대 기준, 수신자 영향, 제시할 질문
- 실제 개인정보·개인 원문·이름·연락처·API 키 제외
- 실제 멘토 리뷰에서는 응답을 받은 열만 채움. 아래 작성 검토안을 실제 멘토 의견으로 보고하지 않는 원칙
| 사례 | 제시 관찰·재현 근거 | 수신자 영향 | 먼저 볼 역할 | 제시 질문 | 작성 조치안 |
|---|---|---|---|---|---|
| F1 | baseline 유지, 입력 표현 이동, unsupported_input, replay 일치 | 이용자 문의에 응답 없음 | 소통·운영 | 보류 안내가 충분한지, 어떤 표현부터 확장할지 | 재문의 안내 후 표현 범위 검토 |
| F2 | prompt-v2, count 누락, 이름 지표 통과, replay 일치 | 자동 집계 입력 계약 위반 | 개발 | 누락 필드를 집계하면 어떤 후속 오류가 생기는지 | prompt-v1 비교·복귀 후 필드 재검증 |
| F3 | rule-v2, 두 이름·3곳, replay 일치 | 사실 오답 전달 | 운영·소통 | 중단과 오답 통지 중 무엇을 먼저 할지 | 해당 버전 자동 출력 보류·영향 안내 |
□ 실제 리뷰 기록 양식
| 실패 ID | 실제 검토 의견 | 조정 우선순위 | 담당 역할 | 다음 검증 근거 | 미확인 조건 |
|---|---|---|---|---|---|
| F1 | 미수신 | 미정 | 미정 | baseline·표현 비교 | 실제 이용자 영향 미측정 |
| F2 | 미수신 | 미정 | 미정 | prompt 버전·필드 비교 | 현장 입력 계약 미확인 |
| F3 | 미수신 | 미정 | 미정 | rule 버전·오답 비교 | 실제 피해 범위 미측정 |
- 멘토와의 1:1 리뷰에서 실패 3건의 현장 기준·우선순위와 멀티롤 피드백 확인
- 수업계획의 활동 안내. 이 자료가 실제 리뷰 일정·발송·승인 완료를 뜻하지 않음
- 한 사람이 여러 역할을 맡을 때의 확인 질문: 코드 수정에 집중하면서 오답 안내를 놓치는지, 공지에 집중하면서 재현 근거를 잃는지
[이론]
- 입력 이동, 프롬프트 갱신, 모델 갱신의 변화 경로와 지표 노후화의 측정 경로 구분
- 예외 없음과 의미 품질 통과, replay 통과와 수신자 수락의 차이 설명
[구현]
- 제공된 로깅·모니터링을 한 지점에 연결, 기본·대안 전체 실행
- 세 실패와 버전 묶음 저장, 제공 replay로 결과 대조
- 새 logger·verifier·재현 알고리즘 구현 요구 없음
[실무]
- 실패 케이스 3건을 수신자 영향과 함께 멘토 리뷰 자료로 정리
- 현장 기준의 우선순위 조정과 개발·운영·소통 역할별 피드백 기록
- 아직 받지 않은 검토 의견은 미수신으로 유지
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. 로그를 많이 남길수록 원인을 빨리 찾는가
- 필요한 버전·실행 묶음 없이 원문만 쌓이면 같은 실패를 재현하지 못하는 상태
- 기록 목적부터 정하고 ID·버전·hash·상태를 연결. 개인정보·비밀 수집량 증가를 디버깅 근거로 정당화하지 않는 원칙
Q2. hash를 저장하면 개인정보 문제도 해결되는가
- hash는 익명화 보장이 아님. 후보가 적은 원문은 후보 대입 가능
- 이번 재현은 공개 작성 fixture registry가 있으므로 가능. 실제 개인 질의를 그 registry에 넣으라는 과제가 아님
Q3. 예외가 없으면 운영 성공인가
- F2와 F3는 코드 예외가 없어도 필드 누락·사실 오류로 실패
- 실행 상태, 출력 계약, 의미 품질을 서로 다른 열로 관찰할 필요
Q4. 재현 검증을 통과하면 그 실패는 해결된 것인가
- 같은 조건에서 같은 실패를 다시 확인한 상태
- 변경 후 비교할 기준이 생긴 것이며 해결 판정은 수정된 결과와 수신자 기준으로 별도 검증
Q5. 현재 정확도를 알 수 없으면 우선 0으로 표시해도 되는가
- 라벨 미수집은 미측정. 정답·오답 수를 만들어 내지 않는 원칙
- 확인된 라벨만 정확도 분모에 넣고 라벨 커버리지 함께 보고
스스로 점검
Section titled “스스로 점검”- F1·F2·F3에서 각각 고정한 조건과 바꾼 조건 설명
- 같은 세 행에서 count 기준 0/3, 이름 포함 기준 2/3이 되는 이유 계산
- 로그 hash만 가지고 원문 질의를 다시 실행할 수 있는지 판단
- 5건 중 라벨 3건, 통과 2건인 설명 예의 정확도와 라벨 커버리지 계산
- F2에 대한 사람과 프로그램의 기준 차이, 멘토에게 제시할 질문 작성
점검 정답과 풀이
- 1: F1은 기준 config를 고정하고 질의 표현만 변경. F2는 기준 질의와 rule-v1 고정, prompt-v2 적용. F3는 기준 질의와 prompt-v1 고정, rule-v2 적용
- 2: F1·F2는 count 없음, F3는 3이므로 count=2 통과 0. F2·F3는 두 이름이 모두 있어 이름 포함 통과 2
- 3: hash만으로 원문 실행 불가. 이번 공개 fixture·코드·config·retrieval registry와 hash 대조 필요
- 4: 정확도 2/3, 라벨 커버리지 3/5. 미확인 2건을 오답으로 추가하지 않는 원칙
- 5: 사람은 두 이름과 출처를 검토할 수 있지만 프로그램은 count 누락으로 집계 불가. “누락값이 downstream 집계에 어떤 영향을 주는가”를 질문으로 제시 가능
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 이번 주 의미 | 혼동하지 않을 대상 |
|---|---|---|
| 입력 분포 이동 | 들어오는 입력 특성 변화 | 모든 실패를 모델 변경으로 설명 |
| 프롬프트 버전 | 출력 지시 조건 식별 | 단순 문장 장식 |
| 모델 버전 | 계산·가중치 등 변경 식별 | 이 규칙 모형을 실제 LM로 해석 |
| 출력 계약 | 수신자가 받는 필드·의미 조건 | 예외 없이 종료 |
| stale metric | 현재 요구와 어긋난 이전 측정 대상 | 입력 변화 자체 |
| 로깅 | 개별 실행 기록 저장 | 모든 원문 수집 |
| 모니터링 | 기록에서 상태·품질 관찰 | 정답 없는 정확도 계산 |
| replay | 고정 묶음으로 같은 실패 재실행 | 실패 해결 |
| hash | 동일 자료 대조용 요약값 | 복원·익명화 보장 |
| 라벨 커버리지 | 정답 확인 건수 / 전체 건수 | 확인된 건의 정확도 |
| 멀티롤 | 개발·운영·소통을 한 사람이 겸하는 조건 | 실제 담당자를 임의 지정 |
- Sculley 외, Hidden Technical Debt in Machine Learning Systems (2015): 학습 시스템의 의존성과 환경 변화에 대한 유지 비용 논의. 이번 세 실패의 측정 출처 아님
- Python time 공식 문서, perf_counter: 경과 시간 측정과 시계 특성
- Python logging 공식 문서: Logger·Handler 구성. 노트북은 구조를 간단히 보이기 위한 제공 함수·JSONL 사용
- 위키백과 제주특별자치도 고정판 42464087: 공개 사실 문맥·저자 목록, CC BY-SA 4.0. 노트북 실행에서 조회 상태 별도 표시
- 출처 검토일: 2026-10-11. 교수 작성 수치 예제·규칙 실험·리뷰안은 위 논문이나 문서의 실측 수치가 아님
실습 노트북
Section titled “실습 노트북”
- 노트북 목록: 14주차 파일과 이전 실습 연결
week-14.ipynb: 표준 라이브러리 CPU 실행, 제공 로거 연결 한 지점, 실패 3건과 replay- 실행 후
week14-evidence/의 두 파일과 재현 출력, 수신자·멘토 표를 최종 발표의 근거로 활용 - 제공
attach_monitor는 이 노트북의FIXTURES,CONFIGS,pipeline을 사용하는 예제 전용 연결 함수. 팀 프로젝트의 수집 함수로 바로 재사용하는 API는 아님 - 실제 프로젝트에 붙일 때 개인정보·원문·비밀 제외 조건과 해당 프로젝트의 출력 계약을 먼저 확인
| 제공 예제의 필드 | 팀 프로젝트에서 대응할 대상 |
|---|---|
fixture_id | 개인정보를 포함하지 않는 재현 사례 ID |
CONFIGS | 모델·검색·평가 설정의 고정 스냅샷 |
pipeline의 입력·출력 | 기존 프로젝트가 받는 입력과 검증할 출력 |
| 실패 로그·replay 결과 | 같은 설정과 입력으로 다시 얻은 결과·차이 |
- 이 표는 프로젝트 연결을 위한 검토 항목. 예제의 TODO는 제공 로거 선택 한 곳으로 유지