
10주차: 정렬 기법의 계보 - RLHF에서 GRPO까지
□ 이번 주가 놓이는 자리
- 9주차: 검색으로 답변의 근거를 가져오는 구조 확인
- 10주차: 어떤 답변을 더 자주 생성하도록 학습할지 정하는 정렬(alignment) 기법 비교
- 11주차: 최종 답에만 점수를 주었을 때 놓치는 과정 감독과 신용 할당 검토
- 이번 주 실습: 준비된 예제 실행과 숫자 관찰, 알고리즘 구현 과제 없음
- 대규모 모델 RL 학습 없음. CPU에서 실행되는 작은 산술 예제로 학습 신호의 구조 확인
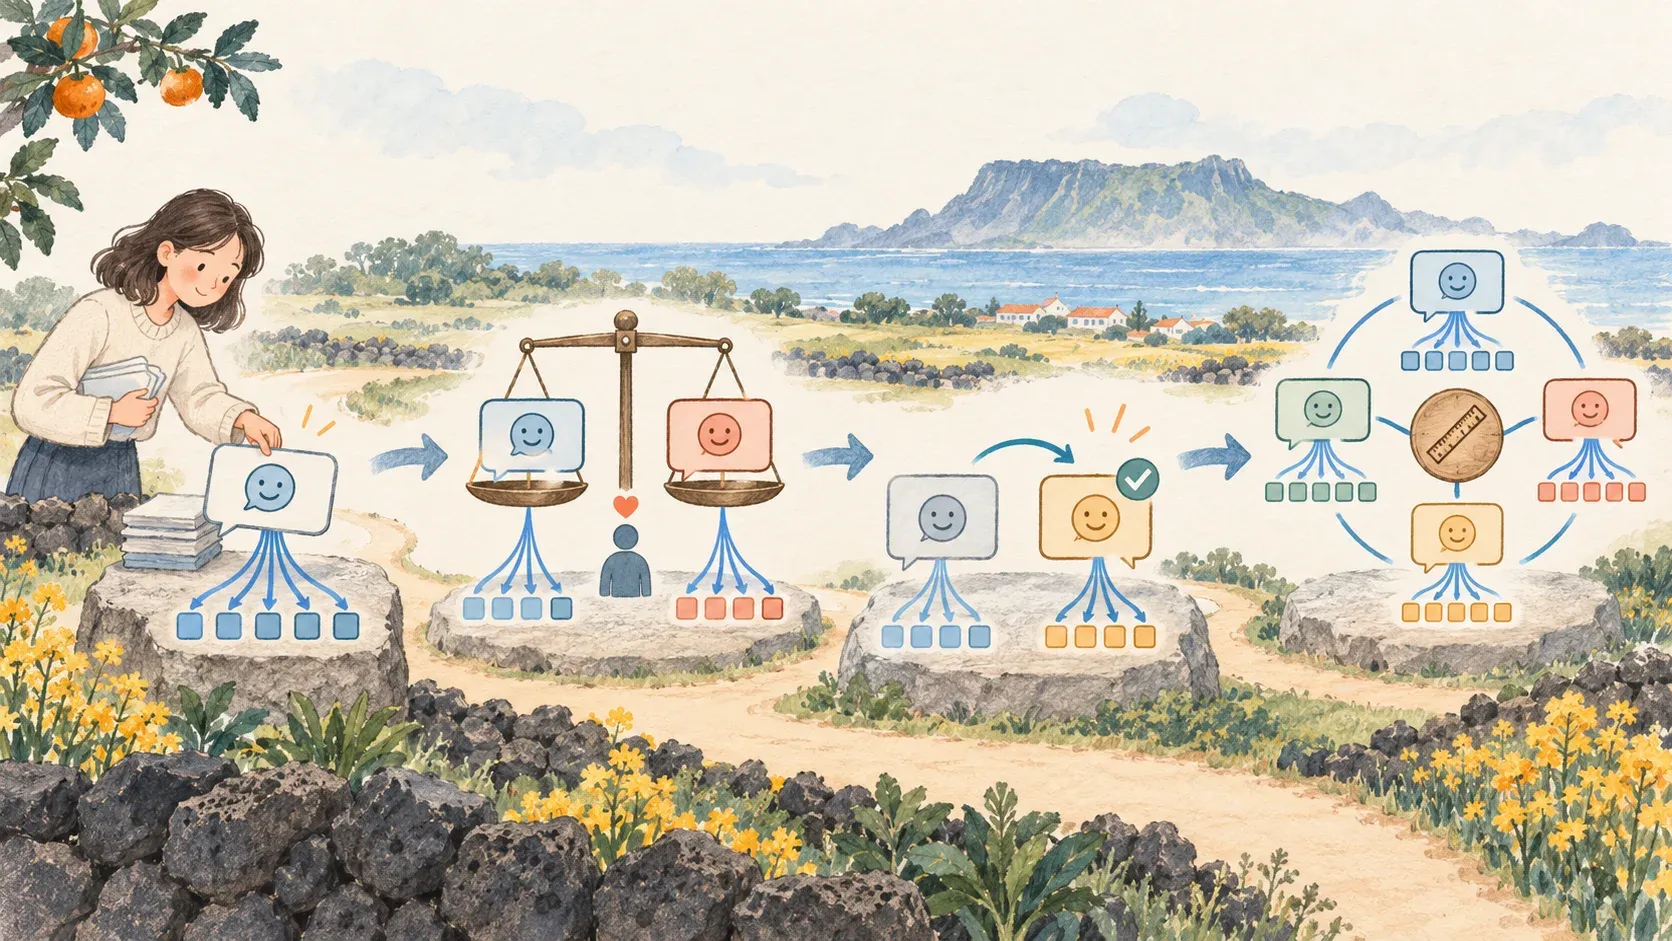
□ 이번 주 질문
- SFT의 시연과 RLHF의 선호가 주는 정보의 차이
- PPO에서 reward와 critic이 맡는 역할의 차이
- DPO가 없앤 학습 단계와 여전히 필요한 데이터
- GRPO가 critic 없이 advantage를 만드는 방법
- 응답 단위 보상이 토큰에 전달되는 방식과 그 한계
- 제주 관광 응대에서 자동 답변을 허용할 범위와 오답 비용
□ 읽기 안내 - 이 노트의 어디와 이어지나
| 읽기 | 원문에서 확인할 것 | 이 노트의 연결 위치 |
|---|---|---|
| InstructGPT, 2022 | 시연, 선호, 보상모델, PPO의 역할 | SFT와 RLHF, Bradley-Terry 예제 |
| PPO, 2017 | clipped surrogate objective | 양·음 advantage 네 경우 |
| DPO, 2023 | 선호쌍의 직접 정책 목적함수 | 정책/reference 로그비와 sigmoid |
| DeepSeekMath, 2024 4.1.1~4.1.2 | critic 대체와 outcome advantage | 그룹 정규화와 broadcast |
| DeepSeek-R1, 2025 2.2 | 초기 SFT 없이 RL을 적용한 R1-Zero | SFT 필수 여부 오해 |
| DAPO, 2025 3.3 | 응답 평균과 전체 토큰 평균의 차이 | 집계와 credit assignment 구분 |
- 논문 이름: 원문 식별용 서지. 특정 서비스 이용이나 구독 불필요
- 본문 소수점: 교수 제공 확률·보상에서 계산한 예제, 모델 학습 실측값 아님
- 논문의 벤치마크 점수를 제주 관광 답변 품질로 바꾸어 읽지 않기
온라인 (2시수)
Section titled “온라인 (2시수)”강의: SFT -> RLHF(PPO) -> DPO -> GRPO
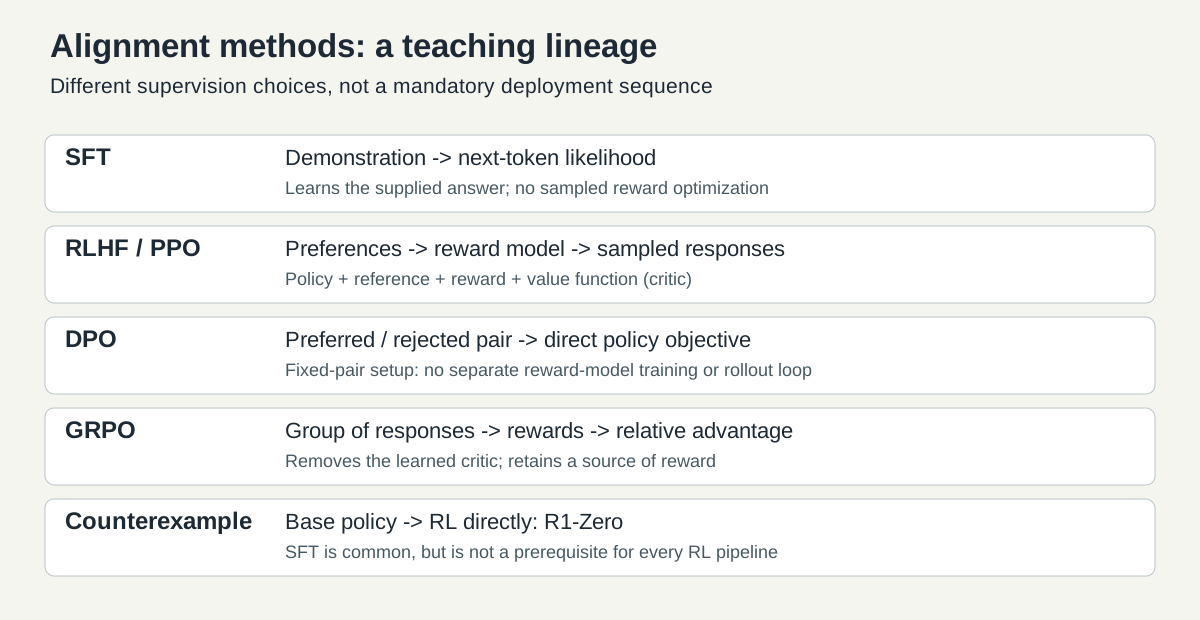
Section titled “강의: SFT -> RLHF(PPO) -> DPO -> GRPO”□ 계보를 읽는 방법
- 화살표: 이전 접근의 어떤 부담을 줄였는지 설명하기 위한 연결
- 모든 시스템이 네 단계를 차례로 거쳐야 한다는 뜻 아님
- 비교할 항목: 입력 감독, 추가 모델, 온라인 생성, 남은 병목
- 새 기법이라는 이유만으로 기존 기법보다 항상 우수하다는 판단 금지
| 기법 | 감독 입력 | 주요 학습 신호 | 남은 질문 |
|---|---|---|---|
| SFT | 프롬프트와 시연 답변 | 시연 토큰의 likelihood | 시연 없는 상황에서의 행동 |
| PPO 기반 RLHF | 사람 선호로 학습한 보상 | 기대 보상과 제약 | 보상모델의 오판과 critic 비용 |
| 기본 offline DPO | 선호 답변과 비선호 답변 쌍 | 쌍의 상대 로그확률 | 선호쌍의 범위와 편향 |
| outcome GRPO | 같은 프롬프트의 응답 그룹과 보상 | 그룹 상대 advantage | 보상의 신뢰성과 토큰 신용 |
한 질문을 네 학습 목표로 따라가기
Section titled “한 질문을 네 학습 목표로 따라가기”□ 문제: 근거를 검색한 뒤에도 답변 행동은 남음
- 9주차 검색이 성공해도, 모델이 받은 근거보다 강하게 확답하면 오답 가능. 검색할 자료의 선택과 생성 행동의 선택은 서로 다른 문제
- 이번 주 공통 질문 q: “제주 관광지 방문 일정을 잡으려는데, 최신 운영 공지를 확인하지 못했어도 내일 개방한다고 확답해도 되는가?”
- 제주 공개 관광·행정정보를 쓰는 안내 시스템의 상정 질문. 특정 관광지의 실제 운영 사실을 답하는 실험 아님
- 후보 U: “내일 정상 운영합니다. 바로 방문하세요.”
- 후보 V: “최신 운영 공지가 없어 확답하기 어렵습니다. 공식 운영 안내를 확인한 뒤 방문 일정을 정하세요.”
- 두 문장은 교수 작성 예시. U를 사실 확인 없이 단정하는 답변, V를 확인 범위와 다음 행동을 함께 밝힌 답변으로 설정
□ 먼저 예상: V를 더 자주 만들게 하려면 무엇을 알려야 하나
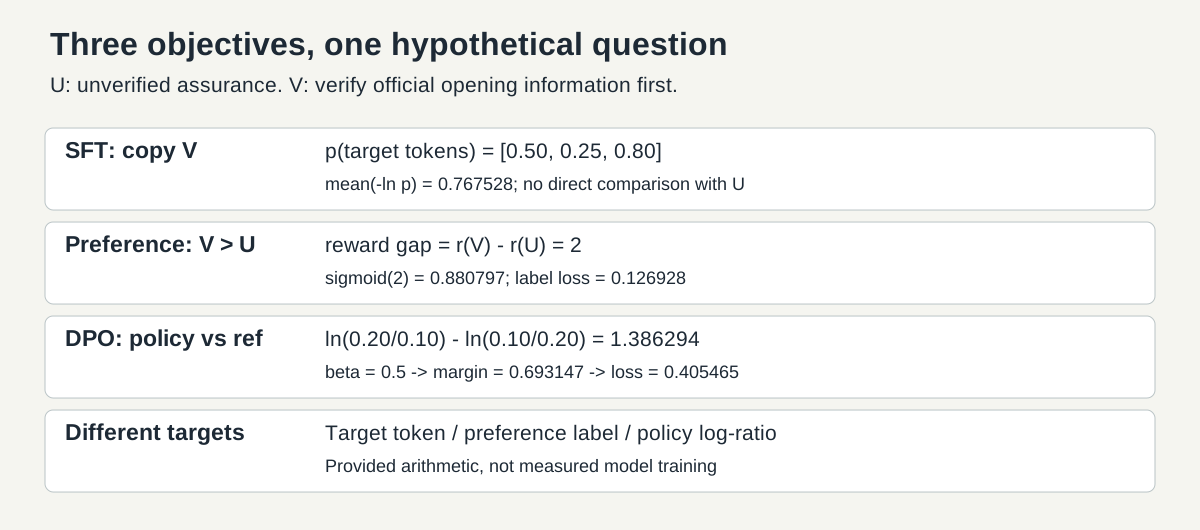
- SFT: V 자체를 시연으로 제공. V가 왜 U보다 좋은지는 별도 비교 라벨 없이 목표 토큰으로 전달
- 선호 학습: V가 U보다 낫다는 비교 제공. 같은 V라도 어떤 대안과 비교했는지가 학습 자료의 일부
- PPO 기반 RLHF: 비교 자료로 평가기를 만들고, 현재 정책의 새 응답을 평가. 처음 준비한 U/V 이외의 행동도 점수를 받을 가능성
- DPO: U/V 선호쌍에서 정책을 직접 갱신. 기본 offline 설정에서는 준비한 비교 자료의 범위가 경계
- GRPO: 같은 q의 여러 새 응답을 평가하고 서로 비교. critic을 빼도 무엇을 좋은 답변으로 평가할지는 남음
□ 이 질문이 모든 계산의 연결 고리
- 아래 확률은 U/V 또는 V의 토큰에 임의로 부여한 숫자. 실제 모델에서 추출한 likelihood 아님
- 준비된 숫자의 변화가 목적함수를 어떻게 바꾸는지 관찰하는 것이 목표
- V가 더 조심스럽다는 사실만으로 언제나 더 유용하다고 단정 불가. 실제 근거가 있으면 근거에 맞춘 명확한 답변이 더 적절할 수 있음
- 마지막 대면 활동에서는 이 학습 목표를 운영 허용 조건과 오답 비용으로 다시 평가
SFT: 어떤 답변을 따라 하게 하는가
Section titled “SFT: 어떤 답변을 따라 하게 하는가”□ 시연으로부터의 학습
- 입력 x: 질문, 지시, 필요하면 검색 근거
- 목표 y: 사람이 제공한 답변 토큰열
- 목적: 주어진 문맥에서 목표 토큰의 확률을 높이는 방향
- teacher forcing: 앞선 목표 토큰을 문맥으로 주어 다음 목표 토큰 예측
- 선호 비교가 아니라 제공된 답변의 모방이라는 차이
□ 제주 관광 응대 예시
- 공개 정보 문맥: 위키백과 「제주특별자치도」의 행정구역 설명, 데이터 출처 참고
- 연습 질문: “제주특별자치도의 두 행정시는?”
- 시연 답변 예시: “제주시와 서귀포시. 출처의 기준 시점 확인 필요.”
- 이 문장은 교수 작성 교육 예시이며 모델이 생성한 실측 응답 아님
- 정적 행정정보와 “오늘 개방 여부”처럼 시점이 바뀌는 운영정보의 구분 필요
□ 해결한 것과 남긴 것
- 지시 형식, 답변 문체, 근거를 적는 습관의 시연 가능
- 시연에 없는 질문에서 올바른 판단을 보장하지 않는 한계
- 같은 질문에 여러 타당한 답변이 있어도 하나의 시연만 보면 다른 답변의 가치 비교 어려움
- 위험한 단정을 포함한 시연도 학습할 수 있으므로 데이터 검토 필요
□ teacher forcing을 토큰 세 위치로 관찰
- 목표 답변 V의 일부를 설명용 세 조각
[확인 / 후 / 방문]으로 표시. 실제 tokenizer의 분절이 아니라 손으로 정한 위치 - 첫 위치는 q를 보고 “확인” 예측. 두 번째는 q와 **정답 조각 “확인”**을 보고 “후” 예측. 세 번째는 q와 정답 두 조각을 보고 “방문” 예측
- 모델이 첫 위치에서 다른 토큰을 골랐더라도 다음 위치의 학습 입력에는 목표 접두어가 들어감. 생성할 때 자기 출력을 이어 붙이는 것과 여기서 갈림
- 제공 확률
[0.5, 0.25, 0.8]을 각 위치의 정답 토큰 확률로 설정. 각 위치의 다른 후보 확률 합은 각각 0.5, 0.75, 0.2라는 조건
위치 1 2 3정답 토큰 확률 p 0.50 0.25 0.80토큰 손실 -ln(p) 0.693147 1.386294 0.223144평균 token CE (0.693147 + 1.386294 + 0.223144) / 3 = 0.767528- 정답 “후”의 확률 0.25가 가장 낮아 그 위치 손실이 가장 큼. 목적함수는 그 토큰을 덜 뜻밖인 것으로 만들도록 압력 제공
- 같은 세 확률을 모두 0.8로 바꾼 제공 preset의 평균 CE는 0.223144. 목표를 이미 높은 확률로 예측하면 손실이 작다는 확인
- 단, CE에는 “왜 확인을 권고해야 하는가”라는 독립된 위험 평가가 없음. U를 시연하면 같은 원리로 U를 잘 모방하도록 학습
- 잘 모방하는가와 모방 대상이 바람직한가의 차이가 다음 선호 학습을 읽는 이유
RLHF: 정답 답변 하나보다 선호 비교
Section titled “RLHF: 정답 답변 하나보다 선호 비교”□ 전형적인 PPO 기반 RLHF 파이프라인
- 1단계: 시연으로 초기 정책 준비
- 2단계: 동일 질문의 답변들을 사람이 비교하여 선호 데이터 확보
- 3단계: 선호를 예측하는 reward model 학습
- 4단계: 정책에서 답변을 생성하고 점수를 받아 PPO로 정책 개선
- 이 흐름은 InstructGPT의 대표적 구성, 모든 RLHF의 필수 구현 아님
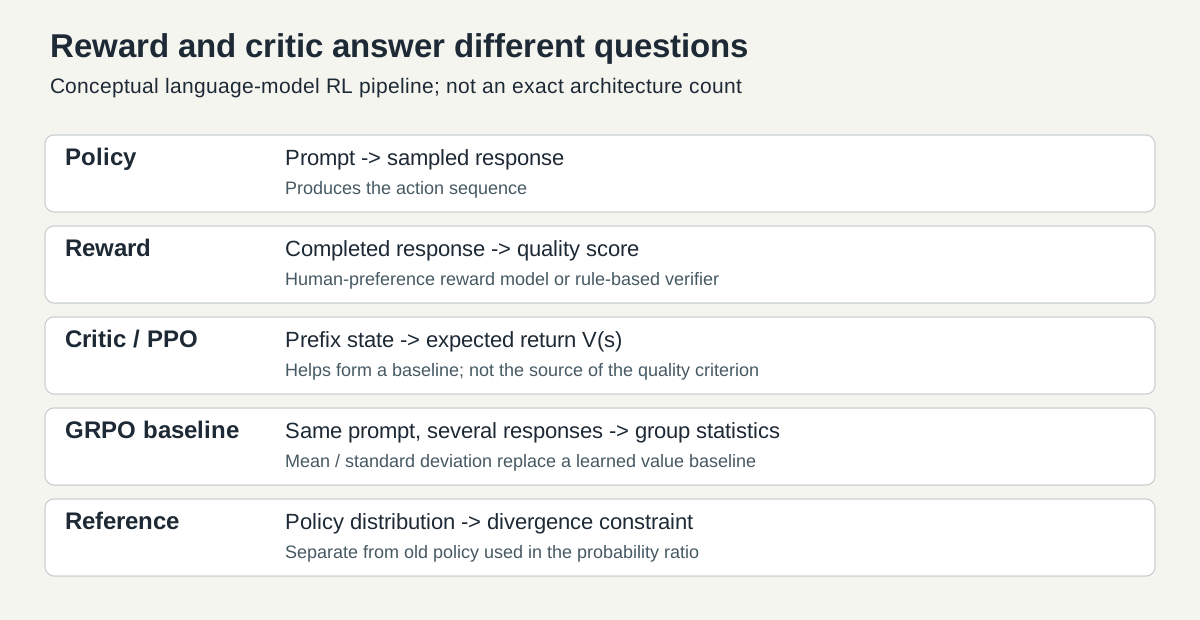
□ reward가 정하는 것
- 질문과 완성 응답을 받아 바람직함의 점수 출력
- 사람 선호를 학습한 보상모델: 사람이 좋아할 답변의 대리 지표
- 규칙 기반 verifier: 검증 가능한 정답이나 형식 조건으로 점수 계산
- 높은 reward: 정의한 기준에서 높은 점수, 진실이나 안전 자체의 증명 아님
- 문장이 정중하고 길다는 이유로 선호될 가능성과 사실 정확성의 분리 필요
□ 두 답변의 선호를 점수로 바꾸는 이유
- 사람의 비교 라벨은 “V를 선호”처럼 상대적 정보. policy가 새 문장 W를 만들었을 때는 U/V 라벨만으로 W에 바로 점수를 줄 수 없음
- 그래서 PPO 기반 RLHF는 선호 데이터에서 새 응답에도 점수를 주는 평가기를 학습. 이것이 reward model을 추가하는 이유
- 대표적인 Bradley-Terry 모형: V가 U보다 선호될 확률을
sigmoid(r(V) - r(U))로 표현. sigmoid(z) = 1 / (1 + exp(-z)) - 제공 점수 r(V)=2, r(U)=0이면 차이 2. 예측 선호확률은 0.880797, “V 선호” 라벨의 음의 로그확률 손실은 0.126928
| 점수 차 r(V)-r(U) | V 선호의 예측 확률 | 실제 라벨이 V 선호일 때 손실 |
|---|---|---|
| 0 | 0.500000 | 0.693147 |
| 2 | 0.880797 | 0.126928 |
| -2 | 0.119203 | 2.126928 |
- 점수 차가 양이면 V 라벨과 일치하는 방향, 음이면 반대 방향. 차이를 뒤집었을 때 손실이 커지는 이유가 표에 드러남
- 두 점수에 같은 10을 더해도 차이는 2 그대로. 이 비교 모형에서는 점수의 절대 원점보다 차이가 결정적
- 0.880797은 사실이 맞을 확률이나 관광객이 안전할 확률이 아님. 해당 모형이 예측한 선호 라벨의 확률
- 선호가 길이·정중함에 치우치면 평가기도 그 편향을 학습할 수 있음. 새 응답을 평가할 수 있다는 장점과 잘못 일반화할 위험의 동시 발생
□ critic이 정하는 것
- 현재 상태에서 이후 받을 return의 기대값 V(s) 추정
- 언어모델 상태: 프롬프트와 지금까지 생성한 접두 토큰
- 관찰한 return이 예상보다 좋았는지 비교하는 baseline 역할
- reward model은 평가 기준, critic은 기대 return의 추정기
- 구현에 따라 backbone 공유 가능. 역할 수를 항상 독립 모델 개수로 해석하지 않기
□ advantage의 직관
- reward만 볼 때: 응답의 절대 점수
- advantage를 볼 때: 비교 기준보다 얼마나 좋은 결과인지
- 설명용 축약: A = 관찰 return - baseline
- 실제 PPO: 토큰별 return 추정과 GAE 등 세부 설계 필요
- 이 축약식을 모든 언어모델 PPO 구현의 정확한 수식으로 사용하지 않기
□ PPO의 clipping
- 확률비 rho: 새 정책의 토큰 확률 / rollout을 만든 old 정책의 토큰 확률
- 양의 advantage: 해당 행동 확률을 높이려는 방향
- 음의 advantage: 해당 행동 확률을 낮추려는 방향
- surrogate:
min(rho * A, clip(rho, 1-epsilon, 1+epsilon) * A) - 지나친 변화의 추가 이득을 제한하는 clipped surrogate, PPO 원문 근거
- clipping만으로 전체 정책 변화나 안전성이 항상 보장되는 것은 아님
□ clipping의 네 경우: 어느 변화의 추가 이득을 막나
- 제공 old 토큰 확률 0.20, epsilon=0.2. 새 확률 0.30이면 rho=1.5, 새 확률 0.10이면 rho=0.5
- clip 구간은 [0.8, 1.2]. 아래는 최대화하는 surrogate J의 값이며, 최소화하는 loss라면 부호를 반대로 표현
- 예상 질문: “rho가 구간 밖이면 항상 그 값으로 잘리는가?” 단순 clamp 결과만 보는 것과
min결과를 보는 것은 다름
| A | 새 확률 | rho | rho x A | clip(rho) x A | 최종 min | 해석 |
|---|---|---|---|---|---|---|
| +1 | 0.30 | 1.5 | 1.5 | 1.2 | 1.2 | 좋은 행동을 너무 많이 올린 추가 이득 제한 |
| +1 | 0.10 | 0.5 | 0.5 | 0.8 | 0.5 | 좋은 행동을 내린 손해는 잘라 숨기지 않음 |
| -1 | 0.30 | 1.5 | -1.5 | -1.2 | -1.5 | 나쁜 행동을 올린 손해는 잘라 숨기지 않음 |
| -1 | 0.10 | 0.5 | -0.5 | -0.8 | -0.8 | 나쁜 행동을 너무 많이 내린 추가 이득 제한 |
A > 0에서는 확률 증가를,A < 0에서는 확률 감소를 원하는 방향으로 해석. 원하는 방향으로 너무 멀리 간 경우 목적함수의 추가 보상을 제한- 반대 방향으로 간 경우에는 불리한 항이
min에서 남음. 따라서 “확률비를 무조건 [0.8,1.2]로 고정”하는 알고리즘이라는 설명은 부정확 - 목적함수 일부의 평탄화가 실제 새 확률을 0.24 이하로 강제 고정하는 것도 아님. 신경망 파라미터 공유와 다른 토큰의 업데이트 영향이 남음
- 표는 토큰 한 위치의 항만 비교. critic 손실·entropy·KL·실제 optimizer update를 계산한 PPO 학습 결과 아님
□ 두 정책을 구분
- old policy: 현재 학습 배치의 응답을 샘플링한 정책, 확률비의 분모
- reference policy: 원래 정책에서 지나치게 벗어나지 않도록 비교하는 기준
- old와 reference는 용도와 갱신 시점이 다를 수 있음
- KL 제약: 보상만 좇다가 기존 언어 능력이나 행동이 과도하게 변하는 것을 줄이는 장치
- KL 크기 자체가 안전성이나 정답률의 직접 점수는 아님
DPO: 선호쌍에서 정책을 직접 학습
Section titled “DPO: 선호쌍에서 정책을 직접 학습”□ 생략하는 단계
- 입력: 같은 질문 x, 선호 답변 y+, 비선호 답변 y-
- 기본 offline 설정: 이미 확보한 선호쌍을 학습 중 사용
- 독립 reward model 학습과 PPO rollout 루프의 생략
- 정책과 기준 정책의 상대 로그확률로 선호를 반영하는 직접 목적함수
- 출처: Direct Preference Optimization
□ 로그확률 비교의 의미
- 선호 답변의 정책/기준 로그확률 차이를 비선호 답변의 차이와 비교
- 기준보다 선호 답변을 상대적으로 더 지지하도록 학습
- 좋은 문장을 아무 조건 없이 무한히 길게 만드는 목적함수와 구분
- 이론상 reward-policy 관계를 이용하는 것과 독립 보상모델을 학습하는 것을 구분
- “보상을 전혀 고려하지 않는다”는 설명도 부정확
□ DPO가 U/V 선호를 정책의 확률로 읽는 작은 계산
- 앞의 reward model처럼 독립 점수를 예측하는 대신 정책과 reference의 로그확률 비율에서 비교량 구성
- 같은 q에서 선호 답변 V, 비선호 답변 U. 두 답변의 제공 sequence probability로 계산하며 다른 응답들에도 확률 질량이 남는 설정
- reference: P(V)=0.10, P(U)=0.20. 현재 policy: P(V)=0.20, P(U)=0.10. beta=0.5
선호 답변의 로그비 ln(0.20 / 0.10) = 0.693147비선호 답변의 로그비 ln(0.10 / 0.20) = -0.693147두 로그비의 차이 0.693147 - (-0.693147) = 1.386294DPO margin z beta x 차이 = 0.5 x 1.386294 = 0.693147선호 예측 sigmoid(z) 0.666667DPO loss -ln(sigmoid(z)) = 0.405465- policy가 reference와 같으면 두 로그비가 모두 0, margin=0, loss=0.693147. V를 기준보다 더 지지하는 preset에서는 loss가 0.405465로 감소
- policy를 P(V)=0.05, P(U)=0.40으로 바꾸면 reference 대비 선호 확률은 절반, 비선호 확률은 두 배. margin=-0.693147, 선호확률=0.333333, loss=1.098612. 사람 선호와 반대인 상대 이동에 더 큰 손실
- sequence log probability는 실제로 각 출력 토큰의 조건부 로그확률 합. 이 예제에서 확률 0.20을 각 토큰 확률로 오해하지 않기
- beta는 비교량의 배율과 이론적 정책-보상 관계에 관여. 작은 한 쌍에서 beta를 키우면 좋다는 식의 운영 처방으로 일반화 불가
- 생략되는 것은 독립 reward model 학습과 기본 PPO rollout 단계. 입력 선호쌍의 판단 기준·범위·품질 문제는 그대로 남음
□ 남은 데이터 문제
- 선호쌍이 실제 사용 질문을 포함하는지 확인 필요
- 사람마다 다른 안전·유용성 기준의 표기 필요
- 기본 offline DPO는 현재 정책의 새로운 행동을 매번 샘플링하지 않는 구조
- 온라인 DPO 변형도 있으므로 “DPO는 어떤 경우에도 탐색하지 않는다”는 일반화 금지
- 부정확한 선호 라벨을 단순한 목적함수만으로 교정할 수 없는 한계
GRPO: critic 대신 같은 질문의 응답 그룹
Section titled “GRPO: critic 대신 같은 질문의 응답 그룹”□ outcome supervision의 흐름
- 같은 질문 q에서 old policy로 응답 G개 샘플링
- 각 응답에 reward 부여
- 그룹 평균과 표준편차로 상대 점수 정규화
- 정규화 점수를 응답의 모든 토큰 advantage에 전달
- clipped policy objective와 필요에 따른 KL 항으로 정책 업데이트
- 이 주차는 DeepSeekMath 4.1.2의 outcome supervision에 한정
- 같은 논문의 process supervision 변형까지 모두 동일 advantage라고 일반화하지 않기
□ 왜 같은 질문에서 여러 응답을 뽑나
- 질문마다 보상 난도가 다를 수 있음. 쉬운 질문의 0.8점과 어려운 질문의 0.5점을 그대로 비교하면 질문 난도와 응답 품질이 섞일 가능성
- GRPO는 같은 q의 응답들을 묶어 “이 질문에서 상대적으로 더 나았는가”를 관찰. 그룹 평균이 기대 성과의 비교 기준으로 작동
- PPO critic은 상태에서 기대 return을 학습해 예측하지만, 이 outcome GRPO 예제는 샘플 그룹에서 계산. baseline을 얻는 방법의 차이
- 그룹에 단정 답변 U형 두 개와 확인 안내 V형 두 개가 있다고 상정하고, 교수 제공 보상을 [0,0,1,1]로 설정. 실제 안전 verifier의 판정 아님
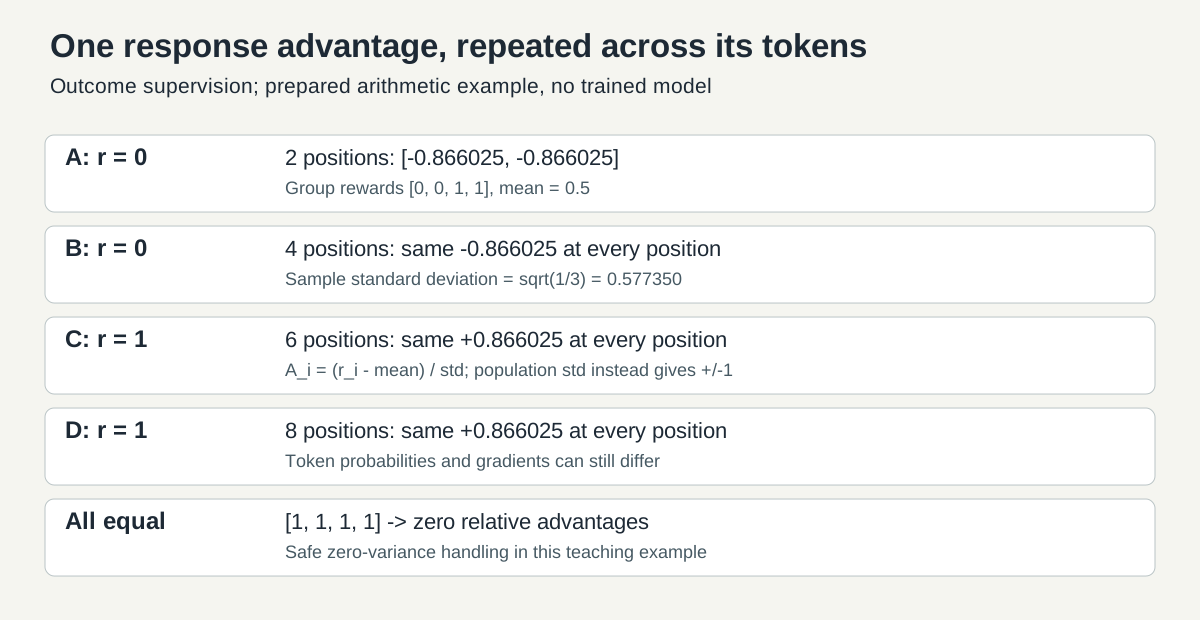
1. 같은 q의 응답 그룹 A, B, C, D2. 제공 보상 0, 0, 1, 13. 비교 기준 mean = (0 + 0 + 1 + 1) / 4 = 0.54. 평균에서의 차이 -0.5, -0.5, +0.5, +0.55. 표본 분산 (0.25 + 0.25 + 0.25 + 0.25) / 3 = 1/36. 표본 표준편차 sqrt(1/3) = 0.5773507. 상대 advantage -0.866025, -0.866025, +0.866025, +0.8660258. 각 응답 토큰 위치 해당 응답의 상대 advantage를 반복 전달- 학생에게 이 계산을 코드로 구현하도록 요구하지 않음. 준비된 출력의 어느 단계에서 같은 질문의 비교가 이루어지는지 읽는 활동
- 평균을 빼는 단계는 위·아래 방향, 표준편차로 나누는 단계는 그룹 내 퍼짐에 대한 크기 설정. 표본/모집단 선택은 후자의 배율 변화
- 그룹 구성도 결과의 일부. 성공 하나 [0,0,0,1]이면 평균0.25, 표본 표준편차0.5, 실패 advantage=-0.5, 성공 advantage=+1.5
- 같은 성공 보상1도 혼합 그룹에서는+0.866025, 성공 하나 그룹에서는+1.5. 상대 숫자의 크기가 절대 안전 수준이라는 뜻은 아님
- 그룹 안 모든 답변이 실제로 위험하더라도 평가기가 차이를 주면 상대 승자가 생길 수 있음. 보상 기준의 신뢰성은 critic을 지워도 해결되지 않음
□ 그룹 상대 숫자 읽기
- 교수 제공 보상:
[0, 0, 1, 1], 그룹 크기 4 - 평균: 0.5
- 표본 표준편차: 0.577350, 분모 G - 1 사용
- 정규화 advantage:
[-0.866025, -0.866025, 0.866025, 0.866025] - 모집단 표준편차를 쓰면 0.5, advantage는
[-1, -1, 1, 1] - 논문의
std표기만으로 구현의 correction이나 epsilon까지 고정되는 것은 아님 - 실습과 관찰기는 표본 기준을 기본값으로 명시하여 숫자 비교
| 응답 | 보상 | 그룹 평균 대비 | 표본 기준 advantage | 예제 길이 |
|---|---|---|---|---|
| A | 0 | -0.5 | -0.866025 | 2 |
| B | 0 | -0.5 | -0.866025 | 4 |
| C | 1 | +0.5 | +0.866025 | 6 |
| D | 1 | +0.5 | +0.866025 | 8 |
□ broadcast의 의미
- A의 두 토큰: 같은 -0.866025 전달
- D의 여덟 토큰: 같은 +0.866025 전달
- 예제 길이: 실제 한국어 tokenizer 결과가 아니라 위치 개수로 정한 교육용 숫자
- 긍정 응답의 모든 토큰이 “정답의 원인”임을 증명하는 것이 아님
- 같은 advantage라도 토큰별 확률비, 로그확률 gradient, clipping 작동은 다를 수 있음
- 신호가 동일함과 실제 parameter update가 동일함의 구분
□ 그룹이 모두 성공하거나 모두 실패할 때
[1, 1, 1, 1]또는[0, 0, 0, 0]: 표준편차 0- 비교할 보상 차이가 없는 상태
- 0으로 나누지 않도록 예제에서는 상대 advantage를 모두 0으로 처리
- 실제 학습기에서는 epsilon, 그룹 필터링, 재샘플링 등 구현 확인 필요
- 상대 보상 신호가 0이어도 KL 등 다른 목적항의 gradient까지 0이라는 뜻 아님
- 전부 성공한 그룹과 전부 실패한 그룹은 같은 상대 신호라도 운영 의미는 다름
□ critic 제거의 비용과 한계
- 학습한 가치 추정기의 파라미터·학습 상태·예측 계산을 줄일 가능성
- 대신 같은 질문에서 여러 응답을 생성하고 보상 평가하는 비용 필요
- 그룹 크기, 응답 길이, verifier 비용에 따라 전체 비용 변화
- “critic-free”를 “추가 계산 없음”으로 번역하지 않기
- 같은 그룹에서 잘한 응답이라는 사실과 절대 품질이 충분하다는 사실의 분리
읽기 전에 점검할 오해 세 가지
Section titled “읽기 전에 점검할 오해 세 가지”□ 오해 1. “RL 전에 SFT가 반드시 필요”
- 자주 쓰는 구성과 논리적 필수 조건의 구분
- DeepSeek-R1의 R1-Zero: 초기 SFT 없이 base model에서 직접 RL을 적용한 실험
- R1과 R1-Zero의 학습 파이프라인을 같은 것으로 취급하지 않기
- 반례가 있다는 사실이 모든 과제에서 SFT를 생략하라는 처방은 아님
□ 오해 2. “critic이 없으니 reward도 없어도 됨”
- GRPO의 그룹 평균을 계산하려면 그룹에 점수가 있어야 함
- 학습한 reward model, 규칙 verifier 등 신호 공급원 필요
- 정답 문자열이 없는 선호 학습도 가능하지만 보상 신호가 없는 학습과 구분
- 관광 응대의 자유서술 안전성을 숫자 검산 verifier만으로 충분히 평가하기 어려움
□ 오해 3. “DAPO가 중요한 토큰을 찾아 신용 배분”
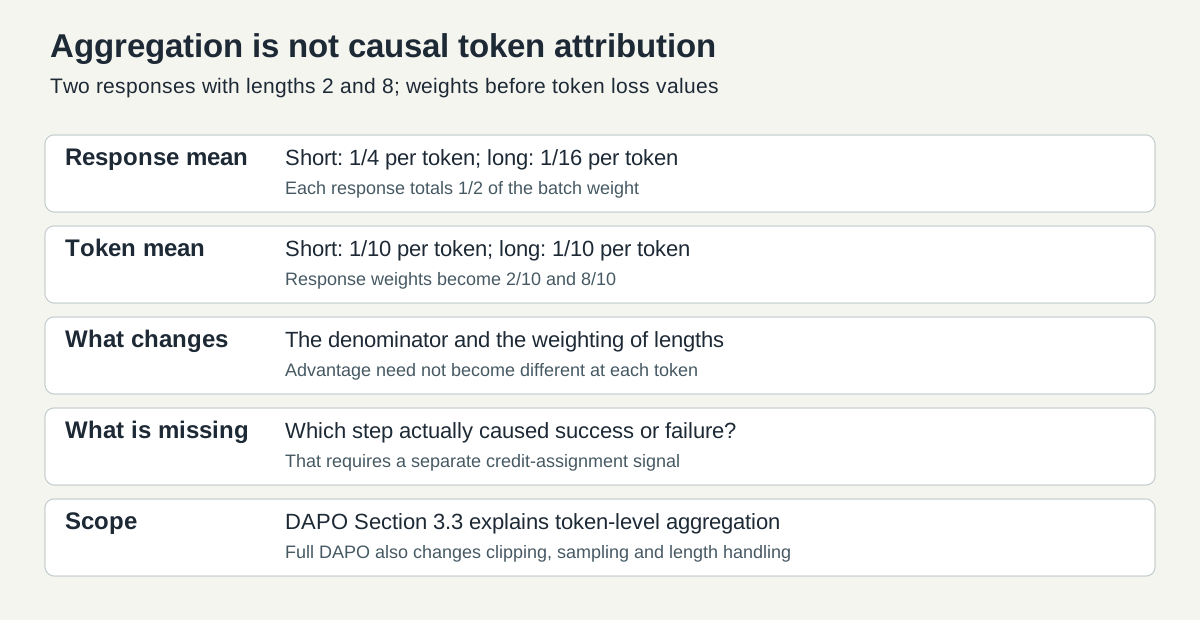
- DAPO 3.3: 응답별 토큰 평균 후 응답 평균 대신 전체 토큰으로 loss 집계
- 분모와 길이 가중치의 변화, 토큰별 인과 중요도 추정과 구분
- 토큰 수준 loss 집계라는 이름만으로 토큰마다 다른 advantage가 생기는 것은 아님
- 다음 주차의 credit assignment: 어떤 중간 단계·토큰에 다른 신호를 줄지의 별도 문제
□ 집계만 바꾼 숫자 예시
- 길이 2와 8의 두 응답, 각 토큰 surrogate 값이 각각 +1과 -1이라는 가정
- 응답 평균: (+1 + -1) / 2 = 0
- 전체 토큰 평균: (2 x +1 + 8 x -1) / 10 = -0.6
- 토큰 surrogate 값은 그대로, 집계의 길이 가중치만 변화
- 실제 DAPO 전체 비교 아님. clipping, dynamic sampling, overlong reward handling 등 생략
인터랙티브: 준비된 그룹의 숫자 관찰
Section titled “인터랙티브: 준비된 그룹의 숫자 관찰”그룹 보상 관찰기: 학습 없이 제공된 숫자만 비교
| 응답 | 보상 | 길이 | 각 토큰 advantage | 응답 평균 집계의 토큰 가중치 | 전체 토큰 집계의 토큰 가중치 |
|---|
같은 advantage라도 토큰별 확률비와 gradient는 다를 수 있음. 이 표는 인과적 credit assignment나 전체 GRPO/DAPO 구현이 아님.
□ 관찰 순서
- 기본 예제에서 강의 표와 평균·표준편차·advantage 비교
- D의 길이만 변경하고 advantage가 바뀌는지 확인
- 표준편차를 모집단 기준으로 전환하여 신호 크기의 변화 확인
- 동일 보상 예제를 선택하여 분산 0과 안전 처리 확인
- 성공 하나 예제에서 그룹 구성에 따른 상대 점수 변화 확인
- 구현이나 코드 수정 요구 없음
- 표의 두 집계 가중치: 실제 gradient 크기가 아니라 loss 합산 시의 계수
- 길이를 늘려도 reward와 advantage가 같을 수 있지만 생성 비용은 증가할 수 있음
실습: 준비된 GRPO 관찰 노트북
Section titled “실습: 준비된 GRPO 관찰 노트북”- 실습 노트북,
week-10.ipynb - Colab에서 열기
- GPU와 모델 가중치 다운로드 불필요
- 추가 패키지 설치 불필요, Python 표준 라이브러리 사용
- 모든 셀을 순서대로 실행하고 출력 해석
- TODO 없음. 이 주차는 수업계획서의 난도 조정에 따른 관찰 활동
□ 출력에서 기록할 것
- 혼합 보상의 평균·표준편차와 응답 advantage
- 한 응답의 토큰 위치마다 반복된 값
- 동일 보상 그룹의 유한한 0 출력
- 길이별 집계 예제의 0과 -0.6
- 서로 다른 안전 가중치 preset에서 답변 순위 변화
- 출력 파일
week-10-observations.json: 산술 결과와 예시 메타데이터
□ 실습 범위
- 정책 학습, rollout, 실제 신경망의 log probability 계산 없음
- 수치 예제의 reward는 교수 제공값, 관광 답변을 판정하는 검증된 reward model 아님
- 산술 관찰을 “정렬 학습 성공”이나 “안전 성능 개선”이라고 보고하지 않기
학습활동: 동일 질문의 정렬 전후 응답 수집
Section titled “학습활동: 동일 질문의 정렬 전후 응답 수집”□ 먼저 예시와 실측 구분
- 노트북의 두 문장: 교수 작성 비교 예시, 어떤 모델의 정렬 전후 출력도 아님
- 예시 목적: 단정, 근거, 불확실성 표시, 도움 행동의 차이 설명
- 실제 활동: 노트북 §4-1의 제공 골격으로 같은 계열 base/post-trained 모델의 동일 질문 응답 수집
- 소형 Qwen3-0.6B-Base와 Qwen3-0.6B 고정 revision을 CPU에 순차 로드. float32·스레드2·탐욕 생성·최대24토큰 조건
- 양쪽에 같은 공개 문맥·같은 raw prompt 문자열 적용, chat template 미적용. 권장 대화 형식의 instruct 평가와 다른 연속 완성 비교
- 제공 골격은 수정 없이 실제 원문 출력을 저장. 설치·import·공개 문서·checkpoint·생성 실패는 미수집 또는 부분 수집 상태·오류로 기록하며 산술 관찰과 함께 JSON 저장
- 공개 문맥 미수집 시 모델 다운로드 생략, 미확보 hash·시간·응답은 null 또는 미수집으로 표시. 교수 작성 예시로 대체하지 않기
- 일부 checkpoint·질문만 수집됐거나 입력 조건이 불일치하면 전체 쌍 비교 가능 표시를 false로 유지하고 전체 비교 주장 보류
- 직접 수집 시 모델 ID·revision, 프롬프트, decoding 조건, 수집 시각 기록
- 같은 계열에서도 checkpoint 훈련 자료·단계 등 차이 존재. 응답 차이를 정렬의 인과 효과·안전성 개선으로 단정하지 않기
- 최대24토큰으로 문장이 잘릴 수 있으므로 토큰 상한 도달 여부와 raw 입력 조건을 해석에 포함
□ 공개 정보 질문과 시점 질문
- 정적 질문: “근거에 나타난 제주특별자치도의 두 행정시는?”
- 시점 질문: “이 근거만으로 제주 관광지가 내일 운영한다고 확답할 수 있는가?”
- 정적 정보는 제주 공개 문서 고정 판42464087의 실제 문단과 대조. 원문·입력 문맥 hash를 수집 결과에 기록
- 시점 정보는 최신 공식 운영 공지가 없으면 확인 가능 범위를 명시
- 실시간 데이터가 없는 상태에서 휴관일·입장료·통제 여부를 지어내지 않기
□ 수집표
| 항목 | 기록 내용 |
|---|---|
| 모델 | base/instruct 식별자와 revision |
| 입력 | 동일 질문, 동일 근거 문서, 적용한 대화 형식 |
| 생성 조건 | max_new_tokens, temperature, seed 또는 탐욕 여부 |
| 관측 | 원문 출력·토큰 ID·상한 도달·수집 시각·CPU 생성 시간 |
| 판정 | 확인된 사실, 단정, 근거 유무, 확인 권고 |
| 한계 | 정렬 외 조건 차이, 평가자 판단, 표본 수 |
- 확보하지 않은 자료: “미수집” 표기, 예시 문장으로 실측 칸을 채우지 않기
- 이 골격의 입력 조건은 chat template 미적용. 다른 형식의 추가 비교는 별도 조건으로 기록
week-10-observations.json의actual_response_collection에 출처·환경·실제 생성 결과,response_comparison에는 교수 작성 예시를 따로 저장- CPU 생성 시간은 다운로드·로딩 제외. GPU 지연·전체 서비스 비용은 미측정
- 한 쌍의 응답으로 전체 모델 안전성 순위를 매기지 않기
□ 다음 주 연결
- 이번 주: 응답 끝의 보상 하나를 응답 전체에 전달하는 구조 관찰
- 다음 주: 중간 단계 평가와 Best-of-N 재순위 비교
- 질문: 일부 단계가 타당하고 마지막 답만 틀렸을 때 어떤 신호가 필요한가
- 과정 점수도 정확성·라벨 비용·사용 목적의 검토 필요
- 미발표 연구 데이터·성과를 교과 예제로 사용하지 않기
대면 (1시수)
Section titled “대면 (1시수)”Q3 가치 충돌: 자동 응답을 어디까지 허용할 것인가
Section titled “Q3 가치 충돌: 자동 응답을 어디까지 허용할 것인가”□ 제주 관광 응대 상황 상정
- 제주 공개 행정·관광정보를 활용하는 안내 시스템 상정
- 도내 기업 제공 데이터나 실제 운영 시스템 실험 아님
- 목표: 빨리 답변하면서 확인하지 않은 운영정보의 단정 감소
- 위험: 잘못된 정보가 관광객에게 도달했을 때의 실제 행동 변화
□ 오답 비용의 구분
| 질문 유형 | 잘못 답했을 때의 비용 | 운영 기준 예시 |
|---|---|---|
| 정적 행정구역 | 혼동, 수정 안내 | 근거가 일치하면 자동 응답 후보 |
| 입장료·운영시간 | 이동 낭비, 추가 지출 | 최신 공식 자료와 갱신 시각 확인 |
| 입산·기상 통제 | 안전 위험 | 공식 공지 확인, 불확실하면 확답 보류 |
| 예약·결제 변경 | 권리·금전 손실 | 권한 있는 담당자 확인 및 승인 |
- 비용 크기는 질문별 추정 근거로 토론, 확인하지 않은 금액·사고 통계 사용 금지
- 높은 불확실성의 답변을 항상 무응답 처리하면 유용성 손실 가능
- “확인할 수 없음”과 함께 확인 대상·다음 행동을 안내하는 절충 검토
□ 노트북의 가중치 preset
- 교육용 기준: utility - safety_weight x risk
- utility와 risk는 교수 제공 상정값, 검증된 정량 척도 아님
- 가중치 0, 1, 3을 순서대로 실행하여 선택 순위 관찰
- 위험한 단정의 risk를 보상에서 빠뜨리면 빠른 답변이 선호될 수 있는 구조 확인
- 실무의 안전 제한을 하나의 가중합으로 모두 대체하지 않기
- 고위험 질문은 독립된 허용 조건과 사람 확인이 필요할 수 있음
□ 팀별 토론 산출물
- 같은 질문에 대한 답변 후보 두 개와 출처
- 두 후보의 유용성·안전성 충돌 설명
- 자동 응답 허용 조건, 확인 필요 조건, 사람에게 넘길 조건
- 선택한 절충의 근거와 남은 불확실성
- 학생 식별에는 학번만 사용, 이름·연락처 제외
- [이론] 계보 비교표로 SFT, PPO 기반 RLHF, DPO, GRPO의 감독 입력과 생략한 구성 설명
- reward와 critic의 역할을 구분하고 R1-Zero 반례, DAPO 집계의 범위를 논문 해당 절과 대조
- [구현] 제공된 노트북의 모든 셀을 수정 없이 실행하고 broadcast 출력 해석
- 동일 응답의 반복값, 분산 0, 두 집계값 0과 -0.6을 관찰 기록에 정리
- advantage나 verifier 직접 구현 없음, 실제 RL 학습 없음
- [실무] 대면의 Q3 비교표로 관광 답변의 자동 응답 허용 범위 판단
- 유용성·안전성 충돌을 오답 비용과 최신 근거 확인 조건으로 설명
- 정렬 전후 응답 수집표에서 예시·실측·미수집을 구분하여 기록
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. GRPO는 보상모델도 critic도 모두 없애는가?
- 없애는 대상은 학습한 critic. 그룹 상대 advantage를 만들 보상은 여전히 필요
- 보상 공급원은 학습한 모델일 수도, 규칙 verifier일 수도 있음
- critic-free와 reward-free의 구분
Q2. SFT -> PPO -> DPO -> GRPO를 반드시 모두 거쳐야 하는가?
- 교육용 계보이며 필수 실행 순서 아님
- SFT 뒤 DPO를 쓸 수도 있고, R1-Zero처럼 초기 SFT 없이 직접 RL을 적용한 사례도 존재
- 반례가 있다고 모든 과제에서 SFT 생략이 적절하다는 뜻도 아님
Q3. 같은 응답의 모든 토큰이 같은 advantage면 같은 크기로 학습되는가?
- advantage만 동일. 토큰별 확률비·gradient·clipping 결과는 다를 수 있음
- 같은 신호를 전달했다는 사실에서 토큰의 인과 기여나 실제 parameter update의 동일성을 도출 불가
Q4. 보상이 전부 1인 그룹은 전부 0인 그룹보다 advantage가 큰가?
- 그룹 내부 차이만 보면 둘 다 분산 0. 이 예제에서 상대 advantage는 모두 0
- 절대 성공률은 다르므로 운영 평가에서는 반드시 구분
- 실제 학습기의 KL 등 별도 목적항의 효과는 이 비교만으로 판단 불가
Q5. DAPO의 token-level loss는 토큰마다 새로운 점수를 주는가?
- 해당 집계 변경은 전체 토큰 수를 분모로 삼는 가중치 변경
- 길이의 영향은 바뀌지만 토큰별 원인의 중요도를 새로 추정하는 장치는 아님
- DAPO 전체 알고리즘과 이 주차의 집계 예제도 별개
Q6. 예시 두 문장으로 정렬 전후 안전성이 개선되었다고 보고해도 되는가?
- 교수 작성 문장으로는 모델 성능 개선 주장 불가
- 실제 비교에는 모델 식별자·revision·입력·생성 조건·수집 시각·출력 원문 필요
- 한 쌍의 실측이 있어도 전체 안전성과 정렬의 인과 효과를 곧바로 확정하지 않기
스스로 점검
Section titled “스스로 점검”- reward와 critic의 역할을 각각 한 문장으로 설명하자.
- SFT 예제의 정답 토큰 확률이 [0.5, 0.25, 0.8]일 때, 세 위치의 음의 로그확률과 평균 token CE를 계산하자. 모두 0.8인 preset과 어느 쪽 손실이 큰가?
- PPO 예제의 old 확률0.20, new 확률0.30, epsilon0.2에서 rho를 구하자. A=+1과 A=-1 각각의 raw 항, clipped 항, 최종 min을 계산하고 두 부호에서 clipping 결과가 다른 이유를 설명하자.
- DPO 예제의 reference P(V)=0.10, P(U)=0.20, policy P(V)=0.20, P(U)=0.10, beta0.5에서 두 로그비, margin, 선호확률, loss를 구하자. policy가 reference와 같을 때와 비교하자.
- GRPO 보상 [0,0,1,1]의 평균과 표본 표준편차를 구하고, 보상1인 D의 advantage를 계산하자. D의 길이를8에서16으로 바꾸면 각 위치의 advantage는 바뀌는가? [1,1,1,1] 그룹에서는 어떻게 처리하는가?
- 기본 offline DPO가 생략하는 단계와 필요한 데이터를 설명하자.
- outcome GRPO와 process supervision의 감독 위치를 구분하자.
- 같은 advantage가 토큰별 실제 gradient까지 같다는 뜻이 아닌 이유를 설명하자.
- 길이2와8의 응답에서 각 토큰 surrogate가 각각+1과-1일 때 응답 평균과 전체 토큰 평균을 구하자. 이 차이가 token credit assignment인가?
- 교수 작성 예시와 직접 수집한 응답의 기록 차이를 쓰고, 관광 안내의 높은 reward가 낮은 오답 비용을 보장하는지 설명하자.
정답과 계산 과정 보기
- reward는 응답 평가 신호, critic은 접두 상태의 기대 return을 추정하는 baseline. 평가 기준과 그 기준에서 예상할 성과의 구분
- 토큰 CE는 각각 -ln(0.5)=0.693147, -ln(0.25)=1.386294, -ln(0.8)=0.223144. 평균은(0.693147+1.386294+0.223144)/3=0.767528. 모두0.8이면 평균0.223144이므로 혼합 preset의 손실이 더 큼. 정답 확률이 낮은 두 번째 위치의 손실이 가장 큼
- rho=0.30/0.20=1.5, clip 구간[0.8,1.2]에서 clipped rho=1.2
- A=+1: raw=1.5, clipped=1.2, min=1.2. 좋은 행동을 과도하게 올린 추가 이득 제한
- A=-1: raw=-1.5, clipped=-1.2, min=-1.5. 나쁜 행동을 올린 손해가 그대로 남음
- surrogate의
min때문에 단순히 확률비를 구간 안으로 고정한 것과 다른 결과
- 선호 로그비 ln(0.20/0.10)=ln2=0.693147, 비선호 로그비 ln(0.10/0.20)=-ln2=-0.693147
- 차이=1.386294, margin=0.5x1.386294=0.693147
- sigmoid(margin)=1/(1+exp(-0.693147))=2/3=0.666667
- loss=-ln(2/3)=0.405465
- policy=reference이면 로그비와 margin 모두0, 선호확률0.5, loss0.693147. 선호 방향 preset의 손실 감소 확인
- 평균0.5. 편차 제곱 합은4x0.25=1, 표본 분산1/(4-1)=1/3, 표준편차sqrt(1/3)=0.577350
- D의 advantage=(1-0.5)/0.577350=+0.866025
- 길이8에서16으로 바뀌어도 제공 보상과 그룹 통계는 동일하므로 각 위치+0.866025. 반복 위치 개수와 집계 가중치는 달라질 수 있음
- 동일 보상 그룹의 표준편차는0. 예제는 0으로 나누지 않고 상대 advantage를 모두0으로 처리. 절대 성공률은 혼합 그룹과 다름
- 독립 reward model 학습과 PPO rollout 루프 생략. 질문·선호 답변·비선호 답변 쌍 필요
- outcome은 완성 응답 보상, process는 중간 단계 보상. 이 주차의 동일 broadcast는 outcome 설정
- 각 토큰의 확률비·gradient·clipping 작동이 다를 수 있으므로 동일 update 보장 불가
- 응답 평균=(+1-1)/2=0. 전체 토큰 평균=(2x1+8x(-1))/(2+8)=-0.6. 값의 합산 계수·길이 가중치 변경이며 어느 토큰이 원인이었는지 추정한 결과 아님
- 예시는 작성 사실 표기, 실측은 모델·revision·입력·생성 조건·시각·원문 기록, 미확보 출력은 미수집 표기. reward가 관광객의 행동 비용을 충분히 반영하지 않으면 높은 점수와 낮은 오답 비용이 불일치할 수 있어 최신 근거와 허용 조건 별도 확인
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 한 줄 뜻 |
|---|---|
| 정렬 (alignment) | 생성 행동을 선택한 선호·가치·규칙 기준에 맞추는 학습과 평가 |
| SFT | 제공된 시연 답변의 다음 토큰 likelihood를 높이는 지도 미세조정 |
| RLHF | 사람 피드백을 학습 신호로 사용하는 강화학습 접근 |
| policy | 주어진 문맥에서 다음 행동·토큰의 확률을 정하는 모델 |
| reward | 응답 또는 과정의 바람직함을 나타내는 평가 신호 |
| critic / value function | 상태에서 이후 받을 return의 기대값 추정기 |
| advantage | 관찰 결과가 baseline보다 얼마나 좋은지 나타내는 상대 신호 |
| old policy | 현재 배치의 rollout을 생성한 정책, 확률비의 분모 |
| reference policy | 정책의 분포 변화 제약에 쓰는 비교 기준 |
| DPO | 선호쌍으로 정책을 직접 최적화하는 목적함수 기반 방법 |
| GRPO | 같은 질문의 응답 그룹 통계로 학습한 critic을 대체하는 방법 |
| broadcast | 응답 단위 신호를 해당 응답의 여러 토큰 위치에 반복 전달 |
| loss aggregation | 토큰·응답별 손실을 하나의 학습 목적값으로 합산하는 방식 |
| credit assignment | 결과의 신용을 어떤 행동·단계·토큰에 배분할지 정하는 문제 |
| 대상 | 출처와 범위 |
|---|---|
| 제주 행정정보 | 위키백과 「제주특별자치도」 고정판 42464087, 7주차와 같은 판. 제주시·서귀포시의 정적 사실 확인용 |
| 공통 관광 질문과 U/V 답변 | 교수 작성 상정 예시. 관광지의 실제 운영 공지·기업 데이터·모델 실측 출력 아님 |
| SFT와 사람 선호 파이프라인 | Ouyang 외, 2022, 시연·선호쌍·reward·PPO 구성 |
| clipped surrogate | Schulman 외, 2017, PPO 목적함수 |
| 직접 선호 목적함수 | Rafailov 외, 2023, DPO 로그비와 선호쌍 |
| 그룹 상대 outcome 신호 | Shao 외, 2024, DeepSeekMath 4.1.2 |
| SFT 없는 RL 반례 | DeepSeek-R1, 2025, R1-Zero와 R1 구분 |
| 토큰 집계 | Yu 외, 2025, DAPO 3.3 |
| 그림과 계산 | 도입 그림은 개념 일러스트, SVG는 편집 가능한 직접 제작 도식. 수치는 제공값의 산술 계산이며 학습 성능 측정 아님 |
실습 노트북
Section titled “실습 노트북”
- 준비된 SFT·선호·PPO·DPO 숫자를 실행한 뒤 GRPO의 응답 보상 broadcast와 집계 차이를 관찰하는 노트북
- Python 표준 라이브러리, CPU 실행. 모델 가중치 다운로드·GPU·패키지 설치 불필요
- 관찰 전용, 코드 변경 지점 없음. advantage·verifier 직접 구현 요구 없음
- 실제 모델 학습이나 정렬 성능 측정이 아니라 제공된 숫자의 목적함수 계산
- 실행 안내: 모든 셀을 수정 없이 순서대로 실행하여 표의 숫자와 JSON 산출물 대조. 출력은 제공값의 산술 결과이며 모델 학습 성능이 아님