
특강: Jev와 LLM - 결정 모델과 생성 모델
이 특강이 놓이는 자리
Section titled “이 특강이 놓이는 자리”□ 4주차에서 멈춘 지점
- 4주차에서 이런 문장을 읽었다. “분류 과제도 결국 이 형태다. 모델이 주차라는 토큰에 가장 높은 확률을 두면 그것이 답이다. 분류기를 따로 붙이지 않아도, 다음 토큰 맞히기 하나로 분류가 되는 셈이다”
- 맞는 말이다. 그런데 거기서 한 걸음 더 나가면 다른 질문이 나온다. “그 계산이 정말 필요한가”
- 우리가 원한 것은 라벨 하나다. 그런데 모델은 라벨을 내놓기 위해 토큰을 한 개씩, 차례로, 앞 토큰을 다시 읽어 가며 만들어 낸다. 답이 세 개 중 하나로 이미 정해져 있는데도 그렇다
- 이 특강은 그 낭비를 정면으로 겨냥한 모델 한 부류를 본다. 이름은 Jev이고, 만든 곳은 TypeSafe AI다. 이 부류를 결정 모델(decision model) 또는 시스템 1 모델(System One model)이라 부른다
□ 이 특강의 목표
- Jev를 쓰게 만드는 것이 목적이 아니다. LLM이 무엇을 하는 기계인지 더 선명하게 보는 것이 목적이다. 비교 대상이 있어야 경계가 보인다
- 끝나면 세 가지를 구분할 수 있어야 한다
- 글을 만들어야 하는 일과, 갈림길만 고르면 되는 일
- 형식이 틀리는 오류와, 판단이 틀리는 오류
- 모델이 주는 신호와, 그 신호로 무엇을 할지 정하는 코드
같은 질문, 두 가지 계산
Section titled “같은 질문, 두 가지 계산”□ 질문은 하나다
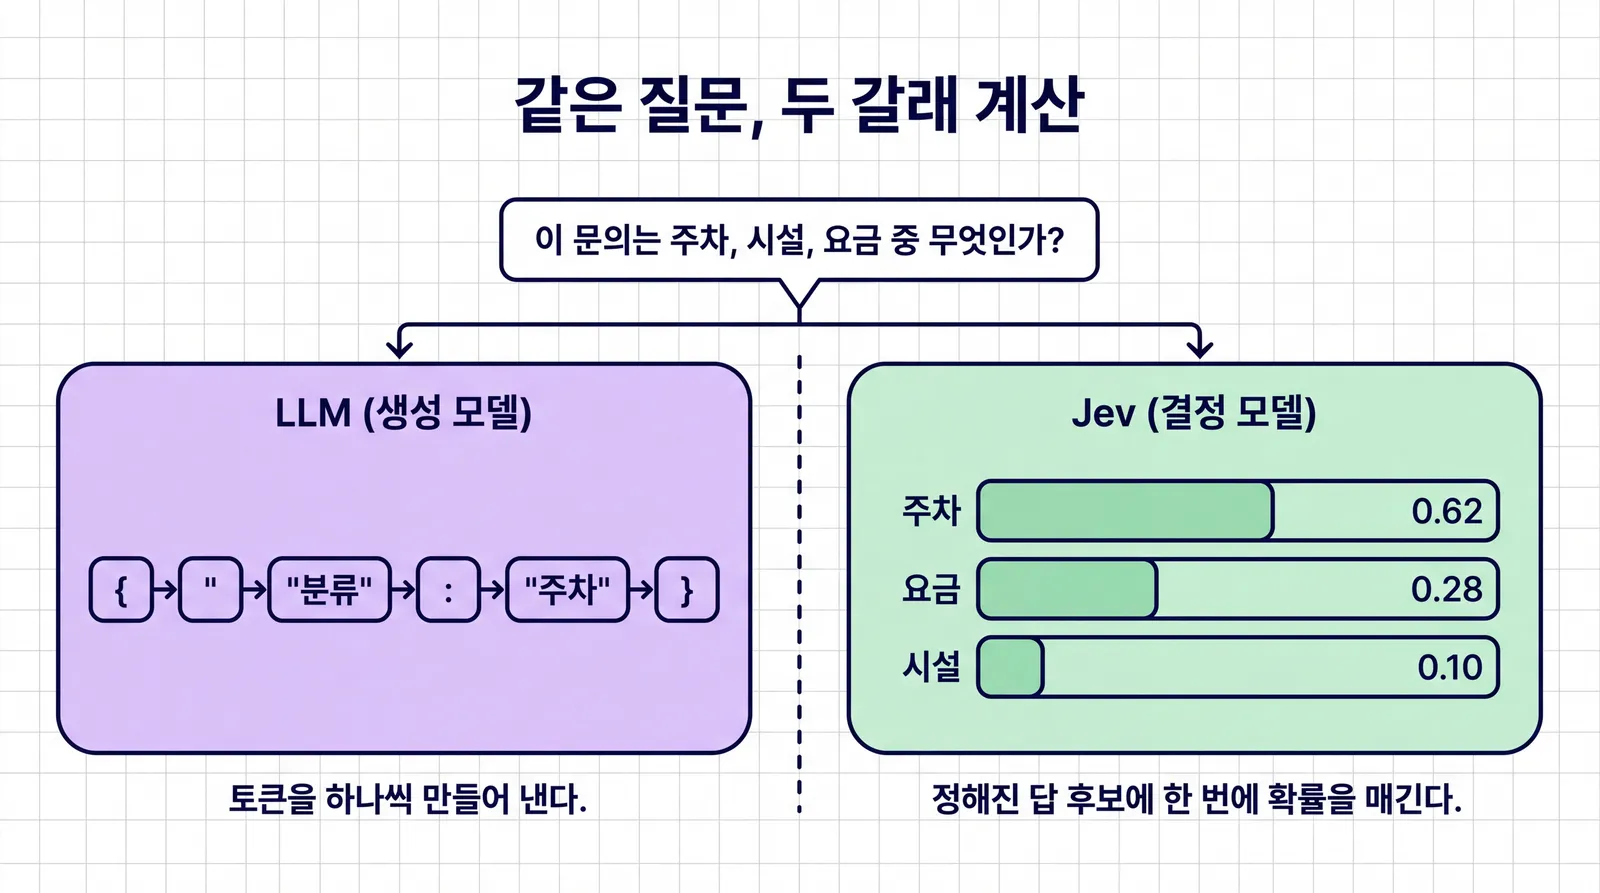
- 제주 관광 안내 창구에 문의가 들어왔다고 하자. 코드가 알고 싶은 것은 딱 하나다. “이 문의는 주차, 시설, 요금 중 무엇인가”
- 답은 셋 중 하나다. 새로 만들어 낼 것이 없고, 고르기만 하면 된다
□ LLM이 이 질문을 처리하는 방식
- LLM에게 JSON으로 답하라고 시키면 이렇게 나온다
{ "분류" : "주차" }- 짧아 보이지만 모델 입장에서는 토큰이 여섯에서 아홉 개다. 그리고 그 토큰들은 동시에 나오지 않는다.
{를 만든 뒤 그것을 다시 읽어서"분류"를 만들고, 또 다시 읽어서:를 만든다 - 게다가 이 글자열은 약속일 뿐 보장이 아니다. 모델이
{ "분류" : "주차 관련 문의로 보입니다" }라고 쓸 수도 있고, 앞에 “네, 분류해 드리겠습니다” 를 붙일 수도 있다. 그래서 받는 쪽 코드에는 늘 파싱과 예외 처리가 붙는다
□ 결정 모델이 이 질문을 처리하는 방식
- Jev에게는 답 후보를 미리 알려 준다. 주차, 시설, 요금 셋이다
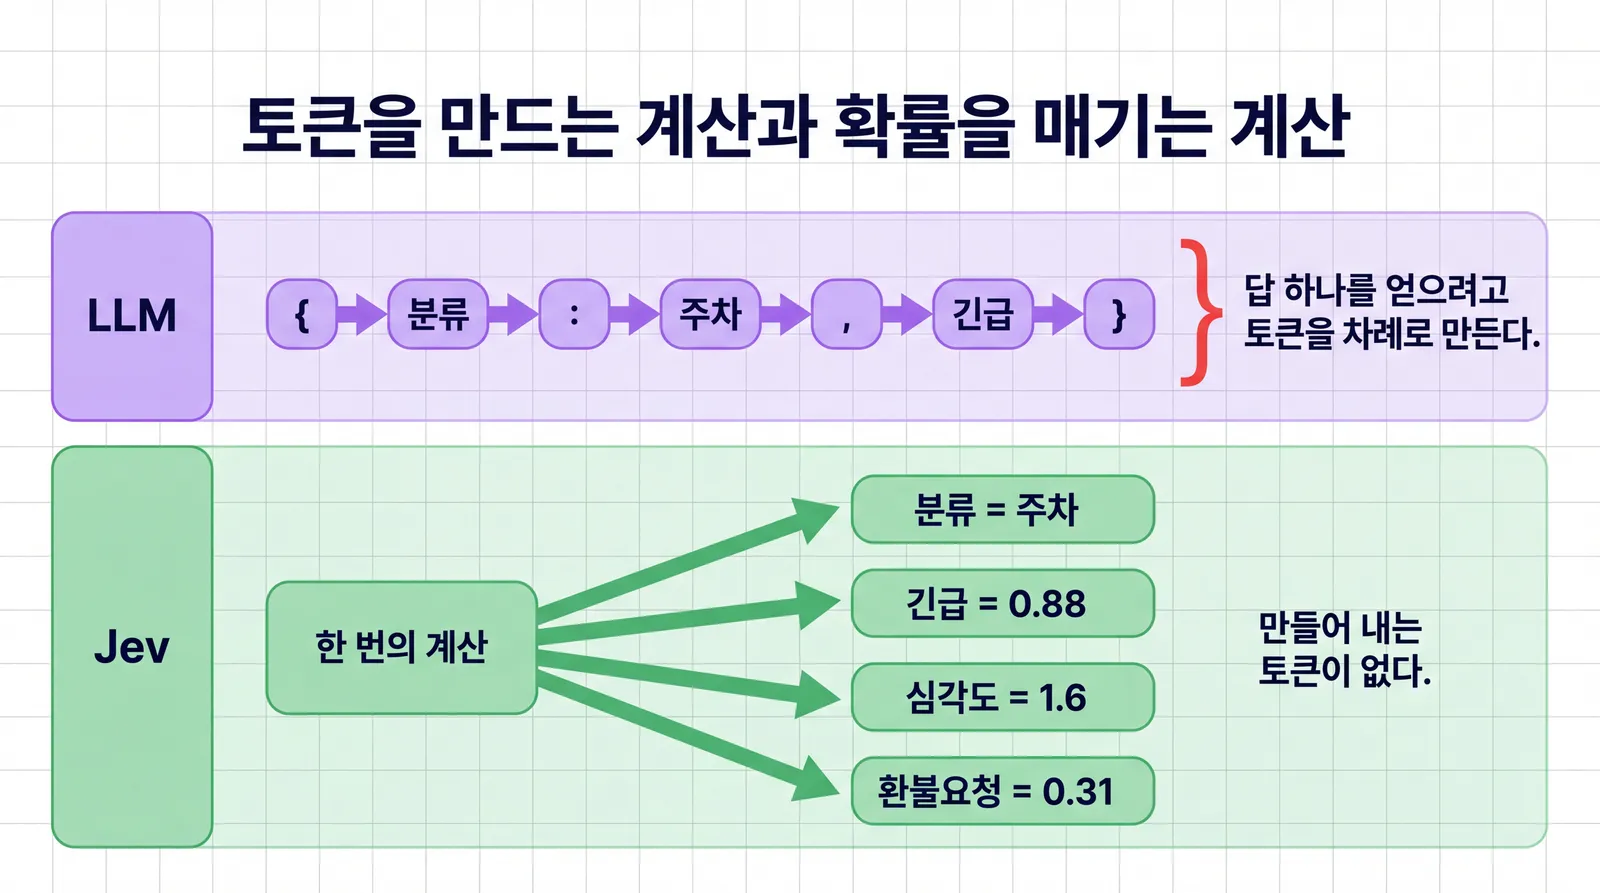
- 모델은 글을 만들지 않는다. 주어진 세 후보 각각에 확률을 매겨서 한 번에 돌려준다
- 만들어 내는 토큰이 0개다. 그래서 파싱할 문자열도 없고, 목록에 없는 답이 나올 자리도 없다
□ 한 줄로 요약한 차이
| LLM (생성 모델) | Jev (결정 모델) | |
|---|---|---|
| 내놓는 것 | 글(토큰 열) | 정해 둔 후보에 붙은 확률 |
| 계산 순서 | 토큰을 하나씩, 앞을 다시 읽으며 | 후보 전체를 한 번에 |
| 출력 토큰 수 | 답 하나에 여러 개 | 0개 |
| 받는 코드가 할 일 | 문자열 파싱 + 예외 처리 | 값을 그대로 씀 |
| 못 하는 일 | - | 글쓰기, 코드 작성, 이유 설명 |
| 잘하는 일 | 열린 답, 긴 설명, 추론 | 답이 정해진 의미 판단 |
- 마지막 줄이 중요하다. Jev는 글을 아예 못 쓴다. 요약도, 답장도, 근거 설명도 못 한다. 성능이 나빠서가 아니라 그런 출력 경로 자체가 없다
시스템 1과 시스템 2
Section titled “시스템 1과 시스템 2”□ 이름의 출처
- “시스템 1”은 대니얼 카너먼이
Thinking, Fast and Slow(생각에 관한 생각)에서 널리 퍼뜨린 말이다. 사람의 판단을 두 갈래로 나눈 비유다- 시스템 1: 빠르고 자동적인 판단. 얼굴을 보고 화났는지 아는 일
- 시스템 2: 느리고 힘이 드는 사고. 17 곱하기 24를 암산하는 일
- TypeSafe AI가 자기 모델을 “시스템 1 모델”이라 부르는 것은 이 비유를 빌린 것이다. 빠르고 자동적인 판단 쪽만 맡겠다는 뜻이다
□ 비유가 주장하지 않는 것
- 주의할 점이 있다. 이 이름은 마케팅 비유이지 인지과학 주장이 아니다. 모델 안에서 사람의 시스템 1과 같은 일이 일어난다는 근거는 없다
- 이름에서 읽어야 할 정보는 딱 하나다. “빠른 판단 전용, 느린 사고는 다른 모델이 맡는다”
- 실제로 공식 문서도 같은 말을 한다. 시스템 1 모델은 답장을 쓰지 않고, 코드를 만들지 않고, 자기 판단의 이유를 설명하지 않는다
□ 학습 방법도 목표가 다르다
- 일반 LLM은 사람이 선호하는 답을 쓰도록 맞추는 방향(RLHF 계열)으로 훈련한다. 10주차에서 다룰 내용이다
- Jev는 RLCD(Reinforcement Learning for Calibrated Decisions, 보정된 결정을 위한 강화학습)라는 방법으로 훈련했다고 밝힌다. 목표가 “좋은 글”이 아니라 “맞는 확률” 이다
- 확률이 맞는다는 것은 이런 뜻이다. 0.9라고 말한 판단 1000건을 모으면 그중 약 900건이 실제로 맞아야 한다. 이것을 보정(calibration)이라 한다
- 이 차이가 뒤에 나올 “확신도로 갈라지는 코드”의 전제다. 확률이 보정돼 있지 않으면 임계값은 아무 의미가 없다
세 가지 질문 유형
Section titled “세 가지 질문 유형”□ 물어볼 수 있는 모양이 정해져 있다
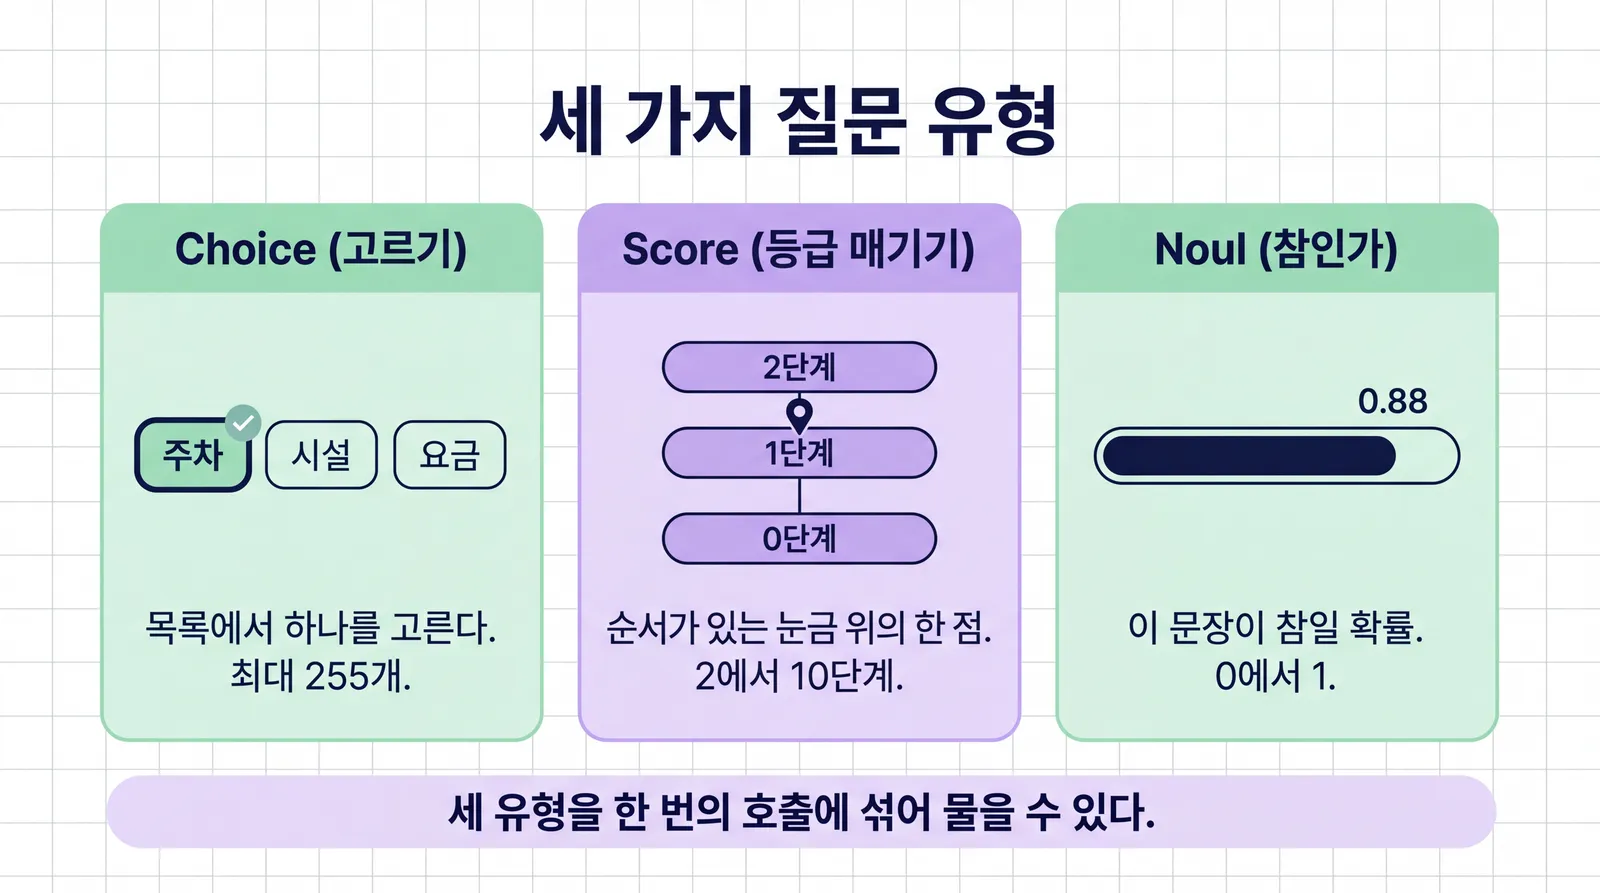
- Jev에게는 아무 질문이나 못 한다. 세 가지 틀 중 하나에 맞춰 물어야 한다
○ Choice - 목록에서 하나 고르기
- 후보 목록을 주면 그중 하나를 고른다. 후보는 최대 255개까지다
- 돌려주는 값은 세 가지다
choice: 확률이 가장 높은 후보probabilities: 후보마다의 확률. 다 더하면 1이다confidence: 0에서 1 사이의 확신도. 계산법은 뒤에서 본다
from typesafe_sdk import Choice, TypeSafeClient
with TypeSafeClient() as client: response = client.system_one( state="성산일출봉 주차장 입구가 막혀서 30분째 못 들어가고 있습니다.", questions={ "분류": Choice( instructions="이 문의를 어느 갈래로 보내야 하는가?", criteria={ "주차": "주차장 위치, 만차, 진입", "시설": "화장실, 매점, 편의시설", "요금": "입장료, 할인, 환불", }, ), }, ) print(response.answers["분류"].choice)- 후보에 설명(criteria)을 붙이는 것에 주목한다. 라벨 이름만으로는 경계가 흐린 경우가 많기 때문이다. 4주차에서 프롬프트에 예시를 붙이면 점수가 올라간 것과 같은 이치다
○ Score - 순서가 있는 눈금에 올리기
- 단계마다 설명을 붙인 2단계에서 10단계짜리 눈금을 주면, 그 위의 한 점을 돌려준다
- 돌려주는
score는 정수가 아니다. 단계별 확률로 가중평균한 값이다. 0단계 0.10, 1단계 0.20, 2단계 0.70이면
score = 0 x 0.10 + 1 x 0.20 + 2 x 0.70 = 1.6- 1.6이라는 값은 “1단계보다 2단계에 가깝다”는 뜻이다. 단계 사이의 위치까지 읽을 수 있다
from typesafe_sdk import Score, TypeSafeClient
with TypeSafeClient() as client: response = client.system_one( state="성산일출봉 주차장 입구가 막혀서 30분째 못 들어가고 있습니다.", questions={ "심각도": Score( instructions="방문객이 겪는 불편이 얼마나 큰가?", criteria=[ "가벼운 문의. 지금 불편하지 않다", "불편하지만 우회할 방법이 있다", "지금 현장에서 막혀 있다", ], ), }, ) print(response.answers["심각도"].score)- 단계 설명은 정도를 나타내는 말(조금, 매우)이 아니라 상황으로 쓰는 것이 좋다. “매우 심각”보다 “지금 현장에서 막혀 있다”가 판단 기준이 분명하다
○ Noul - 이 문장이 참인가
- 예/아니오 질문 하나에 0에서 1 사이 숫자 하나를 돌려준다. 1에 가까우면 참, 0에 가까우면 거짓이다
- 답과 확신도가 한 숫자에 합쳐져 있다는 점이 특징이다. 0.88이면 “참이고 꽤 확실”, 0.52면 “참 쪽이지만 거의 반반”이다
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient
with TypeSafeClient() as client:    response = client.system_one(        state="성산일출봉 주차장 입구가 막혀서 30분째 못 들어가고 있습니다.",        questions={            "긴급": Noul(instructions="지금 바로 대응해야 하는 상황인가?"),            "환불요청": Noul(                instructions="환불이나 요금 반환을 요구하고 있는가?",                criteria=NoulCriteria(                    true="금액을 돌려받기를 원한다는 표현이 있다",                    false="금액 이야기가 없다",                ),            ),        },    )    print(response.answers["긴급"].noul)
□ 세 유형을 한 표로
| 유형 | 묻는 것 | 돌려주는 값 | 제약 |
|---|---|---|---|
| Choice | 목록에서 하나 | choice, probabilities, confidence | 후보 최대 255개 |
| Score | 눈금 위의 위치 | score(가중평균), probabilities, legend, confidence | 단계 2에서 10개 |
| Noul | 이 문장이 참인가 | noul (0에서 1) | 없음 |
- 세 유형은 한 번의 호출에 섞어 쓸 수 있다. 다음 절의 이야기다
한 번에 여러 질문
Section titled “한 번에 여러 질문”□ 상태 하나, 질문 여러 개
- Jev에 넣는 입력을 상태(state)라 부른다. 문의 본문, 고객 이력, 관련 규정처럼 판단에 필요한 재료를 모아 놓은 덩어리다
- 질문은 여러 개를 한꺼번에 던진다. 모든 질문은 같은 상태를 보고 각자 따로, 그리고 병렬로 평가된다
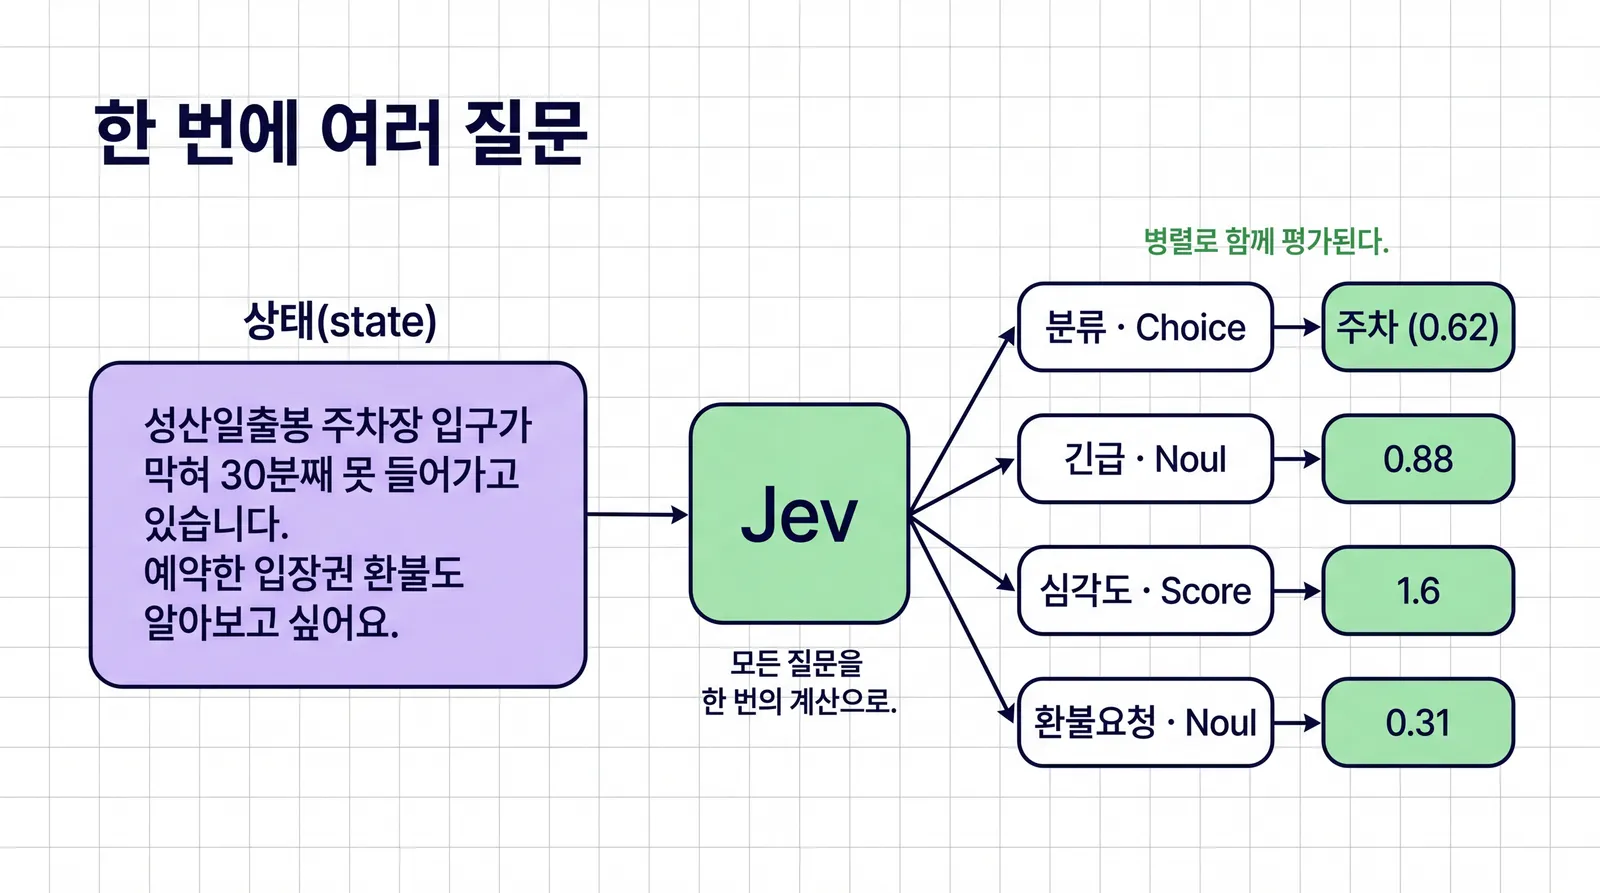
response = client.system_one( state=ticket_text, questions={ "분류": Choice(instructions="어느 갈래인가?", criteria=CATEGORIES), "긴급": Noul(instructions="지금 바로 대응해야 하는가?"), "심각도": Score(instructions="불편이 얼마나 큰가?", criteria=LEVELS), "환불요청": Noul(instructions="환불을 요구하고 있는가?"), },)□ 질문을 더 붙여도 거의 안 느려진다
- 질문이 병렬로 처리되므로, 질문을 하나 더 붙인다고 응답 시간이 눈에 띄게 늘지 않는다
- 그래서 “쓸지 안 쓸지 모르는 질문도 일단 물어 두는” 방식이 가능하다. 공식 문서는 이것을 fan-out 이라 부른다
- 예를 들어
환불요청은 분류가 요금일 때만 쓸 값이지만, 나중에 한 번 더 호출하는 것보다 지금 같이 물어 두는 편이 싸다
분류 = response.answers["분류"]환불 = response.answers["환불요청"]
if 분류.choice == "요금" and 환불.noul > 0.7: 환불_담당자에게(ticket_id)elif 분류.choice == "주차": 주차_안내(ticket_id)- 판단은 모델이 하고 갈림길은 코드가 고른다. 이 분담이 이 특강 전체를 관통하는 이야기다
확률과 확신도
Section titled “확률과 확신도”□ 확률표에서 확신도를 뽑아내는 법
- Choice가 돌려주는
confidence는 새로운 정보가 아니다. 이미 받은 확률표를 한 숫자로 요약한 것이다 - 요약하는 기준은 “확률이 한쪽에 얼마나 몰렸는가”다. 후보가 셋일 때 공식 문서가 밝힌 식은 이것이다
confidence = (3 x 가장 큰 확률 - 1) / 2- 손으로 넣어 보자. 우리 문의의 확률표가 이랬다고 하자 (수치는 설명용 예시다)
| 후보 | 확률 |
|---|---|
| 주차 | 0.62 |
| 요금 | 0.28 |
| 시설 | 0.10 |
confidence = (3 x 0.62 - 1) / 2 = (1.86 - 1) / 2 = 0.43- 1등이 2등의 두 배가 넘는데도 확신도는 0.43이다. 이 감각이 중요하다. “1등이 앞섰다”와 “모델이 확신한다”는 다른 말이다
- 비교로, 확률이 한쪽에 몰린 경우를 보자
| 후보 | 확률 |
|---|---|
| 요금 | 0.94 |
| 주차 | 0.04 |
| 시설 | 0.02 |
confidence = (3 x 0.94 - 1) / 2 = (2.82 - 1) / 2 = 0.91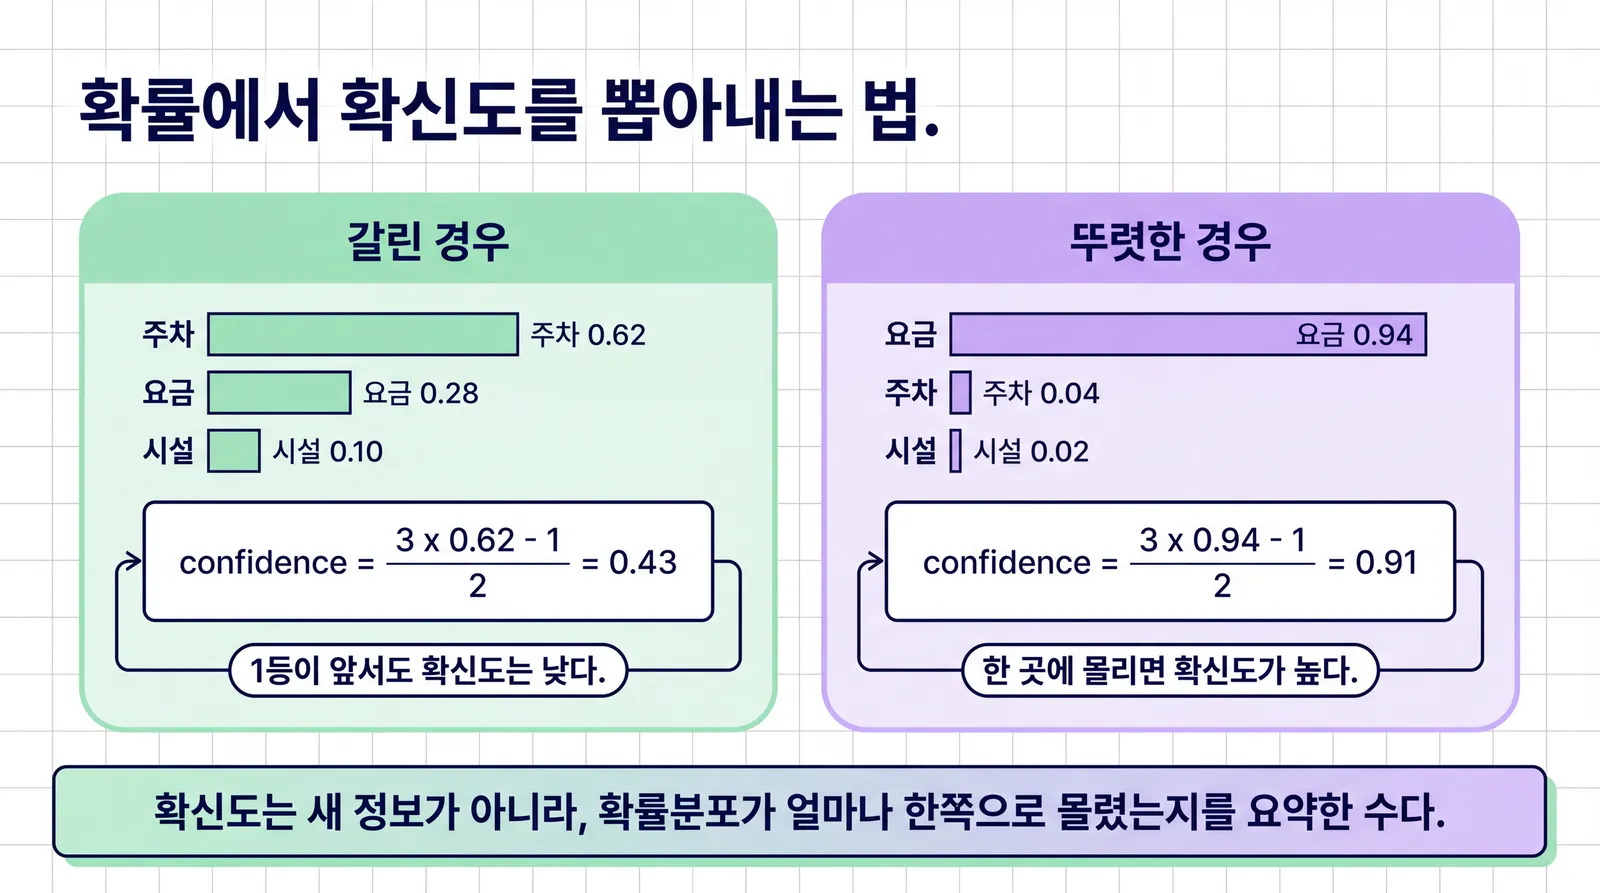
○ 선택지가 셋이 아닐 때
- 위 식은 후보가 셋일 때의 모양이다. 후보 수를 k로 두고 일반화하면 이렇게 쓸 수 있다
confidence = (k x 가장 큰 확률 - 1) / (k - 1)- k에 3을 넣으면 앞의 식과 같아진다. 그리고 두 극단에서 값이 맞는지 확인할 수 있다
- 모든 후보가 똑같이 1/k 이면 confidence는 0이다. 모델이 전혀 못 가린다는 뜻이다
- 한 후보가 1.0이면 confidence는 1이다
□ 확신도가 쓸모 있으려면
- 확신도가 높을 때 실제로 더 자주 맞아야 쓸모가 있다. 앞에서 본 보정이 바로 이 조건이다
- 일반 LLM에게 “몇 퍼센트 확신하나요?”라고 물어서 받은 숫자는 대체로 이 조건을 만족하지 못한다. 보정되지 않은 자신감이라 대개 과하게 높다
- 이 특강의 실습 노트북에서, 확신도 구간별로 정확도를 직접 재 본다. 믿을 말이 아니라 재 볼 수 있는 값이라는 것이 요점이다
확신도로 갈라지는 코드
Section titled “확신도로 갈라지는 코드”□ 답 하나, 신호 하나
- Jev가 주는 것은 두 축이다. 답은 “무엇인가”를, 확신도는 “실행해도 되는가”를 말한다
- 그래서 코드는 이렇게 생긴다
분류 = response.answers["분류"]
if 분류.confidence > 0.85:    자동_배정(ticket_id, 분류.choice)elif 분류.confidence > 0.60:    담당자에게_제안(ticket_id, 분류.choice)   # 사람이 한 번 누른다else:    사람_검토함으로(ticket_id)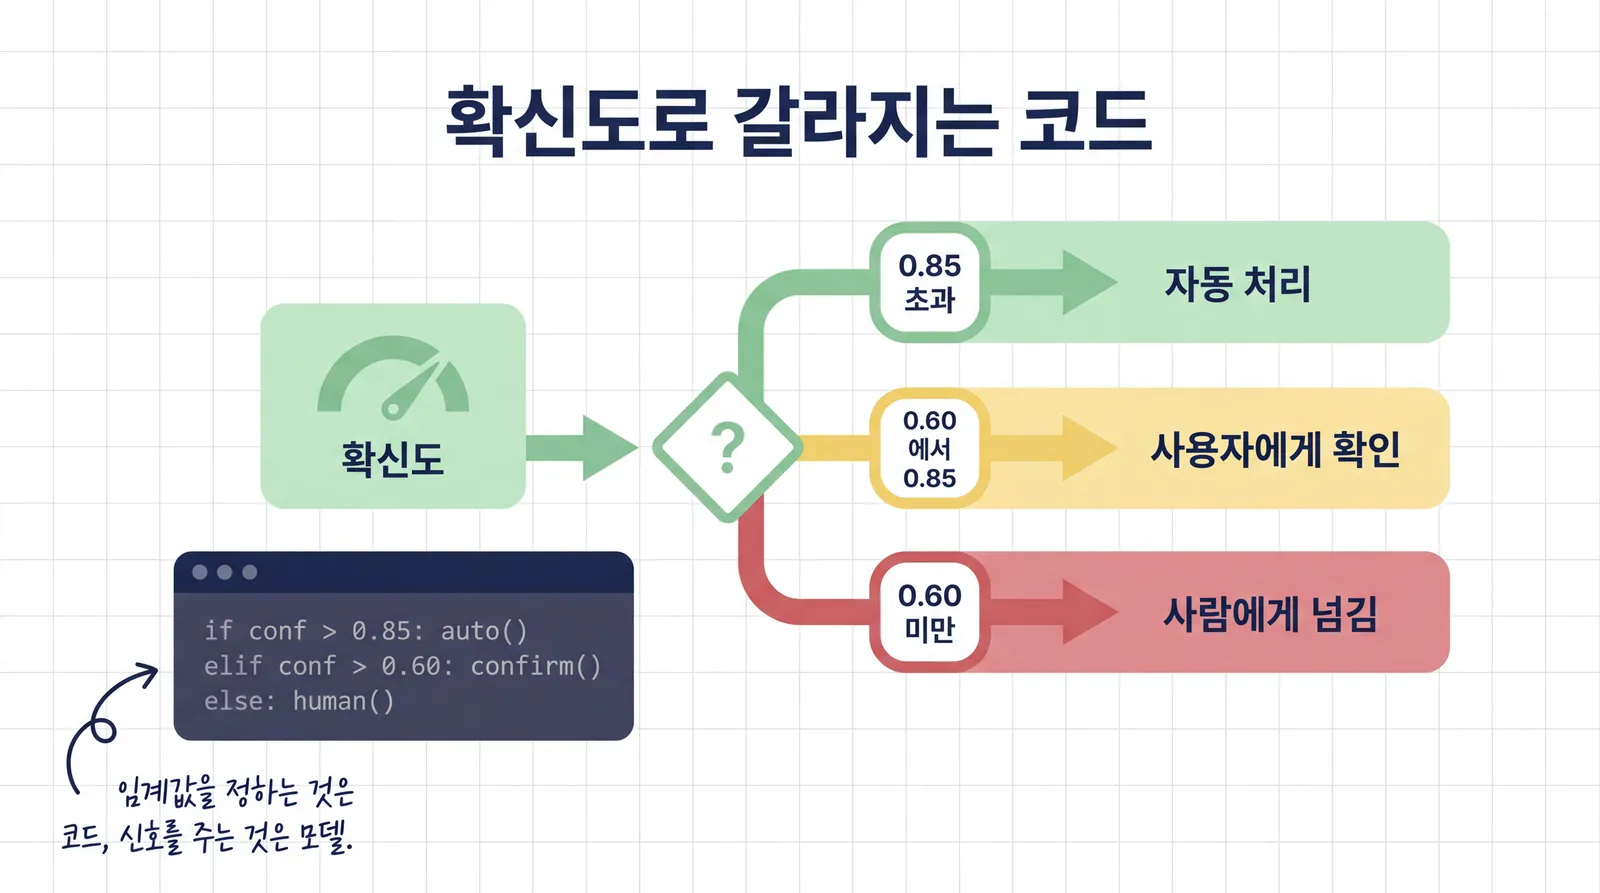
□ 임계값은 어디서 오나
- 공식 문서가 권하는 대략의 기준은 이렇다
| 확신도 | 권장 동작 |
|---|---|
| 0.9 초과 | 사람 확인 없이 자동 실행 |
| 0.5 에서 0.9 | 조심해서 진행. 확인을 받거나 정보를 더 모은다 |
| 0.5 미만 | 사람에게 넘긴다. 진행하지 않는다 |
- 다만 문서의 라우팅 예제는 바닥선 0.6, 위험한 동작은 0.85를 쓴다. 정해진 정답이 없다는 뜻이다
- 기준은 틀렸을 때의 대가로 정한다. 같은 시스템 안에서도 동작마다 달라야 한다
- 문의를 잘못 배정하면 담당자가 다시 넘기면 된다. 낮은 임계값도 괜찮다
- 환불을 잘못 집행하면 돈이 나간다. 임계값을 높이고, 그 위에서도 확인을 받는다
- 여기서 놓치지 말 것. 임계값을 정하는 것은 코드이고, 모델은 신호만 준다. 모델에게 “알아서 판단해서 실행해”라고 맡기는 구조와 완전히 다르다
“환각이 불가능하다”의 정확한 뜻
Section titled ““환각이 불가능하다”의 정확한 뜻”□ 이 특강에서 가장 중요한 부분
- 결정 모델을 소개하는 글에는 “환각이 불가능하다”는 말이 자주 나온다. 절반만 맞는 말이다
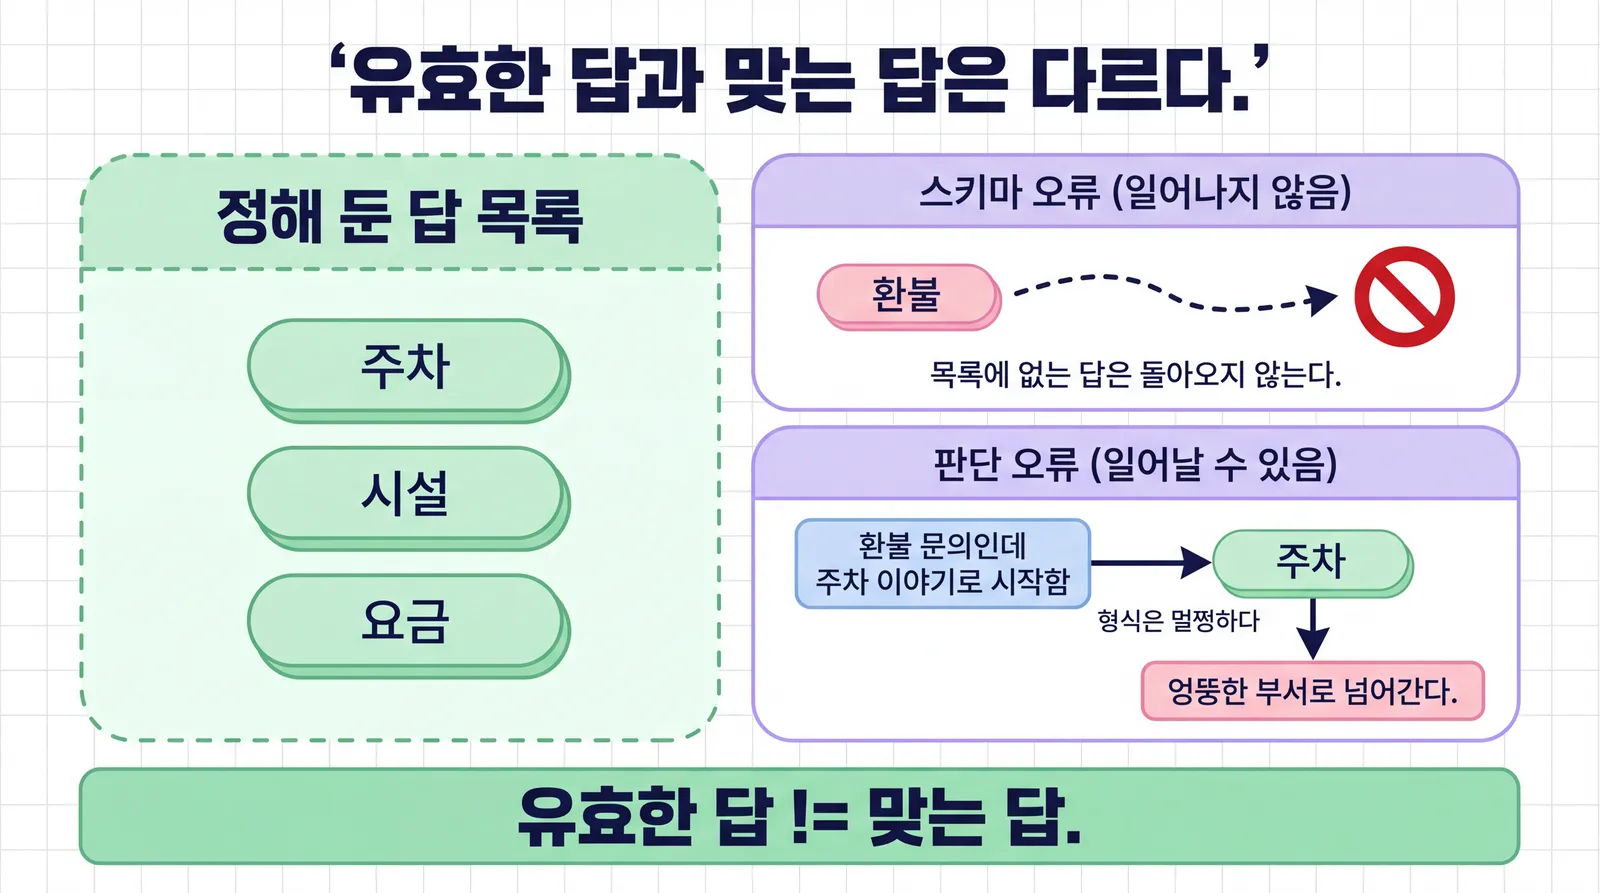
- 오류를 두 종류로 갈라야 한다
○ 스키마 오류 - 정말로 일어나지 않는다
- 후보를 주차, 시설, 요금으로 정해 두면 “환불”이라는 답은 절대 돌아오지 않는다. 그런 출력 경로가 없기 때문이다
- 빈 값도, 잘린 JSON도, “죄송하지만 분류할 수 없습니다” 같은 문장도 나오지 않는다
- 그래서 받는 코드에서 파싱 실패 처리, 재시도, 형식 검증이 통째로 사라진다. 이것이 진짜 이득이다
○ 판단 오류 - 그대로 일어난다
- 이런 문의를 생각해 보자
성산일출봉 주차장 입구가 막혀서 30분째 못 들어가고 있습니다.예약한 입장권 환불도 알아보고 싶어요.- 이 문의의 실제 용건은 **환불(요금)**이다. 그런데 앞 문장이 주차 이야기라서 모델이
주차를 고를 수 있다 - 돌아온 답은 형식상 완벽하다. 목록 안에 있고, 확률도 붙어 있고, 파싱 오류도 없다. 그런데 틀렸다
- 결과는 엉뚱한 부서 배정이고, 환불 요청은 아무도 못 본 채 남는다
□ 유효한 답 != 맞는 답
- 이 구분을 문장 하나로 남기면 이렇다. 스키마가 막아 주는 것은 형식이지 판단이 아니다
- 벤더가 공개한 수치 자체가 이것을 보여 준다. 자기 벤치마크에서 Jev의 정확도는 67.8% 다. 다시 말해 약 3분의 1은 형식이 멀쩡한 채로 틀린 답이었다
- 그래서 확신도와 임계값이 장식이 아니다. 판단 오류가 남아 있다는 것을 전제로 설계한 안전장치다
그러면 LLM의 환각과 무엇이 다른가?
LLM의 환각은 두 가지가 섞여 있다. 없는 사실을 지어내는 것(내용 오류)과, 약속한 형식을 깨는 것(형식 오류)이다.
결정 모델은 형식 오류를 구조적으로 없앤다. 내용 오류는 그대로 남는다. 다만 내용 오류가 정해진 후보 안에서만 일어나므로 범위가 좁고, 확률이 붙어 오므로 의심할 실마리가 있다.
“환각이 없다”는 말을 “틀리지 않는다”로 읽으면 안 된다.
비용과 지연
Section titled “비용과 지연”□ 벤더가 공개한 비교
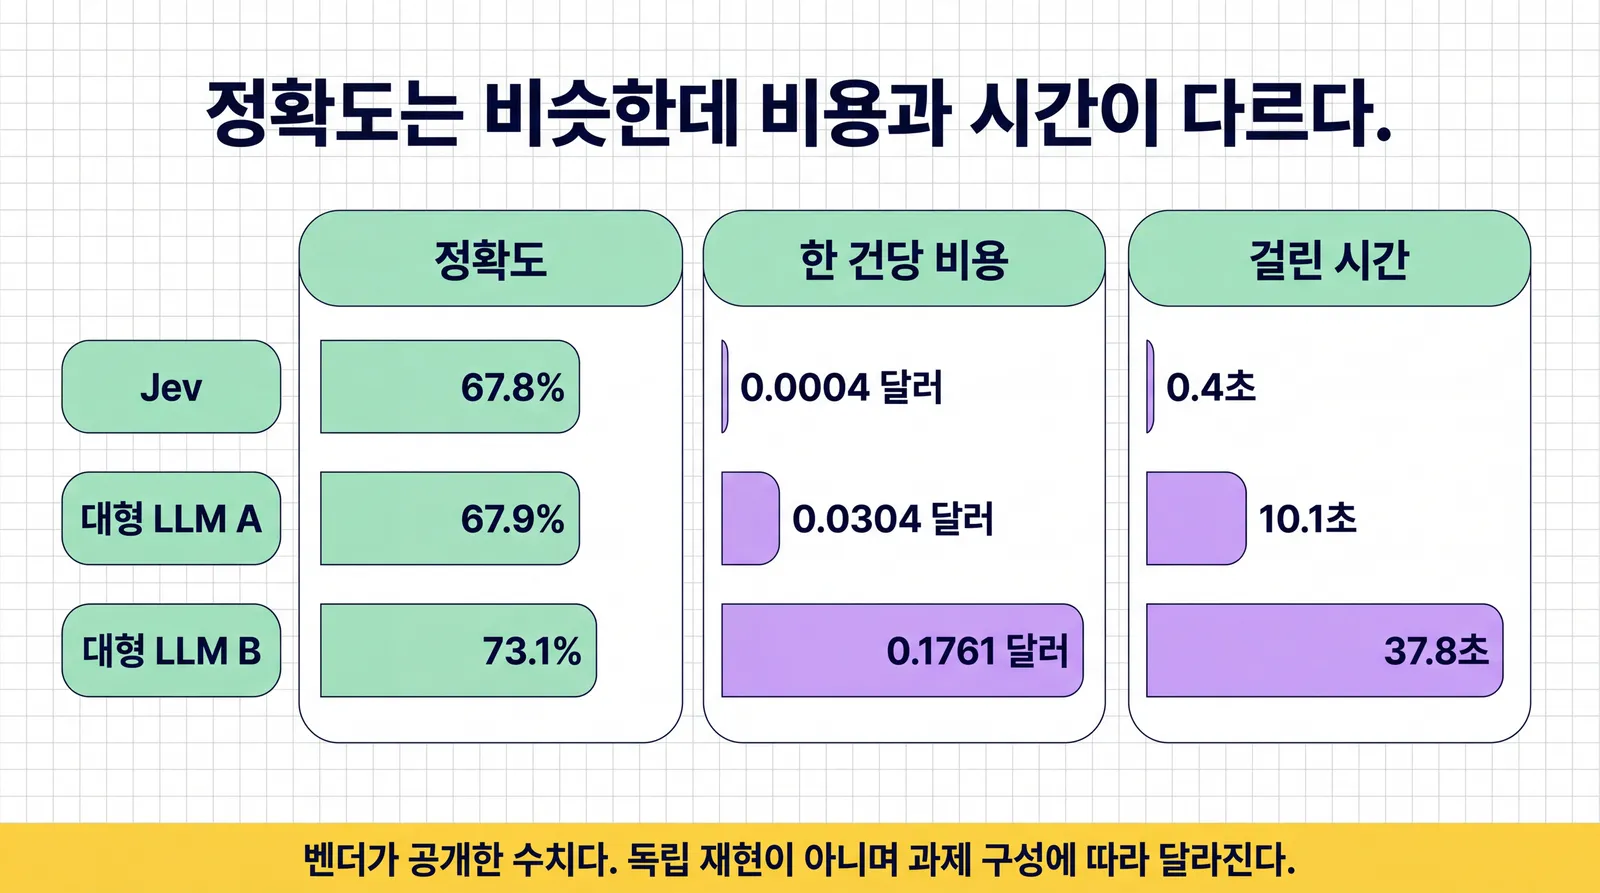
- 아래 표는 TypeSafe AI 쪽이 공개한 수치다. 독립적으로 재현된 값이 아니고, 과제 구성에 따라 크게 달라진다. 그대로 믿을 숫자가 아니라 크기 차이의 감을 잡는 용도로 읽는다
| 시스템 | 정확도 | 한 건당 비용 | 걸린 시간 |
|---|---|---|---|
| Jev | 67.8% | 0.0004 달러 | 0.4초 |
| 대형 LLM A | 67.9% | 0.0304 달러 | 10.1초 |
| 대형 LLM B | 73.1% | 0.1761 달러 | 37.8초 |
□ 표에서 읽을 것
- 정확도는 비슷한데 비용과 시간은 자릿수가 다르다. 대형 LLM A와 비교하면 정확도 차이는 0.1%p인데 비용은 약 76배, 시간은 약 25배다
- 대형 LLM B는 정확도가 5.3%p 높다. 더 정확한 쪽이 있다는 사실을 표가 숨기지 않는다. 정확도가 돈보다 중요한 판단이라면 그쪽을 써야 한다
- 나머지 공개 수치도 같은 방향이다
- 응답 시간 70밀리초에서 500밀리초
- 입력 100만 토큰당 0.042 달러, 출력 토큰은 과금하지 않음(만들어 내는 토큰이 없으므로)
□ 언제 이 차이가 의미를 갖나
- 한 달에 100건 분류한다면 비용 차이는 3달러다. 아무 의미가 없다
- 한 달에 1000만 건 분류한다면 4000달러 대 30만 달러다. 그때부터 구조를 바꿀 이유가 생긴다
- 그리고 시간 차이는 건수와 무관하게 사용자 경험을 바꾼다. 화면에서 기다리는 0.4초와 10초는 다른 제품이다
언제 무엇을 쓰나
Section titled “언제 무엇을 쓰나”□ 셋 중 하나를 고른다
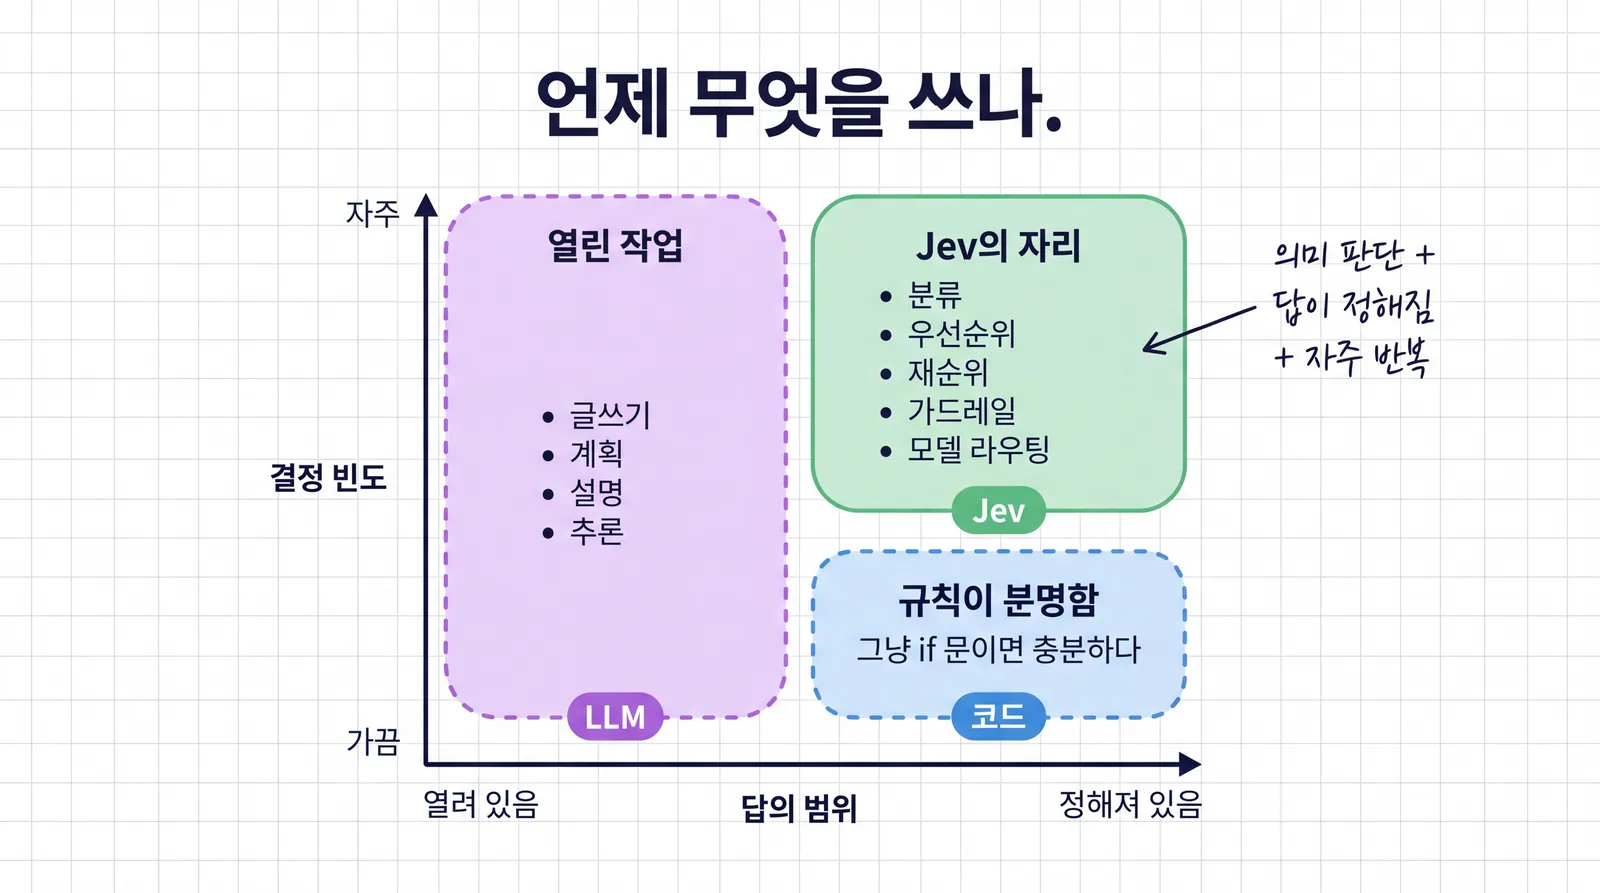
| 상황 | 쓸 것 | 이유 |
|---|---|---|
| 규칙이 분명하다 | 그냥 if 문 | 모델이 필요 없다. if 금액 > 100000: 검토() |
| 답이 열려 있다 | LLM | 글쓰기, 계획, 설명, 코드, 추론 |
| 답이 정해져 있고 자주 반복된다 | 결정 모델 | 의미 판단이 필요하지만 후보가 정해져 있다 |
- 첫 줄을 잊기 쉽다. 모델을 안 쓰는 것이 늘 첫 번째 선택지다. “제목에 환불이라는 단어가 있는가”는 모델이 아니라 문자열 검색으로 푸는 문제다
- 결정 모델의 자리는 세 조건이 동시에 맞을 때다
- 의미를 읽어야 한다 (문자열 검색으로는 안 된다)
- 답 후보가 미리 정해진다
- 같은 질문을 아주 많이 반복한다
□ 결정 모델이 잘 맞는 일들
- 공식 문서가 정리한 갈래를 우리 수업 맥락으로 옮기면 이렇다
| 갈래 | 예 | 관련 주차 |
|---|---|---|
| 분류 | 문의를 주차/시설/요금으로 | 4주차 |
| 탐지 | 개인정보가 섞였는가, 탈옥 시도인가 | 12주차 |
| 등급 | 답변 품질, 불편 정도 | 5주차 |
| 재순위 | 검색 결과 중 무엇이 질문에 답하는가 | 9주차 |
| 검증 | 이 답이 근거 문서에 실제로 있는가 | 5주차, 9주차 |
| 라우팅 | 이 요청을 작은 모델로 보낼까 큰 모델로 보낼까 | 이 특강 |
- 특히 재순위와 검증은 9주차 RAG에서 다시 만난다. RAG 파이프라인에서 “검색된 문단이 질문에 답하는가”는 전형적인 Noul 질문이다
Jev는 LLM을 대체하지 않는다
Section titled “Jev는 LLM을 대체하지 않는다”□ 감싸는 구조
- 여기까지 보면 둘 중 하나를 고르는 이야기 같지만, 실제 시스템에서 둘은 경쟁하지 않는다
- 에이전트 한 바퀴를 생각해 보자. LLM이 무엇을 할지 정하고, 도구가 실행되고, 결과를 다시 본다. 그 고리 곳곳에 작은 갈림길이 있다
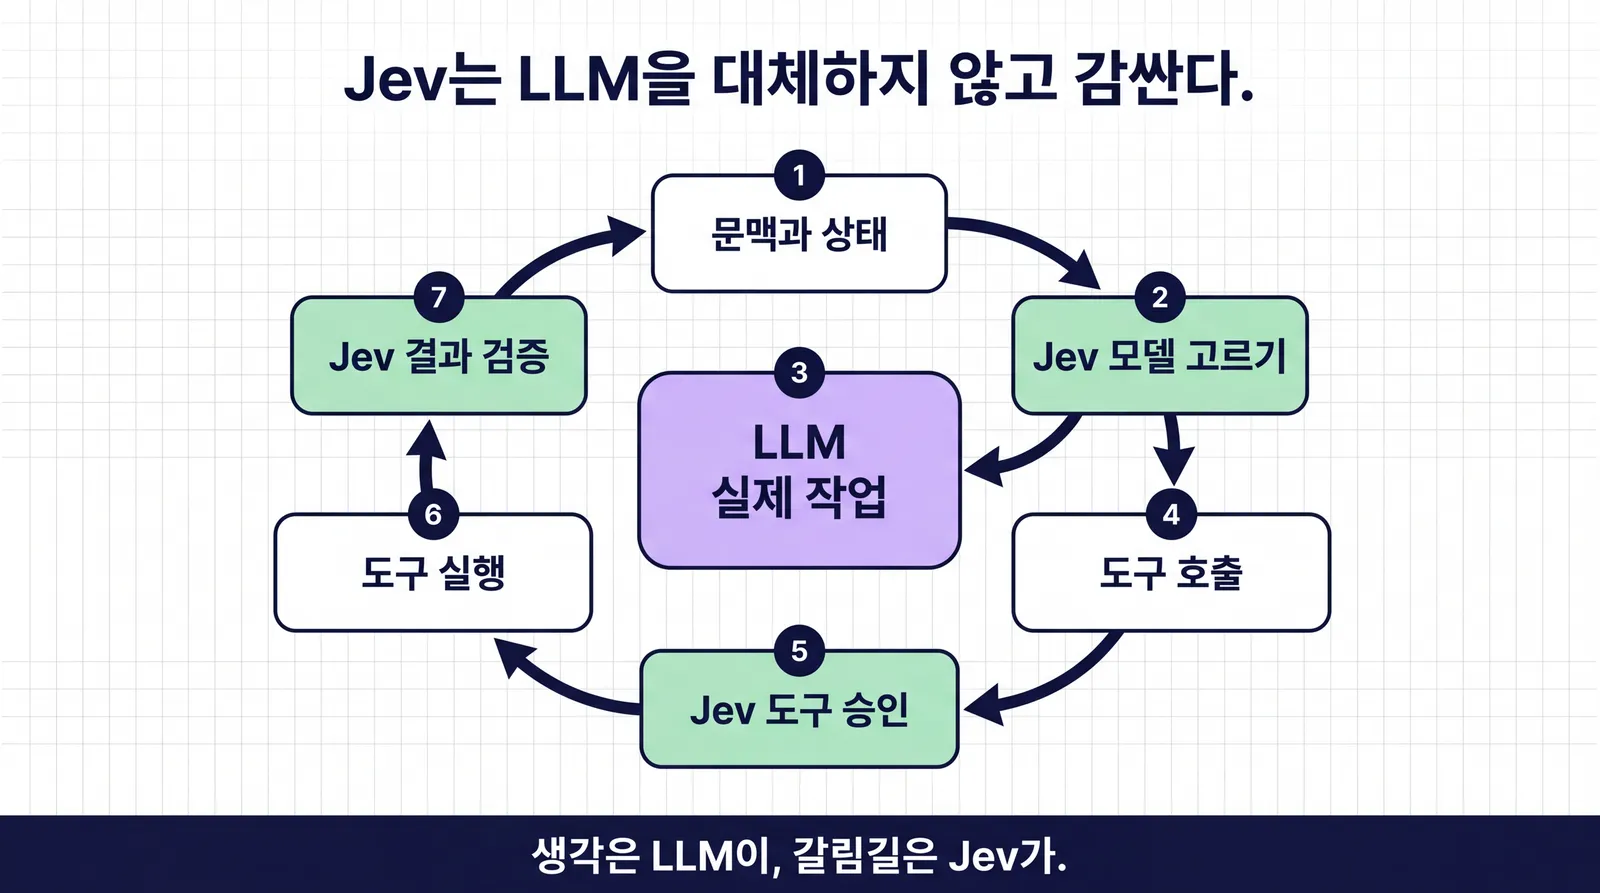
| 단계 | 하는 일 | 누가 |
|---|---|---|
| 1 | 문맥과 상태를 모은다 | 코드 |
| 2 | 이 요청에 어느 모델을 쓸지 고른다 | 결정 모델 |
| 3 | 실제 작업을 한다 | LLM |
| 4 | 도구를 부른다 | LLM |
| 5 | 이 도구 호출이 위험한지 본다 | 결정 모델 |
| 6 | 도구를 실행한다 | 코드 |
| 7 | 결과가 요구에 맞는지 본다 | 결정 모델 |
○ 2번, 모델 라우팅
- 모든 요청에 가장 큰 모델을 쓸 이유가 없다. “이 요청이 단순 조회인가, 설계 판단인가”는 Choice 한 번으로 갈린다
- 단순한 쪽을 작은 모델로 보내면 전체 비용이 내려간다. 고르는 비용 자체는 앞의 표대로 거의 0이다
○ 5번, 도구 승인
- 에이전트가 셸 명령을 실행하려 할 때, 실행 전에 “이 명령이 되돌릴 수 없는 동작인가”를 Noul로 묻는다
- 확률이 높으면 막고 사람에게 묻는다. 12주차의 책임 있는 AI 이야기와 직접 이어지는 지점이다
○ 7번, 결과 검증
- 나온 답이 근거 문서에 실제로 있는지, 요구한 형식을 지켰는지를 확인한다
- 이 확인을 LLM에게 시키면(LLM-as-judge) 느리고 비싸다. 5주차에서 다시 본다
□ 한 문장
- 생각은 LLM이 하고, 갈림길은 결정 모델이 고르고, 실행은 코드가 한다
제주 사례로 바꿔 보기
Section titled “제주 사례로 바꿔 보기”□ 문의 한 건이 흘러가는 길
- 앞에서 쓴 문의를 끝까지 따라가 보자
성산일출봉 주차장 입구가 막혀서 30분째 못 들어가고 있습니다.예약한 입장권 환불도 알아보고 싶어요.- 한 번의 호출로 네 가지를 묻는다. 결과는 이렇다고 하자 (수치는 설명용 예시다)
| 질문 | 유형 | 답 | 확신도 |
|---|---|---|---|
| 분류 | Choice | 주차 (주차 0.62, 요금 0.28, 시설 0.10) | 0.43 |
| 긴급 | Noul | 0.88 | - |
| 심각도 | Score | 1.6 (0단계 0.10, 1단계 0.20, 2단계 0.70) | 0.55 |
| 환불요청 | Noul | 0.31 | - |
□ 코드가 내리는 결론
분류 = response.answers["분류"]긴급 = response.answers["긴급"]
if 긴급.noul > 0.8:    현장_담당자_호출(ticket_id)          # 0.88 이므로 실행된다
if 분류.confidence > 0.85: 자동_배정(ticket_id, 분류.choice)else: 사람_검토함으로(ticket_id) # 0.43 이므로 이쪽이다- 긴급 대응은 즉시 나가고, 부서 배정은 사람이 본다. 하나의 문의에서 확신하는 판단과 못 하는 판단이 갈린 것이다
- 그리고 이 문의는 앞에서 본 판단 오류의 후보다. 실제 용건은 환불일 수 있는데 분류는 주차로 나왔고, 환불요청 Noul도 0.31로 낮다
- 확신도 0.43이 그 위험을 잡아 사람 검토로 보냈다. 판단이 틀릴 수 있다는 전제 위에서 설계했기 때문에 살아난 것이다
□ 만약 확신도를 무시했다면
분류.choice만 읽고 바로 배정했다면 이 문의는 주차 담당에게 갔을 것이다. 형식 오류는 하나도 없이, 조용히 틀린 채로
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. 결정 모델이 LLM보다 좋은 모델인가?
좋고 나쁨의 문제가 아니라 할 수 있는 일이 다르다. Jev는 글을 한 줄도 못 쓴다. 요약, 답장, 번역, 코드, 설명이 전부 불가능하다.
앞의 벤더 공개 표에서도 정확도가 가장 높은 것은 대형 LLM B였다. 결정 모델의 강점은 정확도가 아니라 비슷한 정확도를 훨씬 싸고 빠르게 낸다는 데 있다.
Q2. 4주차에서 배운 프롬프트 분류와 무엇이 다른가?
노리는 결과는 같다. 방식이 다르다.
4주차 방식은 LLM에게 라벨을 이어 쓰게 하고, 그 확률표를 우리가 열어서 읽었다. 실습 노트북에서 label_scores() 로 한 일이 그것이다.
결정 모델은 그 읽기를 모델 쪽 기본 동작으로 만든 것이다. 그래서 목록 밖의 답이 나올 자리가 없고, 여러 질문을 한 번에 물을 수 있고, 확신도가 보정된 값으로 나온다.
이 특강의 노트북에서 4주차 방식으로 결정 모델의 세 유형을 흉내 내 본다. 둘이 같은 뿌리라는 것을 손으로 확인하게 된다.
Q3. 확률이 붙어 있으면 그게 곧 정답 확률인가?
그렇게 되도록 훈련했다는 것이 벤더의 주장이고, 그것이 보정이다. 하지만 내 과제에서도 보정돼 있는지는 재 봐야 안다.
재는 방법은 간단하다. 확신도 구간별로 나눠서 구간마다 정확도를 세면 된다. 0.9 이상 구간의 정확도가 0.9 근처면 보정된 것이고, 0.6이면 아니다.
실습 노트북 5번 셀이 이 계산을 한다.
Q4. 환각이 불가능하다면 검증이 필요 없지 않나?
불가능한 것은 형식 오류뿐이다. 목록 밖의 답은 안 나오지만, 목록 안의 틀린 답은 얼마든지 나온다.
벤더 자신의 벤치마크 정확도가 67.8%다. 열 건 중 세 건은 형식이 멀쩡한 채로 틀렸다는 뜻이다. 검증은 오히려 더 중요해진다. 눈에 띄는 오류가 사라졌기 때문이다.
Q5. 그럼 우리 과제에 당장 도입해야 하나?
대개는 아니다. 앞의 세 조건을 다시 본다. 의미 판단이 필요하고, 답 후보가 정해지고, 아주 많이 반복돼야 한다.
한 달에 수백 건 처리하는 과제라면 비용 차이가 몇 달러다. 도입해서 얻는 것보다 의존성 하나가 늘어나는 비용이 크다.
이 특강에서 가져갈 것은 도구가 아니라 구분하는 눈이다. “이 일은 글이 필요한 일인가, 갈림길만 고르면 되는 일인가”
스스로 점검
Section titled “스스로 점검”- Jev가 출력 토큰에 과금하지 않는 이유를 한 문장으로 말해 보자
- Choice 확률이 주차 0.50, 요금 0.30, 시설 0.20일 때 확신도를 계산하고, 0.85 / 0.60 임계값 중 어디로 갈리는지 말해 보자
- 스키마 오류와 판단 오류의 차이를 제주 문의 예로 들어 설명해 보자
- 아래 세 과제를
if문 / 결정 모델 / LLM 중 어디에 배정할지 고르고 이유를 말해 보자- 문의 본문 길이가 500자를 넘는지 판단
- 검색된 문단이 질문에 답하는지 판단
- 방문객에게 보낼 사과 안내문 작성
- 확신도가 보정돼 있지 않으면 임계값 코드가 왜 위험해지는지 설명해 보자
정답 보기
-
만들어 내는 토큰이 없기 때문이다. 정해 둔 후보에 확률을 매길 뿐 글자를 생성하지 않는다.
-
(3 x 0.50 - 1) / 2 = (1.5 - 1) / 2 = 0.25. 0.60 미만이므로 사람 검토로 간다. 1등이 2등보다 0.20이나 앞섰는데도 확신도는 낮다. -
스키마 오류는 주차/시설/요금 목록 밖의 “환불”이 돌아오는 것이고, 구조적으로 일어나지 않는다. 판단 오류는 실제로는 환불 문의인데 “주차”라는 유효한 라벨이 돌아오는 것이고, 얼마든지 일어난다.
-
길이 판단은
len(text) > 500으로 끝나므로if문이다. 문단이 질문에 답하는지는 의미를 읽어야 하고 답이 참/거짓으로 정해지며 검색 결과마다 반복되므로 결정 모델(Noul)이다. 안내문 작성은 글을 만들어야 하므로 LLM이다. -
임계값 코드는 “확신도가 높으면 실제로 더 자주 맞는다”를 전제로 자동 실행을 허용한다. 보정이 깨져 있으면 모델이 틀린 판단에 높은 확신도를 붙일 수 있고, 그러면 자동 실행 구간이 오히려 오류를 그대로 통과시키는 통로가 된다.
| 용어 | 한 줄 뜻 |
|---|---|
| 결정 모델 | 글을 만들지 않고 정해 둔 후보에 확률을 매겨 돌려주는 모델 |
| 시스템 1 모델 | 결정 모델의 다른 이름. 카너먼의 빠른 판단 비유에서 온 말 |
| 상태(state) | 판단에 필요한 재료를 모아 모델에 넣는 입력 덩어리 |
| Choice | 목록에서 하나를 고르는 질문 유형. 후보 최대 255개 |
| Score | 순서가 있는 2에서 10단계 눈금 위의 위치를 돌려주는 질문 유형 |
| Noul | 이 문장이 참일 확률을 0에서 1로 돌려주는 질문 유형 |
| 확신도(confidence) | 확률이 한쪽에 얼마나 몰렸는지를 0에서 1로 요약한 값 |
| 보정(calibration) | 0.9라고 말한 판단이 실제로 열 번에 아홉 번 맞는 성질 |
| 스키마 오류 | 정해 둔 답 목록 밖의 값이 돌아오는 오류. 결정 모델에서는 일어나지 않음 |
| 판단 오류 | 목록 안의 유효한 값이지만 내용이 틀린 오류. 그대로 일어남 |
| fan-out | 한 상태에 여러 질문을 한꺼번에 던져 병렬로 답을 받는 방식 |
| 모델 라우팅 | 요청마다 어느 모델로 보낼지 미리 고르는 일 |
□ 출처
- 질문 유형, 확신도 식, 임계값 권고, SDK 사용법: TypeSafe AI 공식 문서(
docs.typesafe.ai) - 가격, 응답 시간, RLCD, 벤치마크 수치: TypeSafe AI 공개 소개 글 및 이를 정리한 기술 매체 기사
- 벤치마크 표는 벤더가 공개한 값이며 독립 재현이 아니다. 시스템 A, B의 실제 제품명은 원 출처에 있다
- 본문의 제주 문의 확률값은 모두 설명용 예시다. 실제 측정값이 아니다
실습 노트북
Section titled “실습 노트북”
API 키 없이 돌아간다. 4주차에서 쓴 작은 한국어 모형의 다음 토큰 확률만 가지고 Choice, Score, Noul 세 유형을 손으로 만들어 보고, 제주 관광 문의 24건에 대해 확신도 구간별 정확도를 직접 재 본다. 보정이 말이 아니라 측정 가능한 성질이라는 것을 눈으로 확인하는 것이 목표다.