
4주차: 프롬프트와 문맥학습의 원리
프롬프트와 문맥학습의 원리
□ 이 주차가 놓이는 자리
- 3주차에서는 가중치를 바꾸는 길을 봤다. LoRA처럼 작은 부품만 붙여도 파라미터는 조금이라도 갱신됐다. 이번 주의 질문은 정반대다. “가중치를 하나도 안 바꾸고 모델의 동작을 바꿀 수 있는가”
- 답은 있다이다. 모델은 그대로 두고 입력(문맥)만 바꾸는 방법이 프롬프트다. 그리고 문맥 안에 예시를 몇 개 넣어 주면 모델이 그 예시를 흉내 내 새 입력을 처리하는데, 이것을 문맥학습(in-context learning, ICL) 이라 한다
- 3주차의 비교표를 다시 보자. 이번 주는 세 번째 줄이다
| 방법 | 신입 직원 비유 | 가중치가 바뀌나 | 드는 비용 |
|---|---|---|---|
| 사전학습 | 대학에서 몇 년간 폭넓게 공부하기 | 처음부터 전부 만든다 | 매우 큼 |
| 미세조정 | 입사 후 우리 부서 실무를 따로 교육하기 | 바뀐다 (전부 또는 일부) | 중간 |
| 프롬프트 | 교육 없이 매번 업무 지시서를 자세히 쥐여 주기 | 바뀌지 않는다 | 작음 (대신 매번 입력이 길어짐) |
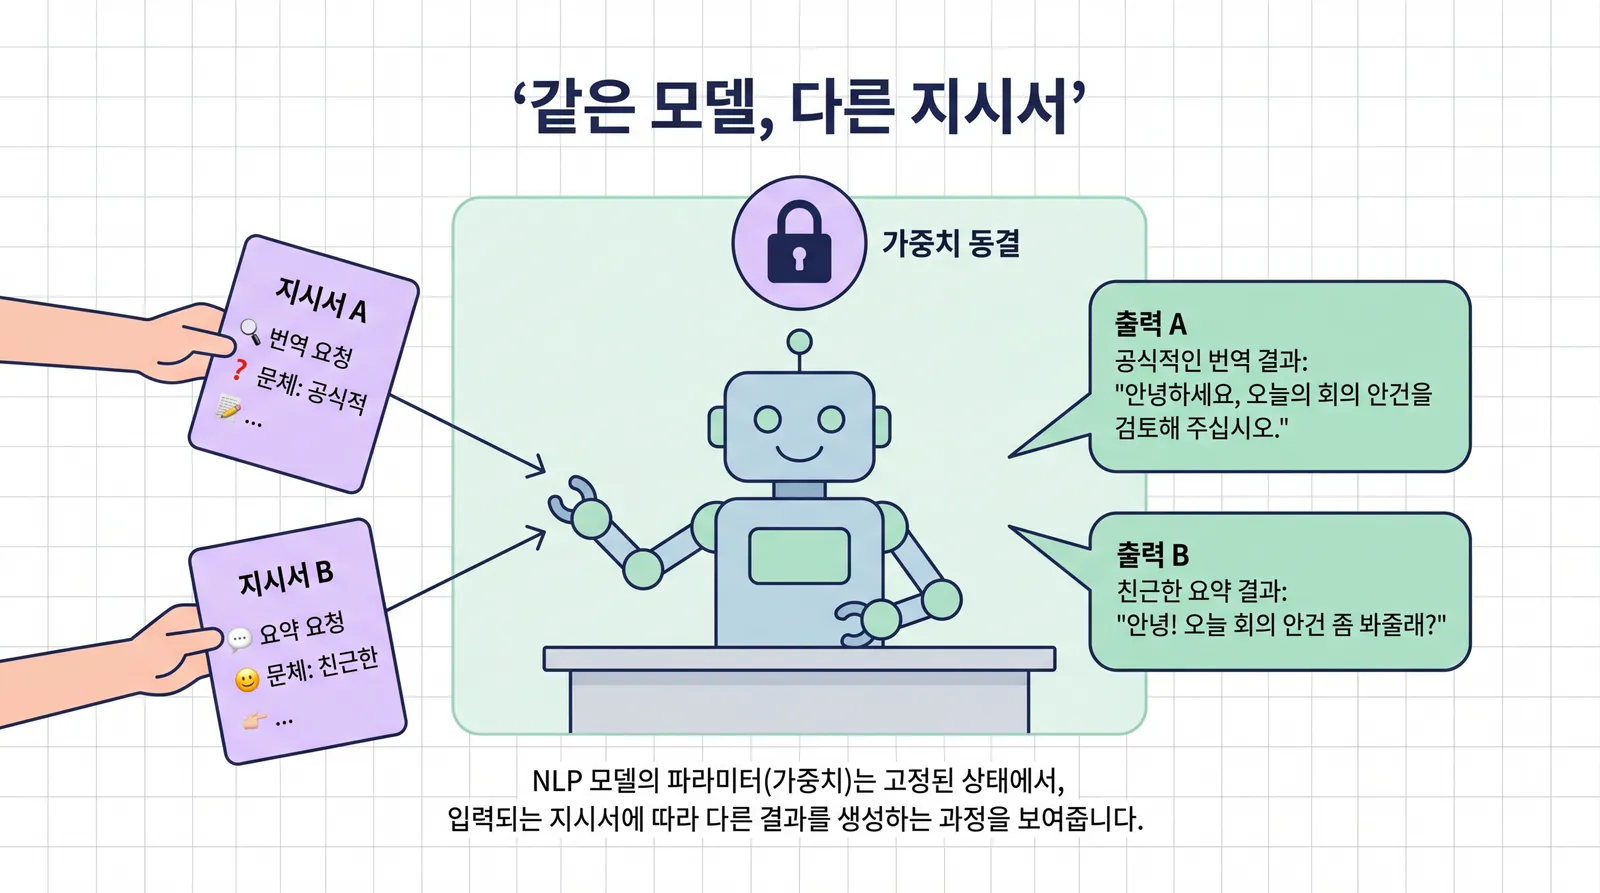
- 비유를 이어 가면, 신입 직원은 교육을 받지 않았지만 지시서가 자세할수록 일을 잘한다. 지시서에 “이전에는 이렇게 처리했습니다”라는 사례가 몇 개 붙어 있으면 더 잘한다. 직원의 머릿속(가중치)은 그대로인데 성과가 달라지는 것이다
□ 미세조정과 프롬프트의 갈림길
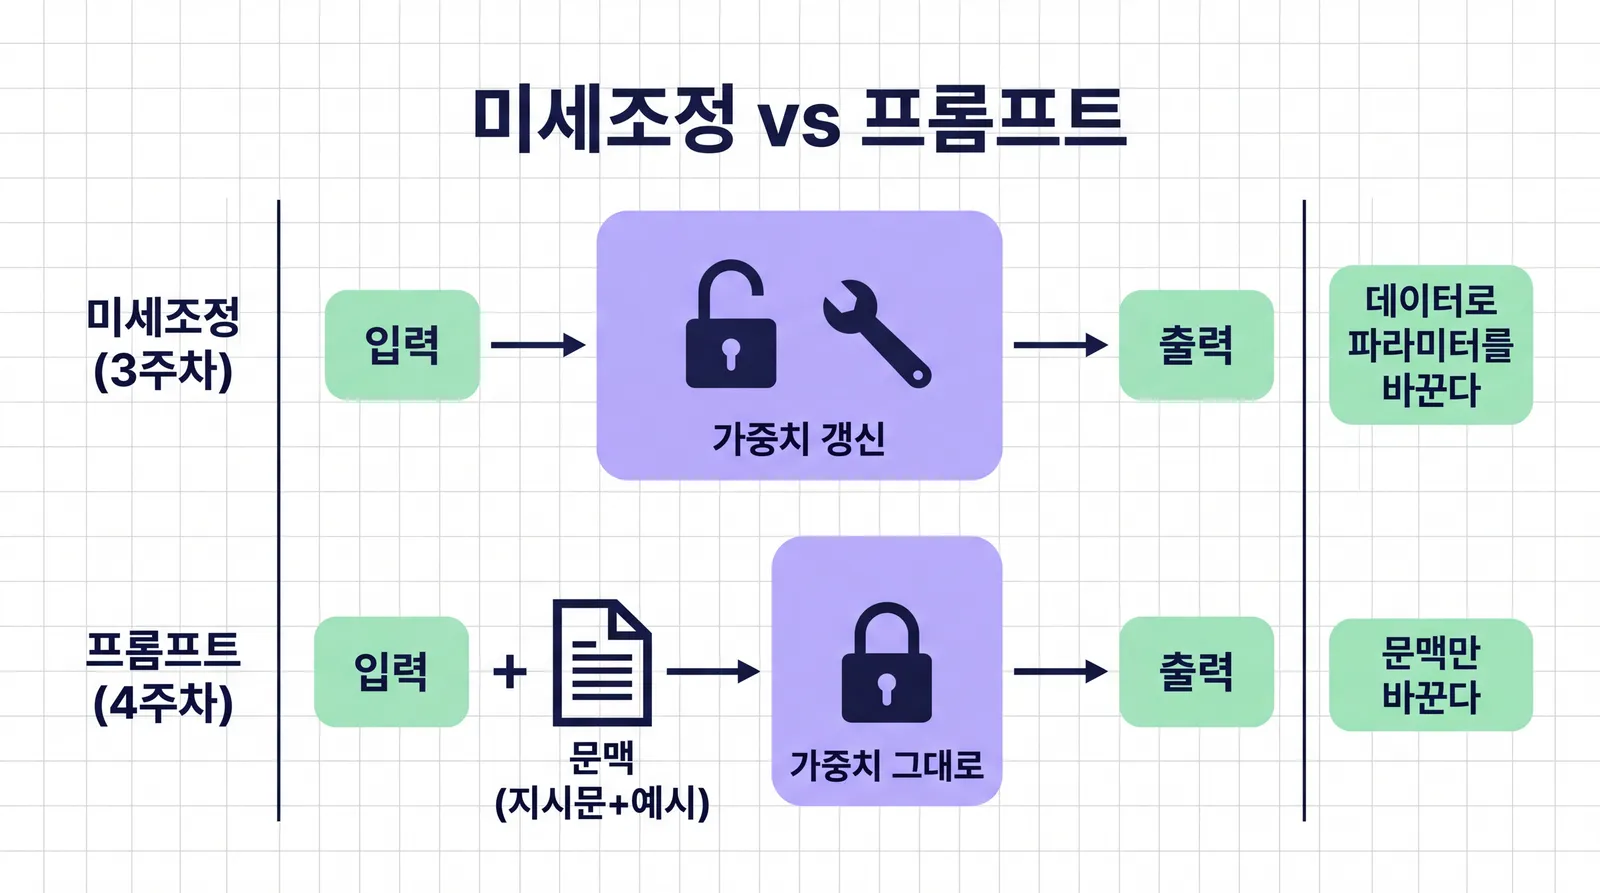
- 위 줄(미세조정)은 모델의 내부를 고친다. 한 번 고치면 그다음부터는 지시서 없이도 바뀐 대로 동작한다
- 아래 줄(프롬프트)은 모델의 입력을 고친다. 모델은 매번 똑같은 상태에서 시작하므로, 지시서를 빼면 원래대로 돌아간다
- 이 차이가 운영에서 중요하다. 미세조정은 “언제 누가 어떤 데이터로 고쳤는가”를, 프롬프트는 “어느 지시서 버전을 썼는가”를 관리한다. 뒤의 점검 항목표가 이 이야기다
온라인 (2시수)
Section titled “온라인 (2시수)”강의: 문맥학습의 원리 - 확률, Few-shot, Chain-of-Thought
Section titled “강의: 문맥학습의 원리 - 확률, Few-shot, Chain-of-Thought”□ 읽기 준비 - 토큰과 확률분포 복습
- 1주차에서 배운 것을 짧게 되짚는다. 모델은 문장을 통째로 읽지 않고 토큰(조각)으로 나눠 읽는다. “제주 관광 문의를 분류합니다”는 대략 “제주”, ” 관광”, ” 문의”, “를”, ” 분류”, “합니다” 같은 조각이 된다
- 모델이 계산하는 것은 조각마다 하나씩, “다음에 올 토큰이 무엇일지”의 확률표다. 후보마다 0에서 1 사이의 수가 붙고, 다 합치면 1이다. 모델은 보통 이 표에서 확률이 높은 토큰을 고른다
- 이 사실 하나가 이번 주 전체의 바탕이다. 프롬프트를 바꾼다는 것은 이 확률표를 만드는 재료(문맥)를 바꾼다는 뜻이기 때문이다
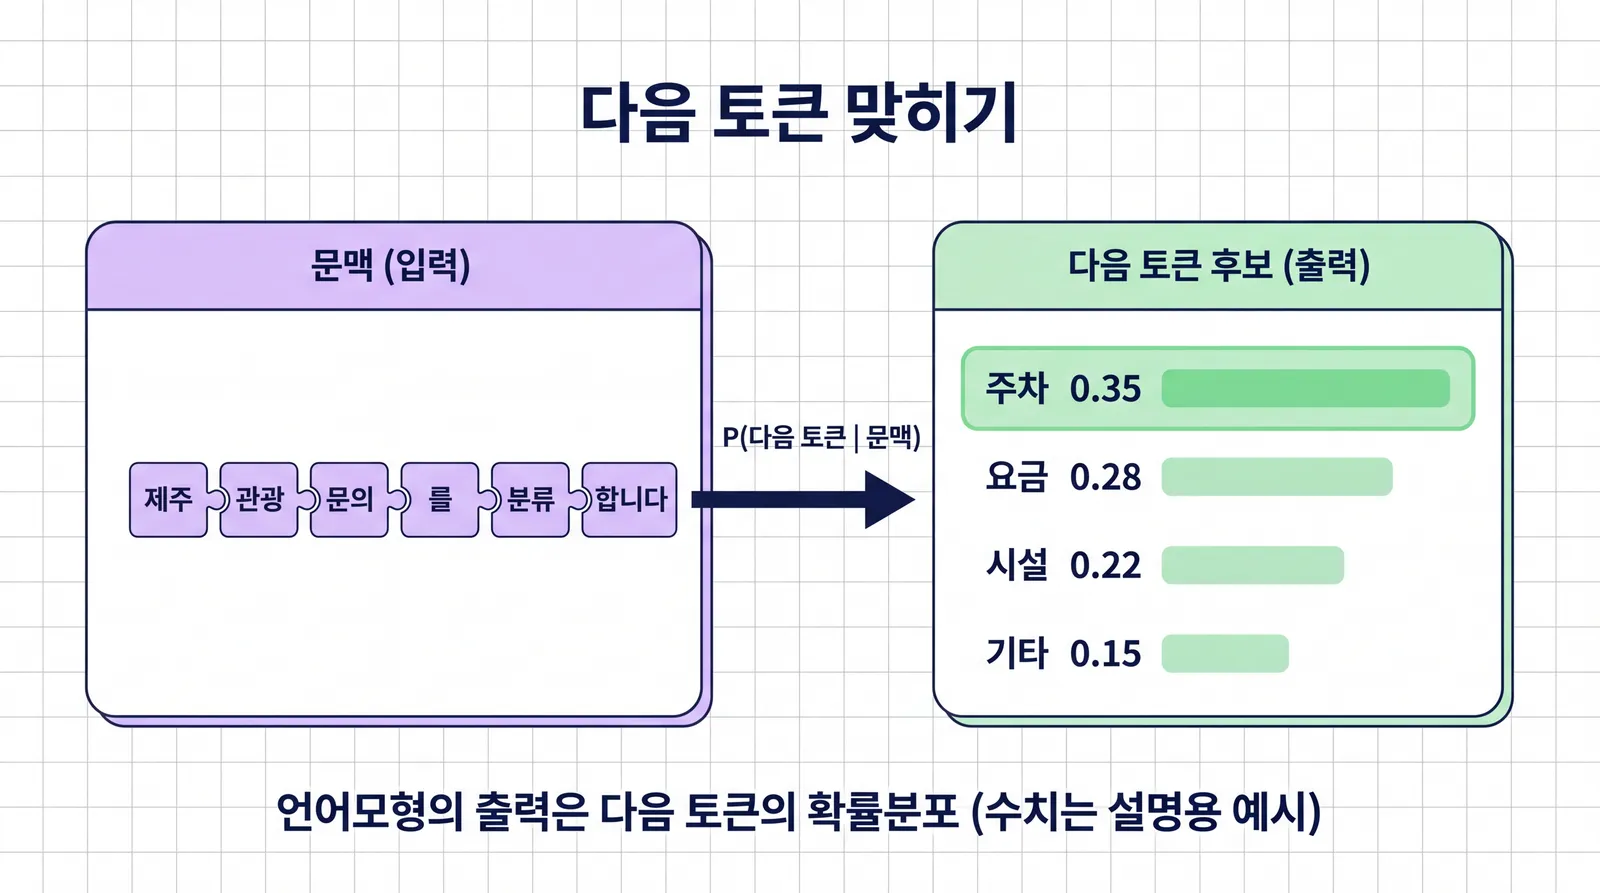
- 확률표 읽는 법: 1위 후보만 보지 말고 2위와의 격차를 본다. 0.35 대 0.28이면 모델은 “주차 쪽이지만 확신이 낮다”는 뜻이다. 뒤에서 프롬프트가 이 격차를 어떻게 벌리는지 본다
□ 언어모형이 하는 일 - 다음 토큰의 확률
- 수식으로는 P(다음 토큰 | 문맥)이다. 세로줄(|)은 “조건”이다. “문맥이라는 조건이 주어졌을 때 다음 토큰의 확률”이라고 읽는다
- 여기서 중요한 사실 하나. 모델이 보는 것은 문맥뿐이라서, 문맥이 달라지면 같은 모델에서도 분포가 달라진다. 가중치는 P를 계산하는 기계일 뿐이고, 기계에 넣는 재료(문맥)가 바뀌면 결과가 바뀌는 것이다
- 분류 과제도 결국 이 형태다. “이 문의는 주차, 시설, 요금 중 무엇입니까?” 다음에 모델이 “주차”라는 토큰에 가장 높은 확률을 두면 그것이 답이다. 분류기를 따로 붙이지 않아도, 다음 토큰 맞히기 하나로 분류가 되는 셈이다
- 다만 여기서 한 가지 의문이 남는다. 답이 셋 중 하나로 정해져 있는데도 토큰을 만들어 내야 하는가? 이 질문은 특강 Jev와 LLM: 결정 모델과 생성 모델에서 따로 다룬다
○ 같은 모델인데 답이 달라지는 이유 - 작은 수치 예
- 손으로 읽을 수 있는 장난감 수치로 보자. 완성할 문장은 “이 표현은 아주 ___” 이고, 후보 토큰은 네 개다 (수치는 설명용 예시다)
| 문맥 | 좋다 | 멋지다 | 어렵다 | 싫다 | 최대 확률 |
|---|---|---|---|---|---|
| A: 예시 없음 | 0.40 | 0.25 | 0.20 | 0.15 | 좋다 |
| B: 방언 불평 예시 2개 추가 | 0.10 | 0.08 | 0.12 | 0.70 | 싫다 |
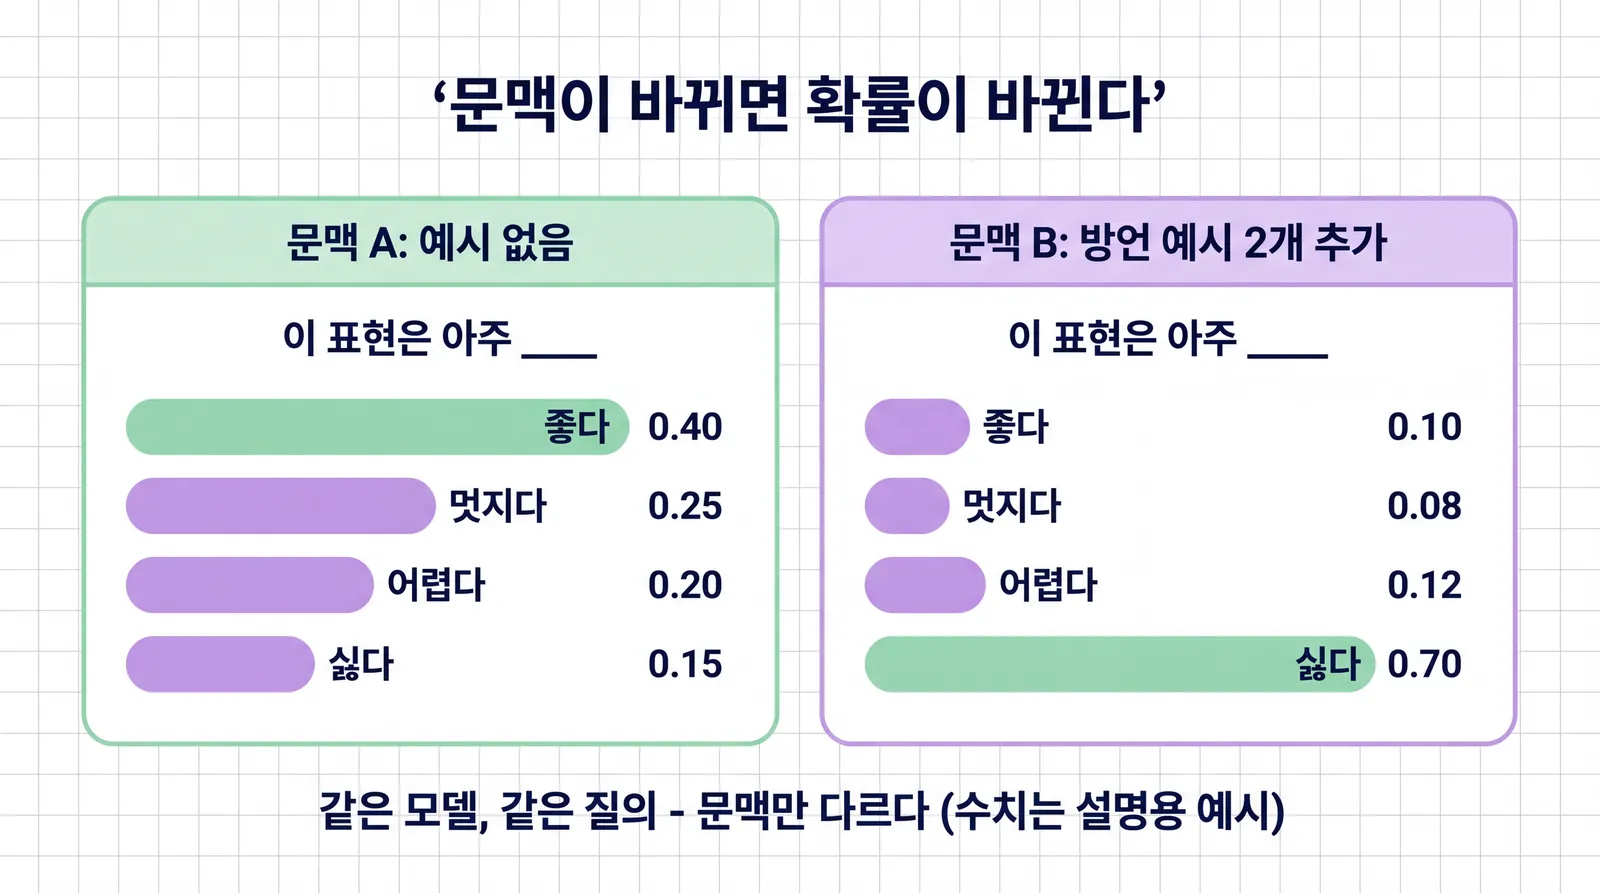
아래 애니메이션은 같은 차트가 문맥 A와 문맥 B 사이를 오가는 모습이다. 막대 길이가 바뀌는 것이 곧 확률표가 바뀌는 것이다.
이 표현은 아주 ___
문맥 A: 예시 없음
같은 모델, 같은 질의 - 문맥만 다르다 (수치는 설명용 예시)
- 모델도, 질의도 같다. 문맥만 다르다. 그런데 확률 1위가 “좋다”에서 “싫다”로 뒤집혔다. 문맥 B에 넣은 예시 두 개(“식당이 아주 비싸요 -> 불만”, “줄이 아주 길어요 -> 불만”)가 “아주 뒤에는 불만이 온다”는 패턴의 재료가 됐기 때문이다
- 이것이 “파라미터 갱신 없이 문맥만으로 동작이 달라지는 이유” 의 확률적 답이다. 학습(가중치 갱신)은 오래 걸리지만, 문맥 교체는 즉시 분포를 바꾼다
- 한계도 같은 그림에서 보인다. 모델은 문맥의 패턴을 흉내 낼 뿐, 문맥이 옳다고 믿는 것이 아니다. 잘못된 예시를 넣으면 잘못된 패턴을 그대로 흉내 낸다
□ 프롬프트의 해부 - 지시문, 예시, 질의
- 프롬프트는 던지는 말 전부가 아니라, 역할이 다른 세 덩어리로 나뉜다
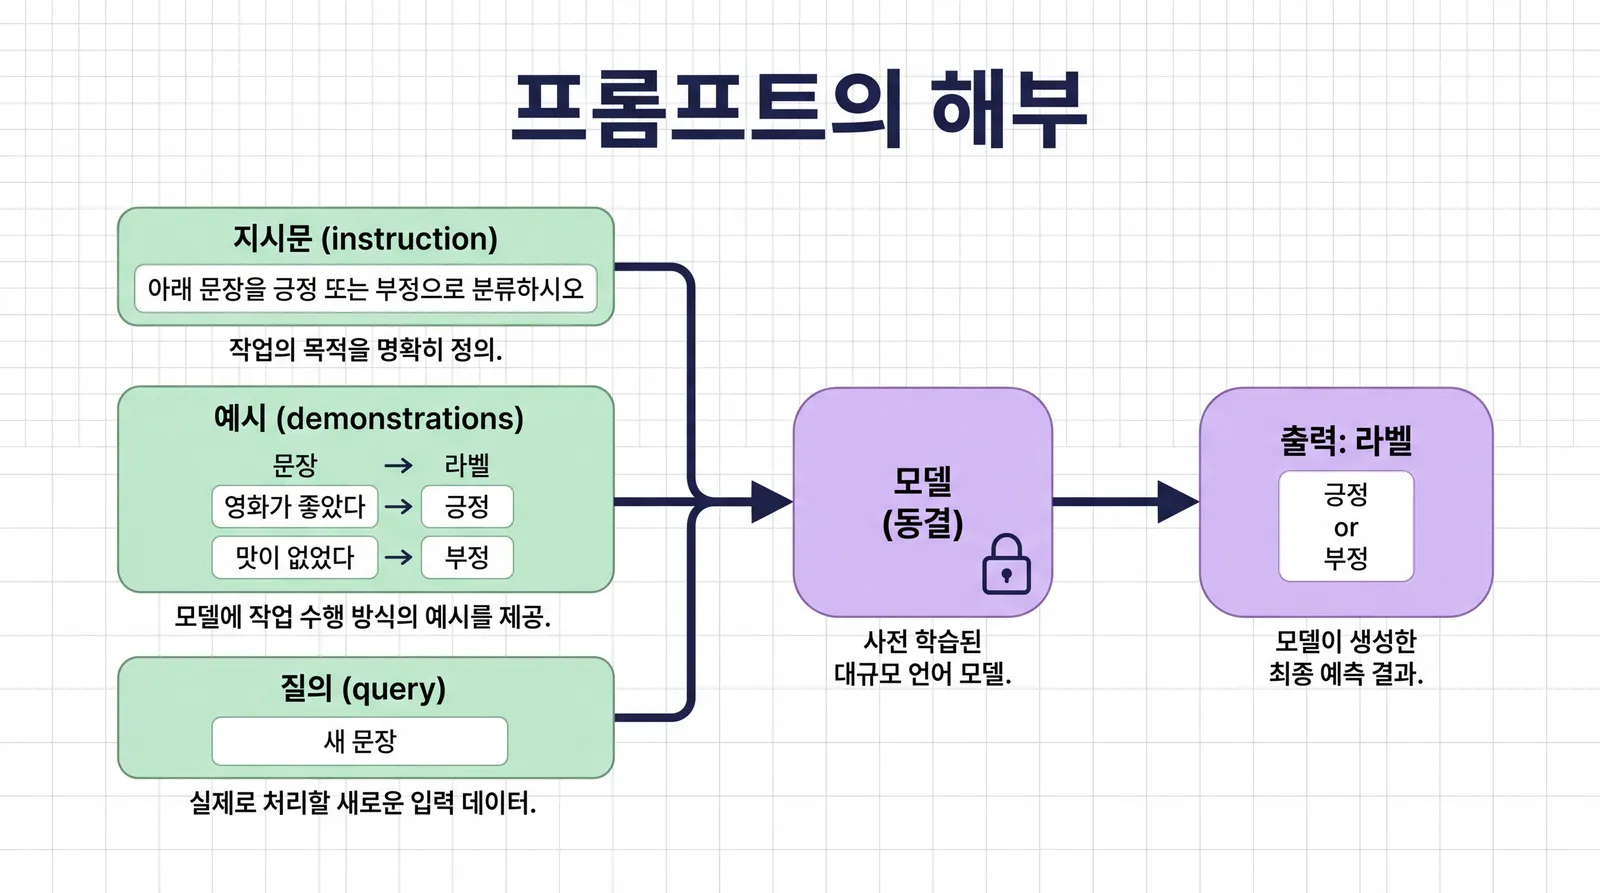
| 덩어리 | 역할 | 신입 직원 비유 |
|---|---|---|
| 지시문 (instruction) | 과제를 정의한다. 무엇을, 어떤 형식으로 | “이 서류는 이렇게 처리하세요” |
| 예시 (demonstrations) | 입력과 출력의 쌍으로 관례를 보여 준다 | “지난번엔 이렇게 처리했습니다” |
| 질의 (query) | 지금 처리할 실제 입력 | 오늘 치 서류 |
- 지시문만 있으면 zero-shot, 예시가 붙으면 few-shot이다. 같은 과제라도 이 덩어리들을 어떻게 조합하느냐에 따라 성적이 갈린다. 이것이 이번 주 학습활동(3가지 프롬프트 비교)의 설계도다
○ 실제 프롬프트 전문 보기 - 제주 관광 문의 분류
- 말로만 본 세 덩어리를 실제 프롬프트로 확인한다. 과제는 제주 관광 문의를 주차, 시설, 요금으로 분류하는 것이다. 이번 주 학습활동은 이 세 가지를 그대로 돌려 보고 결과를 기록하는 것이다
프롬프트 A (지시문만, zero-shot):
아래 제주 관광 문의를 주차, 시설, 요금 중 하나로 분류하시오.라벨만 답하시오.
문의: 성산일출봉 입장료가 얼마예요?라벨:
프롬프트 B (예시 2개 추가, few-shot):
아래 제주 관광 문의를 주차, 시설, 요금 중 하나로 분류하시오.라벨만 답하시오.
문의: 함덕해수욕장 주차장이 어디예요?라벨: 주차
문의: 오름 입장료 할인이 있나요?라벨: 요금
문의: 성산일출봉 입장료가 얼마예요?라벨:
프롬프트 C (예시는 같고 지시문·서식이 함께 다름):
[과제] 제주 관광 문의 분류 (주차/시설/요금)
Q: 함덕해수욕장 주차장이 어디예요?A: 주차
Q: 오름 입장료 할인이 있나요?A: 요금
Q: 성산일출봉 입장료가 얼마예요?A:- B와 C는 같은 과제·예시 두 개·질의를 쓰지만, 지시문과 서식이 함께 다르다. C는 지시문을 짧게 바꾸고 B의 “라벨만 답하시오.”를 생략하며, 문의/라벨 표기도 Q/A로 바꾼다. 따라서 이 둘의 점수 차이를 서식 하나의 인과 효과로 해석할 수 없다
- 세 프롬프트의 마지막 줄이 “라벨:” 또는 “A:“로 끝나는 것에 주목한다. 모델은 그 바로 다음 토큰으로 라벨을 이어 쓰게 되는데, 이 꼬리가 출력 형식을 강제하는 장치다
□ zero-shot, one-shot, few-shot
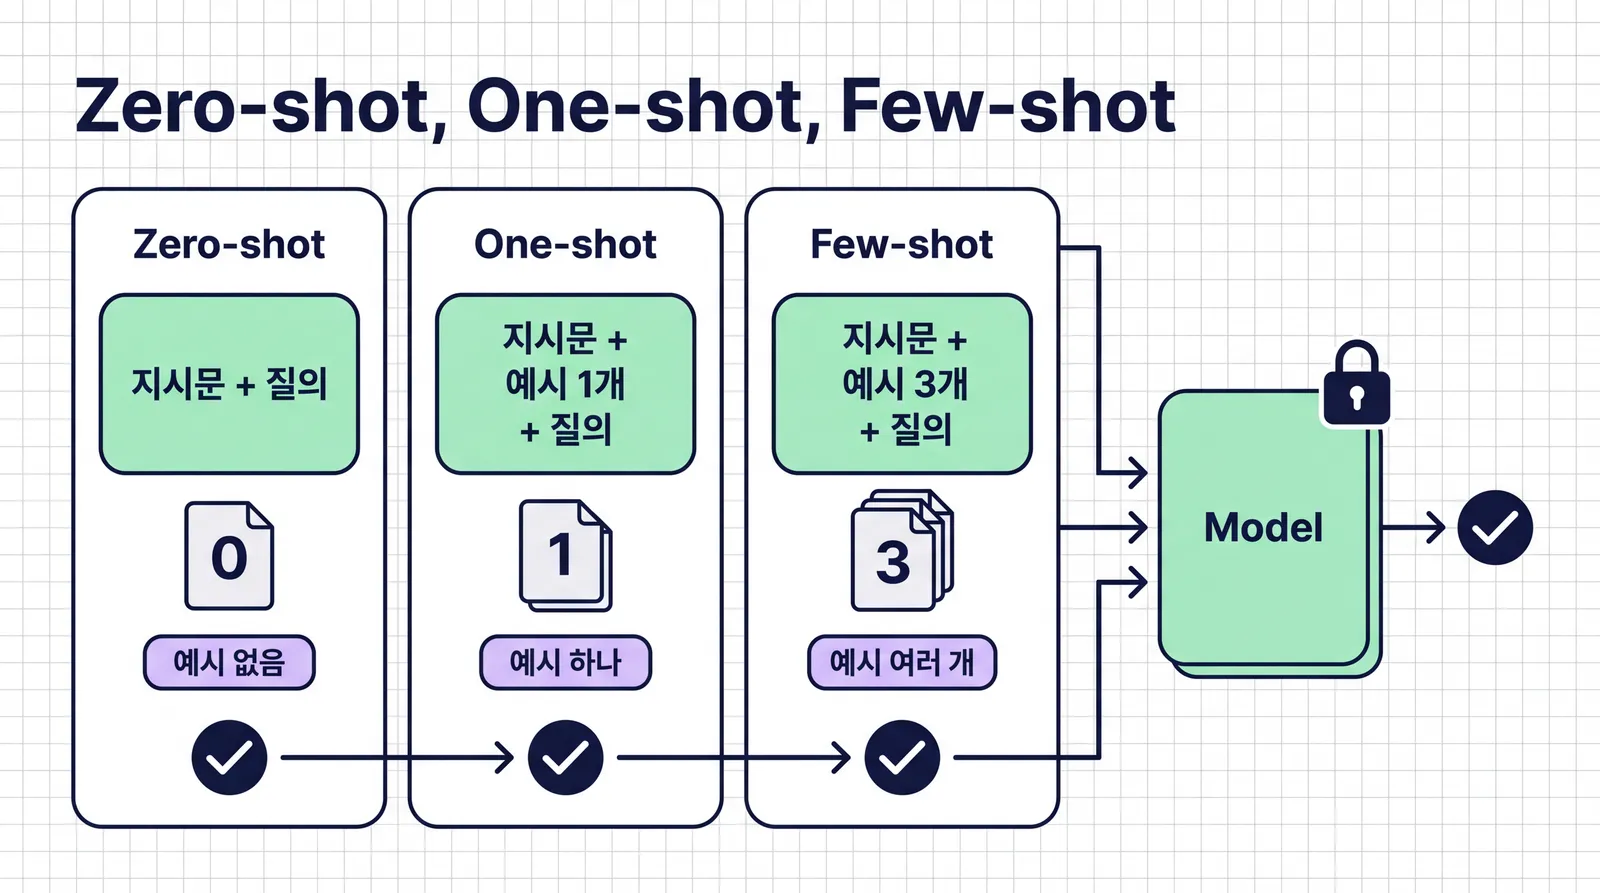
- zero-shot: 예시 없이 지시문만. 방금 본 프롬프트 A다
- one-shot: 예시 하나. 기준을 보여 주는 최소 단위다
- few-shot: 예시 여러 개. 라벨별로 골고루 몇 개씩 보여 준다. 프롬프트 B와 C다
- 이 방식이 주목받은 출발점은 GPT-3 논문(arXiv:2005.14165, 제목이 곧 주장이다: “Language Models are Few-Shot Learners”)이다. 충분히 큰 모델은 가중치 갱신 없이 문맥 안의 예시만으로 새 과제의 패턴을 잡아낸다고 보고했다
- 예시가 하는 일을 비유하면, 채점 기준표를 말로 읽어 주는 대신 채점된 답안지 몇 장을 보여 주는 것이다. 말보다 사례가 기준을 정확히 전달하는 경우가 많다
○ 문맥학습은 왜 되는가
- 모델은 사전학습 동안 수많은 “지시-예시-질의” 형태의 텍스트를 봤다. 문제집, 해답지, 문답 모음 같은 것들이다. 그래서 문맥에 그런 형태가 놓이면, 다음에 올 토큰으로 그 형태의 답을 이어 쓰는 쪽에 확률을 둔다
- 프롬프트 B의 마지막 “라벨:” 다음을 생각해 보자. 문맥은 이미 “문의 -> 라벨” 쌍이 두 번 반복됐다. 이어서 올 가장 자연스러운 토큰은 세 번째 쌍의 라벨이다. 모델이 “요금”에 높은 확률을 두는 것은, 그 자리에 오면 문맥 전체가 자연스러워지는 토큰이기 때문이다
- 즉 문맥학습은 새로운 능력이 아니라, 사전학습이 만든 패턴 인식을 입력 쪽에서 꺼내 쓰는 것이다. 가중치는 사전학습 때 이미 만들어져 있고, 프롬프트는 그 패턴을 부르는 호출문인 셈이다
- 그래서 한계도 명확하다. 사전학습에 비슷한 패턴이 거의 없던 과제(생소한 형식, 드문 언어 현상)에서는 예시를 몇 개 넣어도 잘 안 된다. 그때가 3주차의 길(미세조정)로 가야 할 때다
□ 예시를 고르는 법 - 균형, 대표성, 순서
- few-shot의 성적은 예시를 무엇으로 채우는가에 크게 좌우된다. 고르는 요령 세 가지다
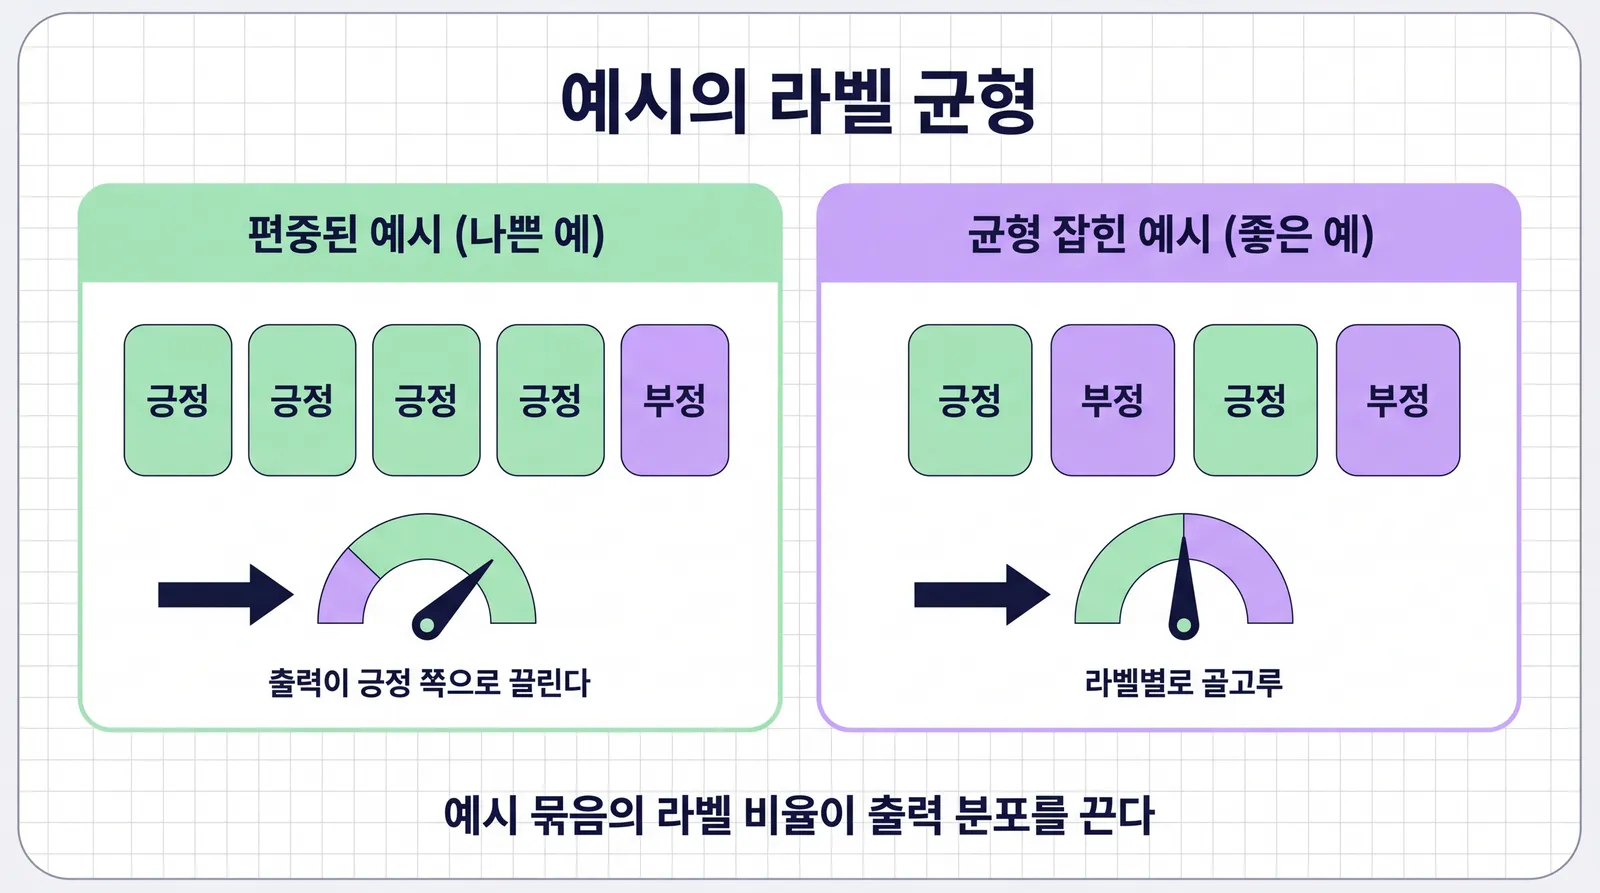
- 첫째, 라벨 균형. 예시 묶음의 라벨 비율이 출력 분포를 끈다. 긍정 예시만 네 개 넣고 부정 하나 넣으면, 모델은 긍정 쪽으로 치우친 답을 내기 쉽다
- 둘째, 대표성. 예시는 실제 운영에서 들어올 입력과 비슷해야 한다. 관광 문의 분류인데 예시가 전부 뉴스 문장이면, 예시가 가르치는 기준이 운영 입력과 어긋난다
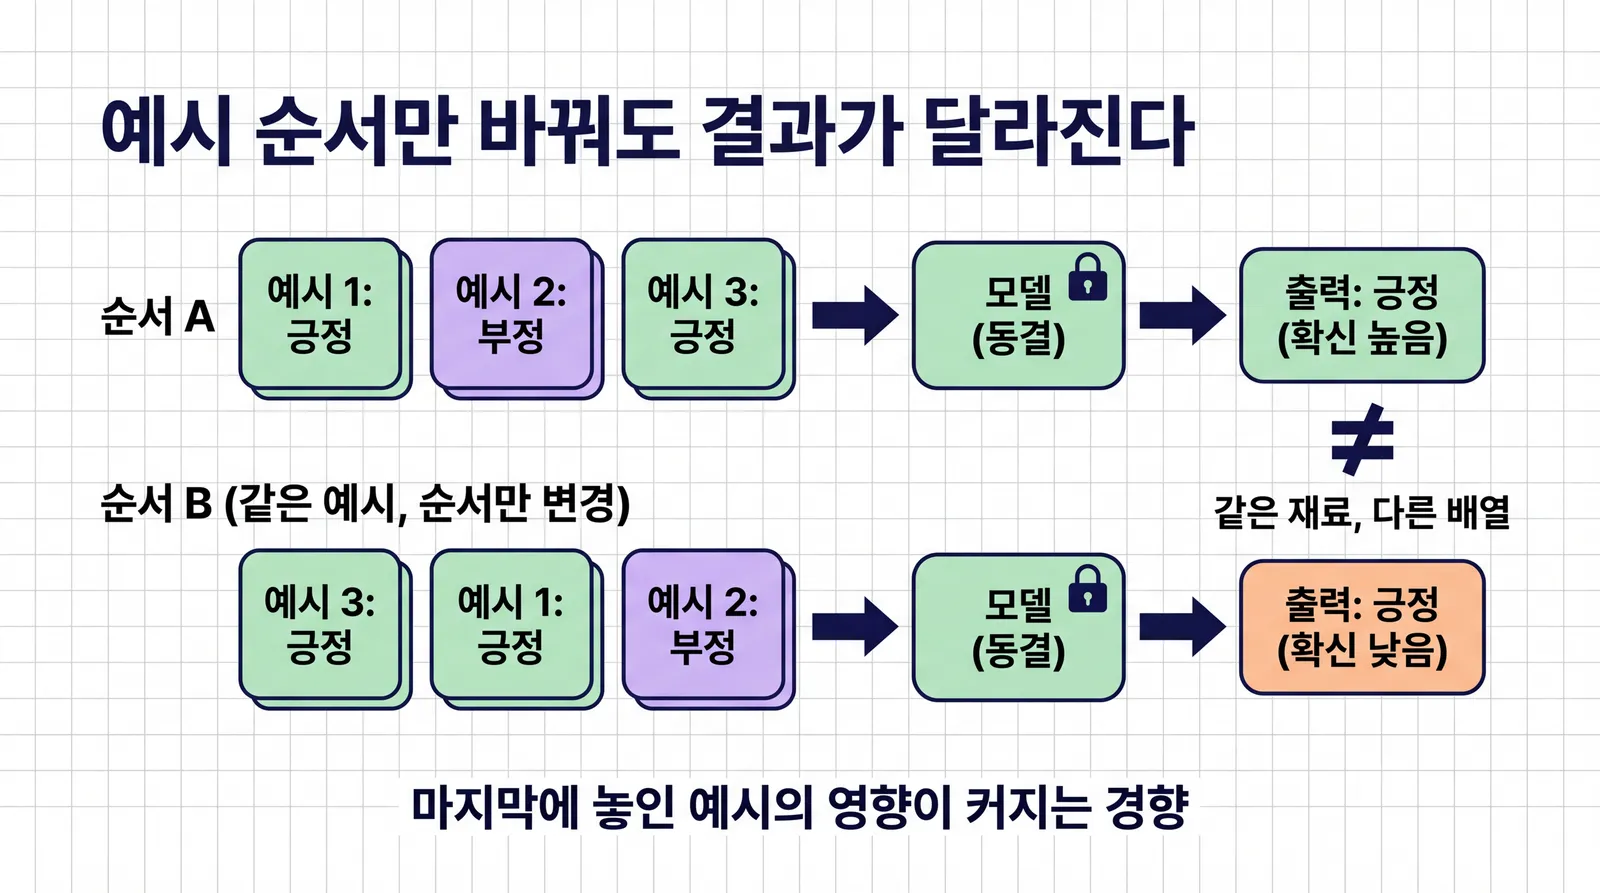
- 셋째, 순서. 모델은 문맥의 마지막 부분 영향을 더 크게 받는 경향이 있다(뒤의 민감성 소절에서 자세히). 같은 라벨이 마지막에 몰리지 않게 섞어 둔다
□ 문맥 창과 비용 - 예시는 공짜가 아니다
- 모델이 한 번에 읽을 수 있는 분량을 문맥 창(context window) 이라 한다. 예시를 늘리면 그만큼 문맥 창을 채우고, 매 호출마다 그 긴 입력을 다시 읽는 비용이 든다
- 장난감 계산으로 감각을 잡아 보자. 지시문이 약 20토큰, 예시 하나(문의 + 라벨)가 약 30토큰, 질의가 약 15토큰이라고 어림하자 (어림이며, 실제로는 토크나이저로 센다)
| 프롬프트 | 계산 | 입력 토큰 어림 |
|---|---|---|
| 지시문만 | 20 + 15 | 35 |
| 예시 2개 | 20 + 60 + 15 | 95 |
| 예시 8개 | 20 + 240 + 15 | 275 |
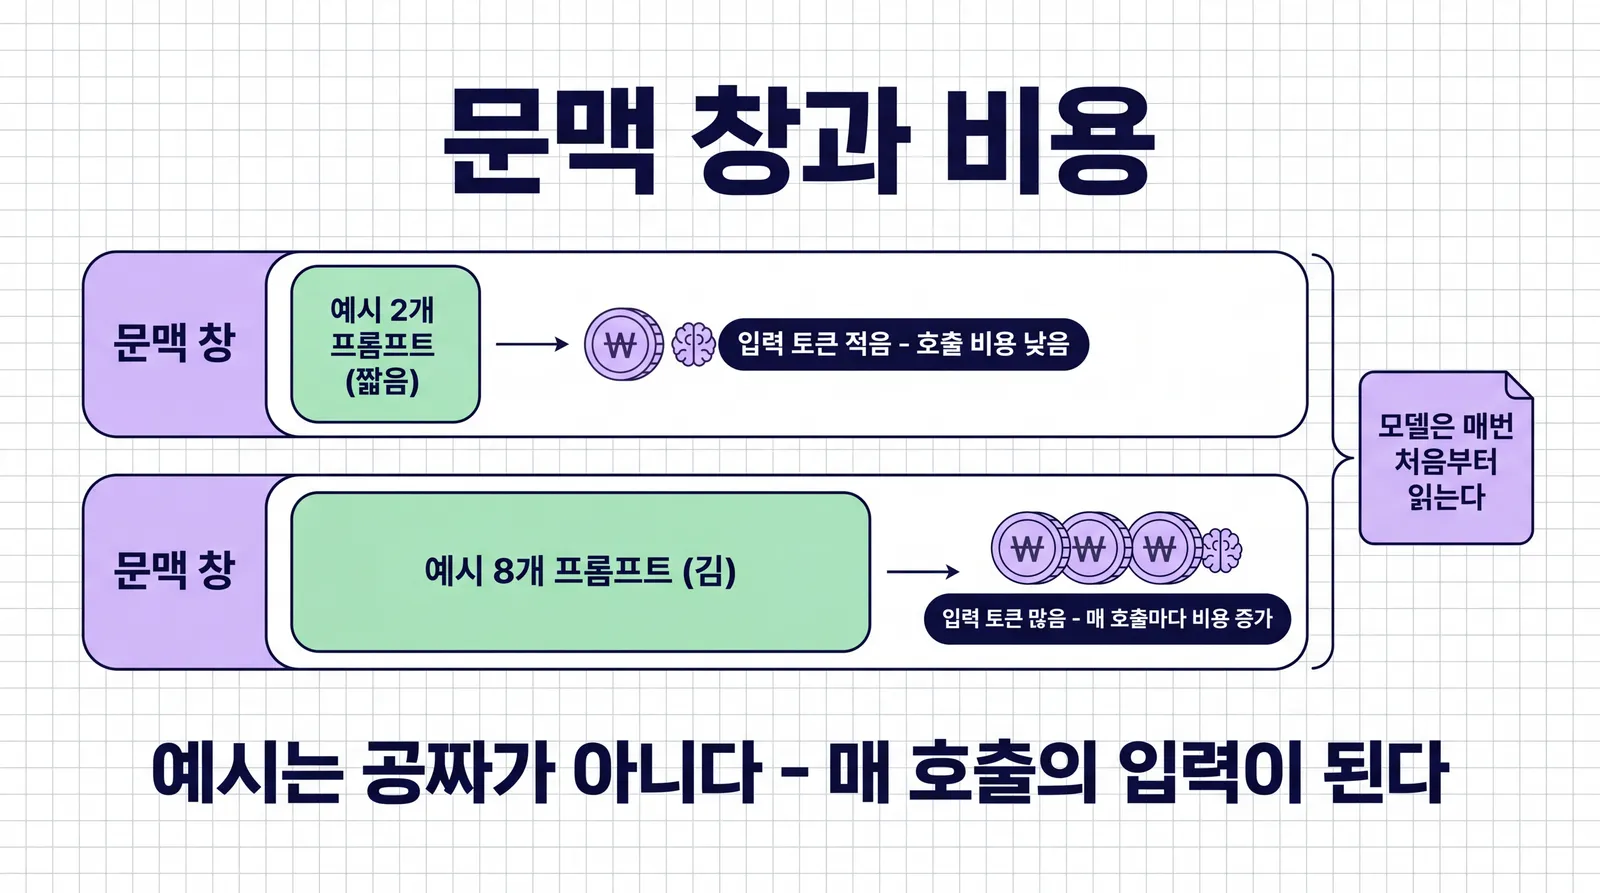
- 예시 8개는 2개의 약 2.9배 입력이다. 문의가 하루 1만 건 들어오는 서비스라면 이 차이는 하루 1만 번 곱해진다. 예시 하나를 더 넣을지는 정확도 이득과 비용을 함께 놓고 정한다
- 기억할 점: few-shot은 미세조정과 달리 “한 번 학습하고 끝”이 없다. 문맥은 매 호출의 입력이므로 사용할 때마다 비용이 반복된다
□ Chain-of-Thought - 중간 단계를 적게 하기
- “거스름돈이 얼마예요?” 같은 문제는 한 번에 답을 내기보다 단계를 밟는 것이 유리하다. 사람도 암산이 안 되면 풀이를 적는다. 모델에게도 그 풀이를 적게 할 수 있다
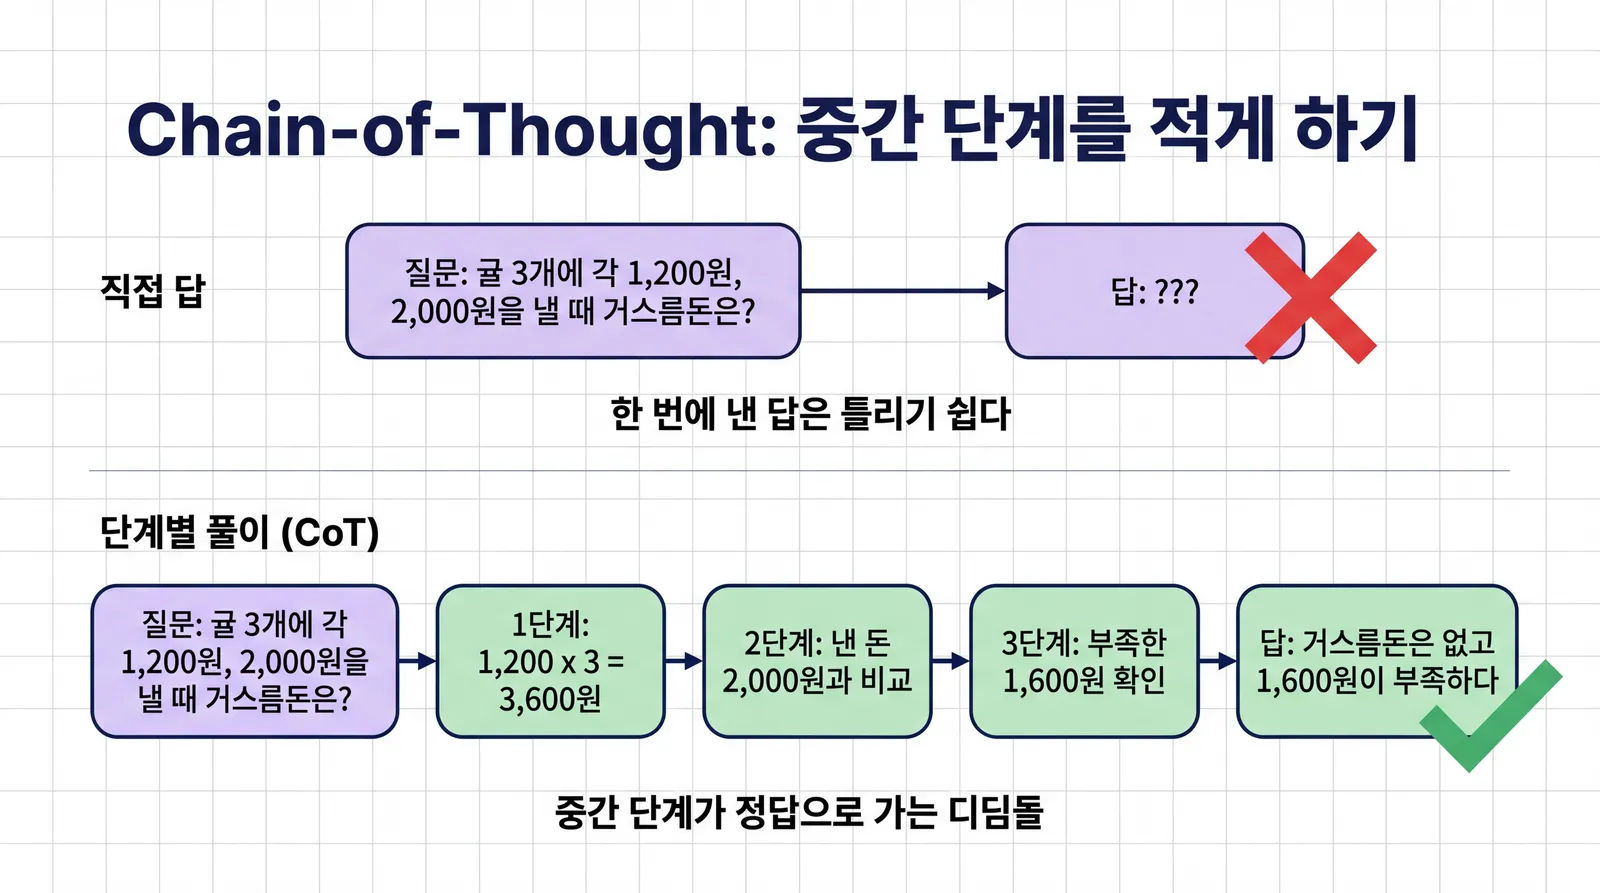
아래 애니메이션은 단계가 차례로 켜지며 정답에 도달하는 과정이다.
2,000원을 낼 때
거스름돈은?
= 3,600원
비교
1,600원 확인
1,600원이 부족하다
중간 단계가 정답으로 가는 디딤돌 - 단계가 문맥에 남아 다음 계산을 돕는다
- 예: 귤이 개당 1,200원일 때 3개를 사고 2,000원을 냈다. 직접 답을 요구하면 모델이 “거스름돈 800원” 같은 그럴듯한 오답을 내는 경우가 있다. 단계를 적게 하면 계산이 드러난다. 1,200 x 3 = 3,600원, 낸 돈은 2,000원, 모자라는 돈은 1,600원. 거스름돈은 없다
- 이 기법이 Chain-of-Thought(생각의 사슬, CoT, arXiv:2201.11903)다. 방법은 둘이다. 예시에 중간 단계를 적어 보여 주거나(few-shot CoT), “단계별로 생각해 보자”는 지시를 붙이거나(zero-shot CoT)
few-shot CoT 프롬프트의 실제 모습:
Q: 귤이 개당 800원일 때 5개를 사고 5,000원을 낼 때 거스름돈은?A: 단계별로 생각한다. 800 x 5 = 4,000원. 5,000 - 4,000 = 1,000원. 답은 1,000원.
Q: 귤이 개당 1,200원일 때 3개를 사고 2,000원을 낼 때 거스름돈은?A: 단계별로 생각한다.- 예시 하나가 “단계를 적는 관례”를 보여 주고, 모델은 새 질문에서 그 관례를 이어 쓴다. zero-shot CoT는 예시 없이 질의 뒤에 “단계별로 생각해 보자.” 한 줄을 붙이는 것이다
- 왜 도움이 되는가. 다음 토큰 확률 관점에서, 중간 결과가 문맥에 명시되면 뒤의 계산은 그 중간 결과를 조건으로 쉽게 이어진다. 3,600원이 문맥에 있으면 “3,600과 2,000 비교”는 한 단계짜리 문제다. 머릿속(가중치)에서 한 번에 계산할 것을 문맥이라는 메모지에 나눠 적는 것이다
○ CoT의 실패 - 연쇄 오류
- CoT의 한계를 정확히 알아야 쓸 수 있다. 적힌 단계는 그럴듯한 문장일 뿐 검증된 계산이 아니다. 단계 하나가 틀리면 그 뒤는 틀린 디딤돌 위를 계속 걷는다
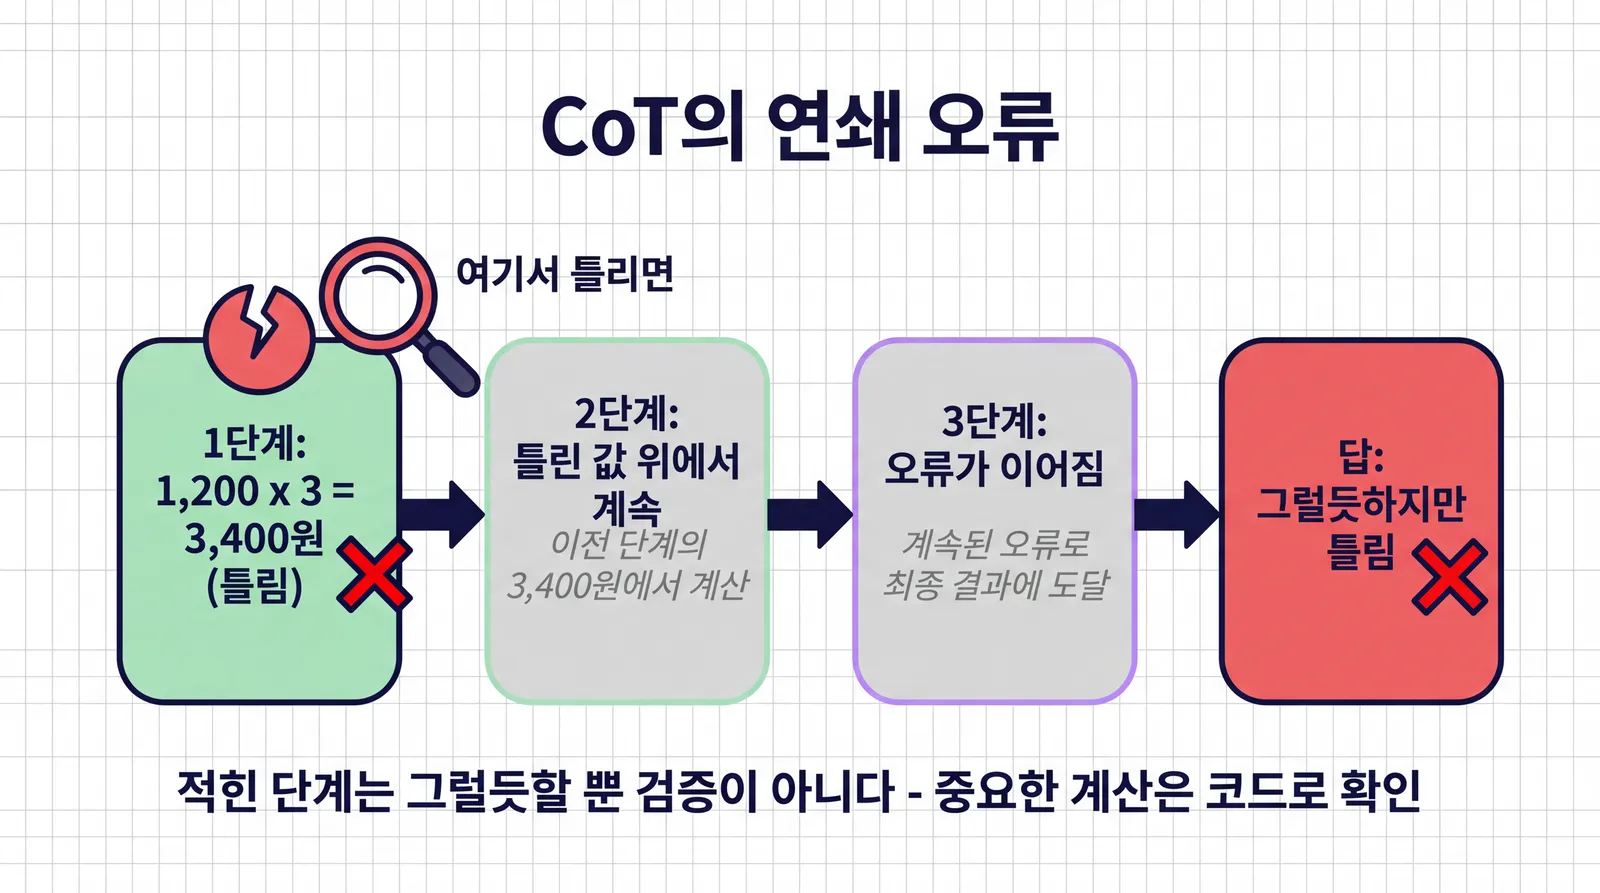
1단계: 1,200 x 3 = 3,400원 <- 여기서 틀림2단계: 낸 돈 2,000원과 비교3단계: 3,400 - 2,000 = 1,400원 부족답: 1,400원이 부족하다 <- 틀린 단계 위의 "정확한" 계산- 2, 3단계의 계산 자체는 1단계 값 기준으로 맞다. 그래서 겉보기에 그럴듯하다. 잘못은 1단계에 있다
- 그래서 규칙은 이렇다. 중요한 계산은 코드로 다시 확인한다. 모델의 풀이는 초안이지 증명이 아니다. 11주차의 과정 감독이 바로 이 “단계가 맞는가”를 따로 채점하는 이야기다
- 비용 각도의 한계도 있다. 단계가 길어진 만큼 입력과 출력이 길어져 비용과 지연이 는다. 단순 분류처럼 단계가 필요 없는 과제에 CoT를 붙이면 느려지고 비싸질 뿐이다
□ 프롬프트 민감성 - 같은 과제인데 점수가 흔들린다
- 여기까지 읽으면 “좋은 프롬프트 하나를 찾으면 끝”처럼 들린다. 실제로는 같은 내용을 담은 프롬프트끼리도 점수가 크게 갈린다
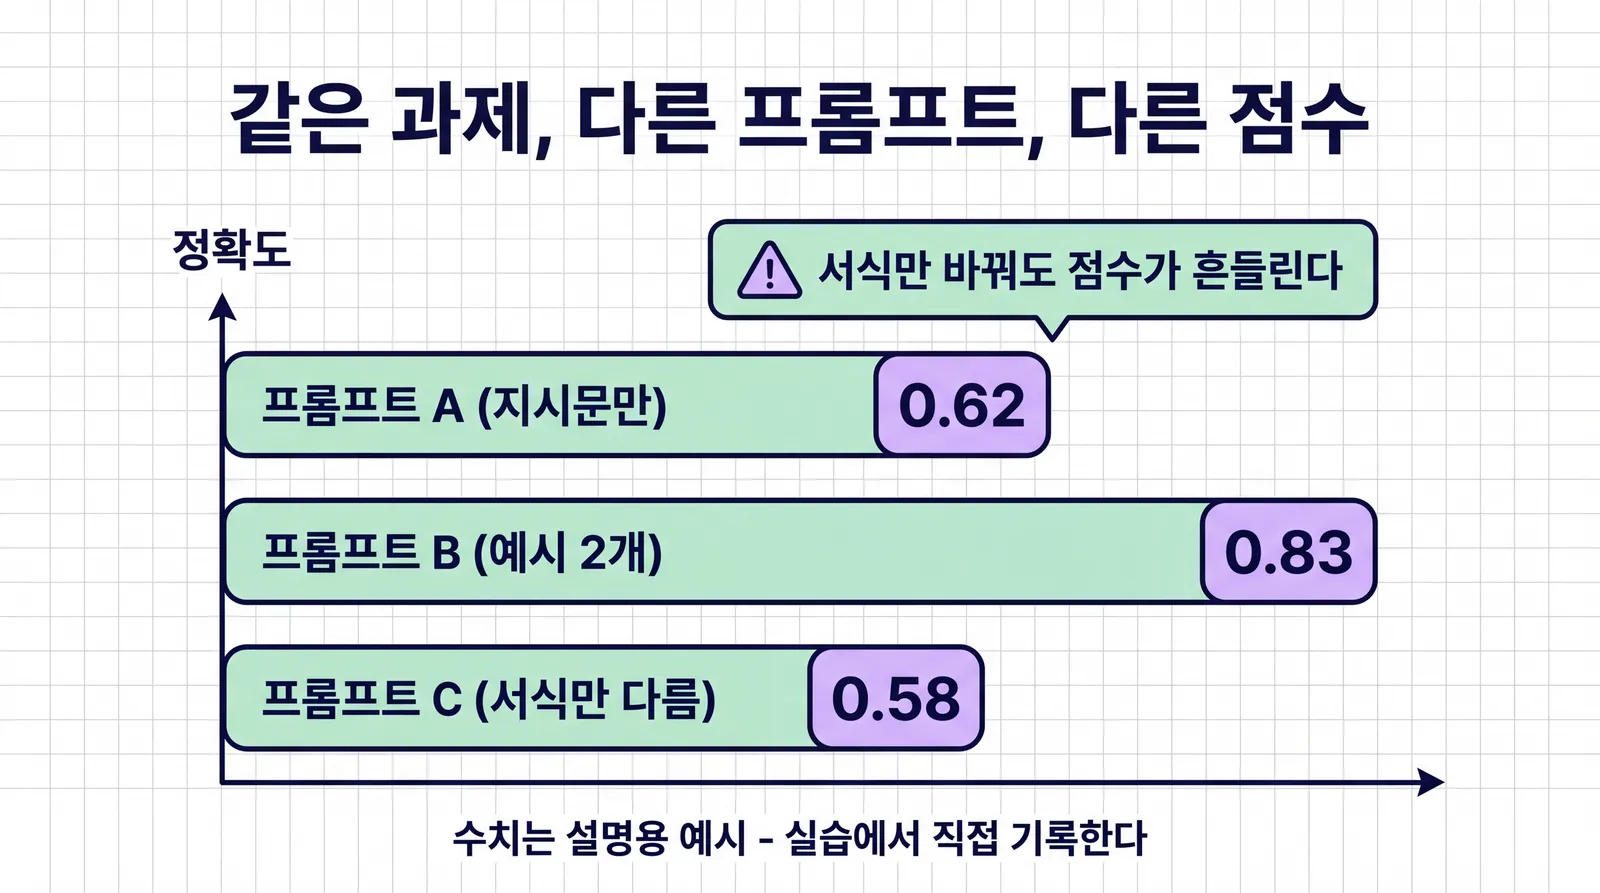
- 위 수치는 설명용 예시다. 원 그림의 “서식만” 표기는 단순화이며, 실제 본문의 B/C는 지시문과 서식의 결합 변경이다. 점수 차이에서 어느 변경이 원인인지 분리할 수 없다. 서식 효과만 평가하려면 지시문·예시·질의를 그대로 두고 서식만 바꾼 추가 대조가 필요하다. 연구들은 서식, 예시 선택, 예시 순서, 라벨 균형이 모두 성능을 흔든다고 보고한다
- 순서 효과는 직관적이다. 모델은 문맥의 마지막 부분의 영향을 더 크게 받는 경향이 있다. 같은 예시 세 개라도 배열을 바꾸면 출력의 확신이 달라진다 (Lu et al., arXiv:2112.04407. 순서만 바꿨을 뿐인데 최상 수준에서 무작위 수준까지 갈린다고 보고했다)
- 실무적 결론: 프롬프트는 “되면 채택”이 아니라 측정해서 고른다. 그리고 측정할 때는 프롬프트 하나만 바꾼다. 3주차에서 랭크 하나만 바꿔 본 것과 같은 요령이다
- 이것이 이번 주 온라인 학습활동의 이론적 근거다. 동일 과제를 3가지 프롬프트로 시도하고 결과 차이를 기록하는 이유가, 차이가 실제로 나고 그 크기가 작지 않기 때문이다
- 앞서 본 프롬프트 A, B, C 전문을 그대로 실행하고, 결과를 표로 기록한다. 기록 양식은 다음과 같다
| 프롬프트 | 달라진 것 | 출력 | 정답 여부 | 비고 |
|---|---|---|---|---|
| A | (기준) | |||
| B | 예시 2개 추가 | |||
| C | 지시문·서식 함께 변경 |
- 기록할 때 “느낌”이 아니라 대조 조건을 적는다. 무엇이 같고(모델, 데이터, 질의) 무엇이 다른가(지시문, 예시 수, 서식)를 한 줄로 쓴다
대면 (1시수)
Section titled “대면 (1시수)”프롬프트 자동 최적화의 원리와 한계 - 무엇이 자동화 가능하고 무엇이 사람 판단으로 남는가
Section titled “프롬프트 자동 최적화의 원리와 한계 - 무엇이 자동화 가능하고 무엇이 사람 판단으로 남는가”□ 자동 최적화 루프
- 프롬프트를 사람이 한 자 한 자 다듬는 대신, 후보를 만들고 채점해서 고르는 일 자체를 프로그램에 맡기는 방법들이 나와 있다
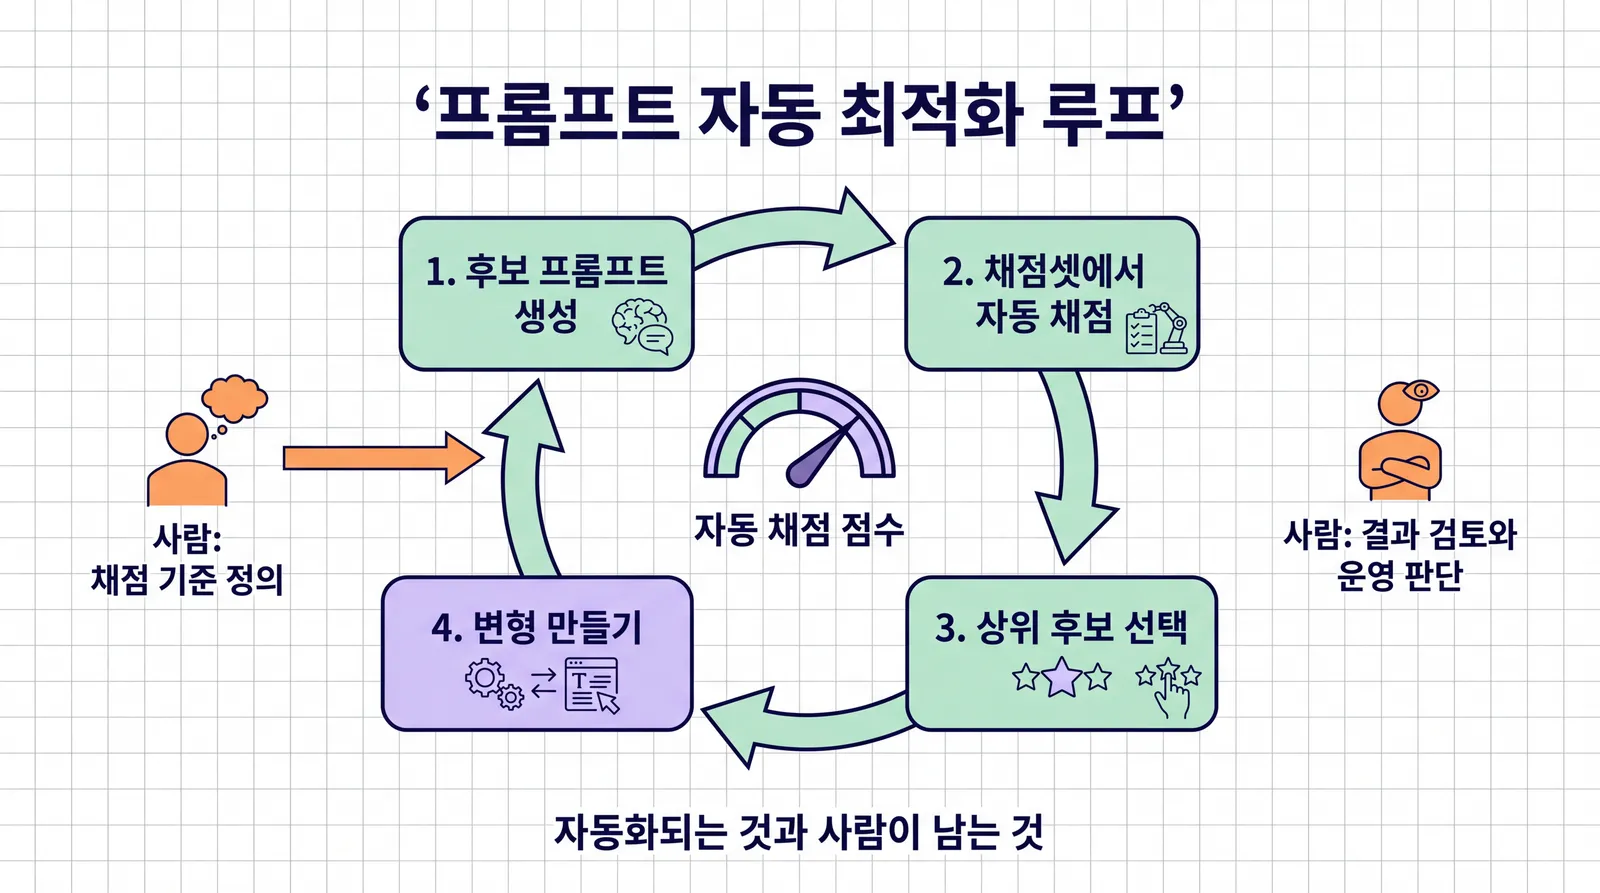
- 1단계, 후보 생성: 언어모형에게 “이 과제의 지시문 후보 10개를 만들어 달라”고 시키거나, 현재 프롬프트의 변형(어순 변경, 예시 교체)을 규칙으로 만든다
- 2단계, 자동 채점: 정답이 있는 채점셋을 돌려 후보별 점수를 매긴다. 정답지가 있으니 채점은 코드가 한다
- 3단계, 상위 선택: 점수가 높은 후보를 고른다
- 4단계, 변형과 반복: 상위 후보를 다시 변형해 루프를 돌린다. 미세조정의 학습 루프(2주차)와 골격이 같다. 다른 점은 갱신하는 것이 가중치가 아니라 프롬프트 텍스트라는 것뿐이다
○ 자동 채점 스크립트의 뼈대
- 2단계가 실제로 하는 일은 단순하다. 의사코드로 본다 (실습에서는 완성된 스크립트를 받아 실행한다)
for prompt in candidates:              # 1단계에서 만든 후보들    correct = 0    for item in eval_set:              # 정답이 있는 채점셋        output = model(prompt + item.sentence)        if output == item.label:            correct += 1    scores[prompt] = correct / len(eval_set)
best = max(scores, key=scores.get) # 3단계: 상위 후보 선택- 이 뼈대가 하는 일은 시험 채점과 같다. 문제(채점셋 문장)를 내고, 답(모델 출력)을 받아, 정답지(라벨)와 맞춰 보고, 점수를 매긴다. 채점이 빠르고 싸니까 후보를 수십, 수백 개 돌릴 수 있다
- 학습활동 [구현]에서는 이 스크립트에 프롬프트를 하나 더 넣어, 순위표가 어떻게 바뀌는지 본다
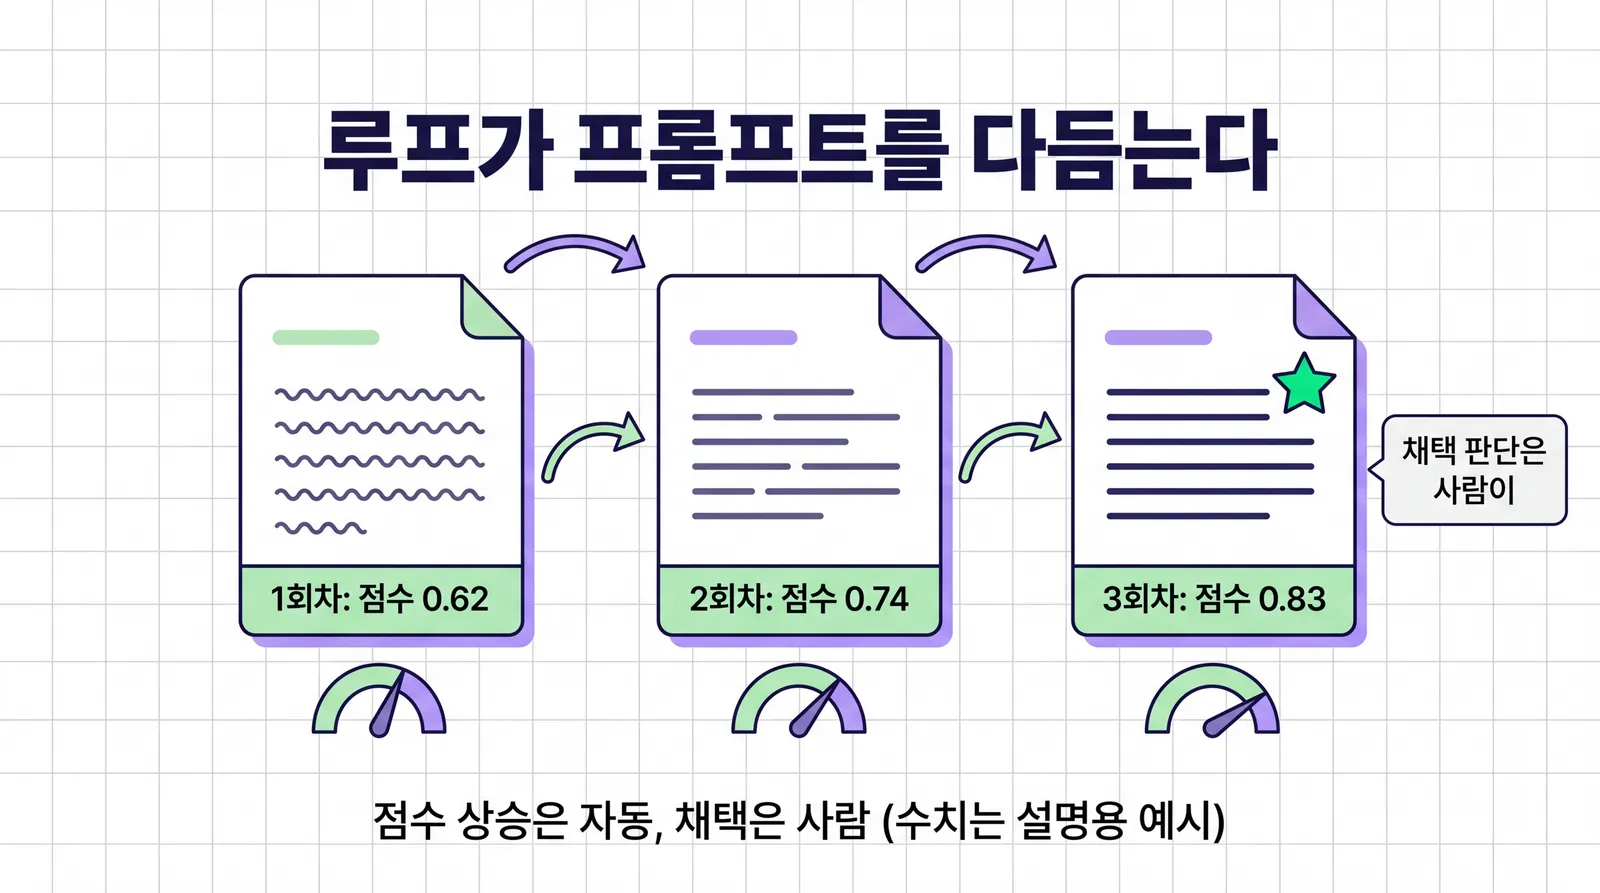
- 이 아이디어의 연구들: 지시문 후보를 모델이 만들고 점수로 고르는 APE(arXiv:2211.01910), 이전 점수를 문맥에 넣어 더 나은 프롬프트를 점진 제안하는 OPRO(arXiv:2309.03409). 이 루프를 프레임워크로 묶은 오픈소스(DSPy 등)도 있다
○ 무엇이 자동화 가능한가
- 후보를 뽑는 일, 채점 스크립트를 돌리는 일, 순위를 매기는 일, 이 세 가지는 코드가 잘한다. 밤새 수백 개 후보를 돌리는 것도 코드의 몫이다
○ 무엇이 사람 판단으로 남는가
- 채점 기준 정의: 정확도로 채점할지, 형식 준수율로 채점할지, 둘의 비중은 어떻게 할지. 채점이 자동이어도 채점 기준은 사람이 정한다. 기준을 잘못 정하면 루프는 잘못된 목표를 아주 열심히 최적화한다
- 채점셋의 대표성 검토: 채점셋이 실제 운영에서 들어올 입력을 대표하는가. 채점셋과 운영 분포가 다르면, 채점 1등 프롬프트가 운영에서 밀릴 수 있다
- 실패 사례 판독: 점수가 같은 두 후보 중 하나를 고를 때, 틀린 사례를 눈으로 읽고 어느 쪽의 실패가 더 치명적인지 판단한다. 문의 분류에서 “요금 문의를 주차로 오분류”와 “불만 접수를 일반 문의로 오분류”는 비용이 다르다
- 비용 저울질: 예시 8개짜리 프롬프트가 예시 2개짜리보다 정확도 1%p 높다고 하자. 앞서 계산한 입력 토큰 2.9배와 맞바꿀 가치인지는 운영 조건이 정한다
□ 운영 재현성 - 프롬프트 변경도 코드 변경처럼
- 운영 중에 프롬프트를 살짝 고쳤다. 그 순간 어제의 결과와 오늘의 결과를 비교할 수 없게 된다. 모델이 같은데 결과가 달라졌다면, 프롬프트 변경인지 데이터 변경인지 추적할 수단이 있어야 한다
- 그래서 프롬프트는 채팅창에서 임시로 고치는 것이 아니라, 버전을 붙여 보관하고, 변경 사유를 기록하고, 채점셋을 다시 돌려 비교한다. 코드의 커밋·배포 절차에 해당한다
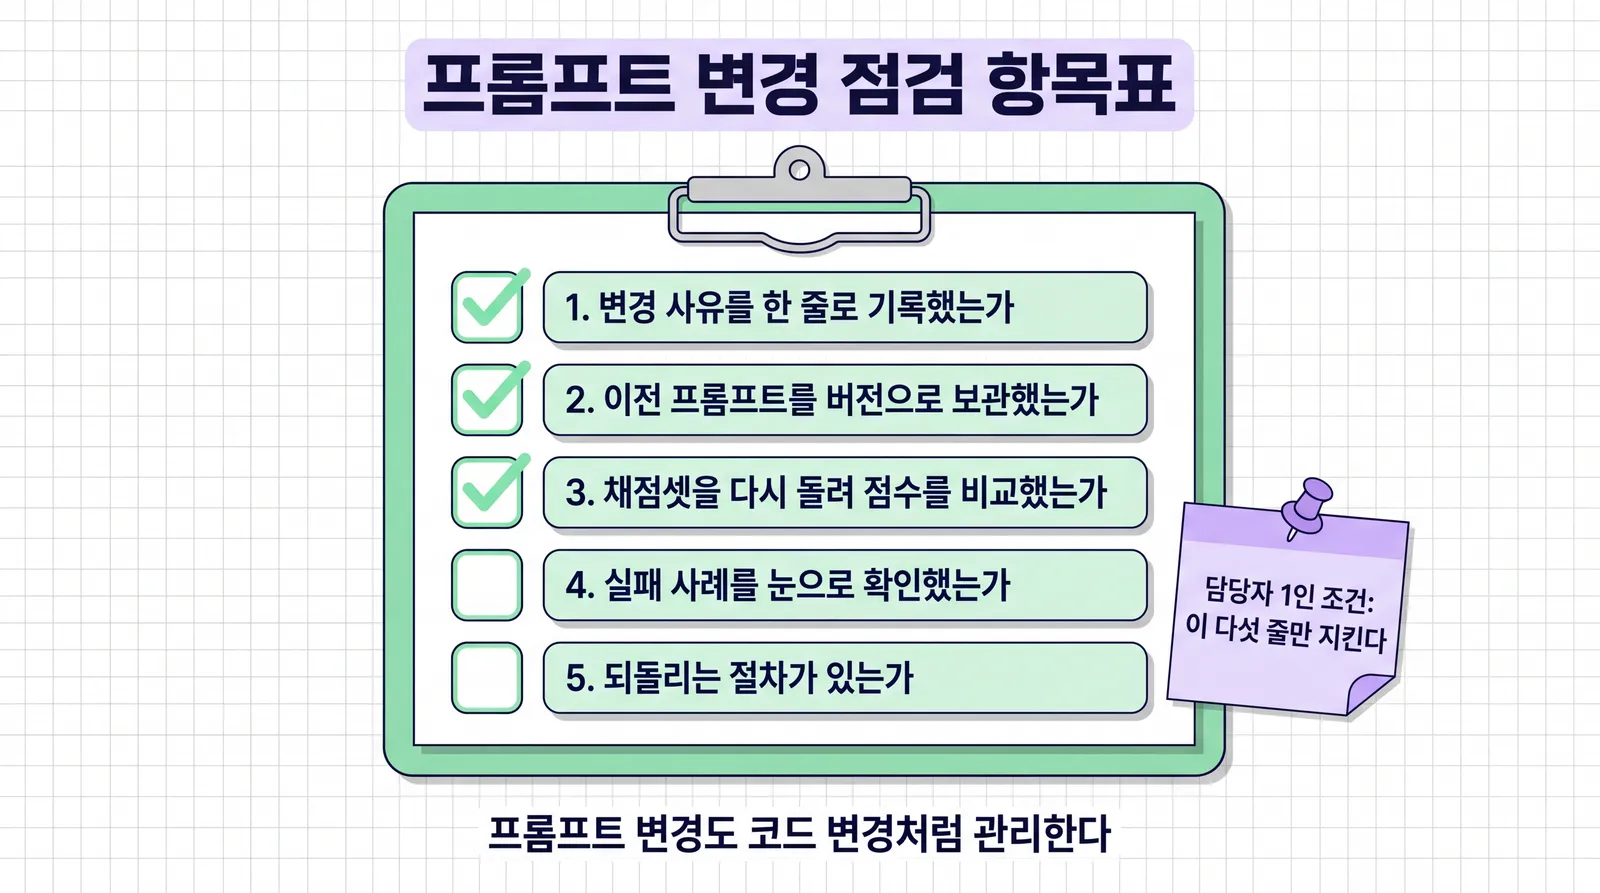
- 다섯 항목이다: 1) 변경 사유를 한 줄로 기록했는가, 2) 이전 프롬프트를 버전으로 보관했는가, 3) 채점셋을 다시 돌려 점수를 비교했는가, 4) 실패 사례를 눈으로 확인했는가, 5) 되돌리는 절차가 있는가
- 이 표를 실제로 채우면 이런 모습이다 (수치는 작성 예시다)
| 항목 | 채운 내용 |
|---|---|
| 1. 변경 사유 | “기타 문의가 주차로 새는 사례 3건 확인, 경계 사례 예시 1개 추가” |
| 2. 버전 보관 | prompt-v3.txt로 저장, v2는 보관 폴더에 유지 |
| 3. 채점셋 비교 | v2 0.81 -> v3 0.83 (채점셋 100건 기준) |
| 4. 실패 사례 확인 | v3 오분류 17건 중 12건이 기타, 치명도 낮음으로 판단 |
| 5. 되돌리기 절차 | 문제 발생 시 v2 파일로 교체, 소요 5분 |
- 담당자 한 명이 데이터·운영·현업 소통을 겸하는 멀티롤 조건을 상정해 보자. 이 조건에서 관리 가능한 형태는 “완벽한 MLOps”가 아니라 이 다섯 줄을 지키는 습관이다. 도구보다 절차가 먼저다. 실무 학습활동에서 이 표를 직접 채운다
[이론] 파라미터 갱신 없이 문맥만으로 동작이 달라지는 이유와 그 한계를 확률 관점에서 정리. 위의 장난감 확률표(문맥 A/B)를 예로 들어, P(다음 토큰 | 문맥)에서 문맥이 무엇을 바꾸고 무엇은 못 바꾸는지(사전학습에 없던 패턴) 문장으로 쓴다
[구현] 프롬프트 변형을 자동 채점하는 스크립트를 받아 실행하고, 프롬프트 하나를 추가해 순위가 어떻게 바뀌는지 확인. 추가할 때는 지시문·예시·서식 중 한 가지만 바꾼 프롬프트를 만든다. 순위가 바뀌었다면 바뀐 후보가 무엇을 달리했는지 대조 조건으로 적는다
[실무] 운영 중 프롬프트를 바꿨을 때 결과 재현성이 깨지는 문제를 제공된 점검 항목표를 채우는 형태로 정리. 담당자 한 명이 데이터·운영·현업 소통을 겸하는 멀티롤 조건에서 관리 가능한 형태인지 판단. 다섯 항목 각각에 대해 “내 조건에서 지킬 수 있는가, 못 지킨다면 무엇이 막는가”를 쓴다
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. few-shot도 예시를 보여 주니까 결국 학습 아닌가?
가중치가 갱신되지 않는다는 점에서 학습이 아니다. 예시는 입력(문맥)의 일부일 뿐이고, 모델은 다음 호출에서 그 예시를 기억하지 못한다. 매번 문맥에 넣어 줘야 하므로 입력이 길어지는 비용이 매번 든다. “교육”이 아니라 “매번 참고자료를 끼워 주는 것”에 가깝다.
Q2. 예시는 많이 넣을수록 좋은가?
반드시 그렇지 않다. 문맥 창 길이의 한계, 매 호출의 입력 비용 증가(본문의 토큰 계산 참조), 그리고 예시 선택과 순서에 따른 편향이 생긴다. 라벨이 한쪽으로 치우친 예시 묶음은 출력을 그쪽으로 끈다. 적은 예시로 측정부터 하고, 늘릴 때 얻는 것이 비용만큼인지 숫자로 판단한다.
Q3. Chain-of-Thought를 쓰면 항상 정확해지는가?
아니다. 단계가 필요 없는 단순 과제에서는 출력만 길어져 비용과 지연이 늘고, 단계 하나가 틀리면 그 뒤가 연쇄적으로 틀린다(본문의 연쇄 오류 예시 참조). 적힌 풀이는 그럴듯한 문장일 뿐 검증된 계산이 아니므로, 중요한 계산은 코드로 다시 확인하는 것이 안전하다.
Q4. 자동 최적화가 찾은 프롬프트는 사람이 만든 것보다 늘 나은가?
채점셋 기준으로는 나을 수 있지만, 채점 기준과 채점셋은 사람이 정했다. 기준이 운영 목표와 어긋나 있으면 루프는 어긋난 목표를 열심히 최적화한다. 채점 1등이 운영 1등이 아닐 수 있으므로, 채택 전에 실패 사례를 눈으로 확인한다.
Q5. 문맥에 사실을 적어 주면 모델이 그것을 믿는가?
믿음의 문제가 아니라 조건부 확률의 문제다. 모델은 문맥의 패턴을 이어 쓸 뿐이라, 문맥의 내용과 사전학습 때 본 내용이 충돌하면 어느 쪽을 따를지는 과제와 서식에 따라 달라진다. 그래서 “문맥에 적었으니 지키겠지”라고 가정하지 않고, 채점셋으로 확인한다. 9주차의 검색 결합 생성(RAG)이 이 문제를 정면으로 다룬다.
Q6. 프롬프트에 정답을 그냥 알려 주면 되는 것 아닌가?
예시에 들어가는 정답은 “이 과제의 기준과 형식”을 가르치는 재료다. 하지만 지금 풀 질의의 정답을 미리 알려 주면 그것은 과제 수행이 아니라 베끼기다. 운영에서는 새 입력의 정답을 모르니까 모델을 쓰는 것이다. 그래서 성능은 정답을 모르는 채점셋으로만 측정한다.
Q7. 프롬프트는 한국어와 영어 중 어느 쪽이 유리한가?
모델과 과제에 따라 다르다. 사전학습 데이터가 영어에 치우친 모델은 영어 지시가 잘 듣는 경우가 있지만, 한국어 문서를 다루는 과제는 한국어 프롬프트가 나을 수도 있다. 규칙을 외우지 말고, 같은 내용을 두 언어로 만들어 채점셋 점수를 비교한다. 이번 주 학습활동의 대조 요령이 그대로 쓰인다.
스스로 점검
Section titled “스스로 점검”- “이 표현은 아주 ___“의 문맥 A 확률이 좋다 0.40, 멋지다 0.25, 어렵다 0.20, 싫다 0.15일 때, 모델이 확률 최대 토큰을 고르면 무엇이 나오나? 문맥 B(0.10, 0.08, 0.12, 0.70)에서는?
- 프롬프트의 세 덩어리를 쓰고, “예) ‘성산일출봉 주차장이 어디예요?’ -> 주차”는 어느 덩어리인가?
- 귤이 개당 1,200원일 때 3개를 사고 2,000원을 냈다. CoT 단계를 손으로 적어 보자. 거스름돈은 얼마인가?
- few-shot 분류에서 예시를 3개에서 10개로 늘렸다. 모델의 가중치는 몇 개가 바뀌었나?
- 지시문 20토큰, 예시 하나 30토큰, 질의 15토큰으로 어림할 때, 예시 4개 프롬프트의 입력 토큰 어림은? 예시 8개와 비교해 얼마나 아끼나?
- 자동 프롬프트 최적화 루프에서 코드가 하는 일 세 가지와, 사람 판단으로 남는 일 두 가지를 써 보자.
정답 보기
- 문맥 A는 좋다(0.40), 문맥 B는 싫다(0.70). 모델과 질의는 같고 문맥만 다르다
- 지시문, 예시(demonstrations), 질의. 인용된 문장은 예시 덩어리다
- 1,200 x 3 = 3,600원, 낸 돈 2,000원, 3,600 - 2,000 = 1,600원 부족. 거스름돈은 없다
- 0개. 예시는 문맥(입력)의 일부이고 가중치는 갱신되지 않는다. 바뀐 것은 다음 호출의 입력 길이다
- 20 + 30 x 4 + 15 = 155토큰. 예시 8개는 275토큰이므로 120토큰을 아낀다 (물론 정확도와 맞바꾼 값인지는 측정이 정한다)
- 코드: 후보 생성, 자동 채점 실행, 순위 매기기(변형 반복까지 허용). 사람: 채점 기준 정의, 채점셋 대표성 검토, 실패 사례 판독, 비용 저울질 중 두 가지
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 한 줄 뜻 |
|---|---|
| 토큰 | 모델이 읽고 쓰는 텍스트 조각의 단위 |
| 확률분포 | 다음 토큰 후보마다 붙은, 합이 1인 확률표 |
| 프롬프트 | 모델에 넣는 입력 전체. 지시문, 예시, 질의로 이뤄진다 |
| 문맥학습 (ICL) | 가중치 갱신 없이 문맥 안의 예시만으로 동작이 달라지는 현상 |
| zero-shot | 예시 없이 지시문만으로 과제를 시키기 |
| one-shot / few-shot | 예시 하나 / 여러 개를 문맥에 넣고 과제를 시키기 |
| 지시문 (instruction) | 과제와 출력 형식을 정의하는 프롬프트 덩어리 |
| 예시 (demonstrations) | 입력과 출력의 쌍으로 관례를 보여 주는 프롬프트 덩어리 |
| 라벨 균형 | 예시 묶음에서 라벨별 비율을 골고루 맞추는 것 |
| 문맥 창 | 모델이 한 번에 읽을 수 있는 입력 분량 |
| Chain-of-Thought | 중간 풀이 단계를 적게 해 최종 답의 정확도를 높이는 프롬프트 기법 |
| 프롬프트 민감성 | 서식·예시 선택·순서·라벨 균형에 따라 성능이 흔들리는 성질 |
| 자동 프롬프트 최적화 | 후보 생성, 자동 채점, 선택, 변형을 반복해 프롬프트를 고르는 절차 |
| 채점셋 | 프롬프트 후보를 비교하기 위한 정답 있는 평가 데이터 |
| 재현성 | 같은 모델, 같은 프롬프트, 같은 데이터면 같은 결과가 나오도록 관리하는 성질 |
실습 노트북
Section titled “실습 노트북”
작은 한국어 언어모형을 가중치 갱신 없이 그대로 써서, 제주 관광 문의 분류를 프롬프트 A, B, C로 풀고 자동 채점 순위표를 만든다. 그다음 내 프롬프트 D 하나를 추가해 순위가 어떻게 바뀌는지 확인한다.