
3주차: 효율적 미세조정의 원리와 변형
효율적 미세조정의 원리와 변형
□ 이 주차가 놓이는 자리
- 2주차에서 학습 루프를 끝까지 돌려 봤다. 이번 주의 질문은 “1.1억 개를 전부 다시 학습해야 하는가” 다
- 답은 아니오다. 큰 모델은 얼려 두고, 아주 작은 부품 몇 개만 붙여서 그것만 학습해도 목표 성능에 근접하는 경우가 많다. 이것이 PEFT(Parameter-Efficient Fine-Tuning, 파라미터 효율적 미세조정)다
- 비유: 공장의 거대한 기계를 통째로 개조하는 대신, 기계는 그대로 두고 작은 모듈 하나를 끼워 동작을 바꾸는 것이다
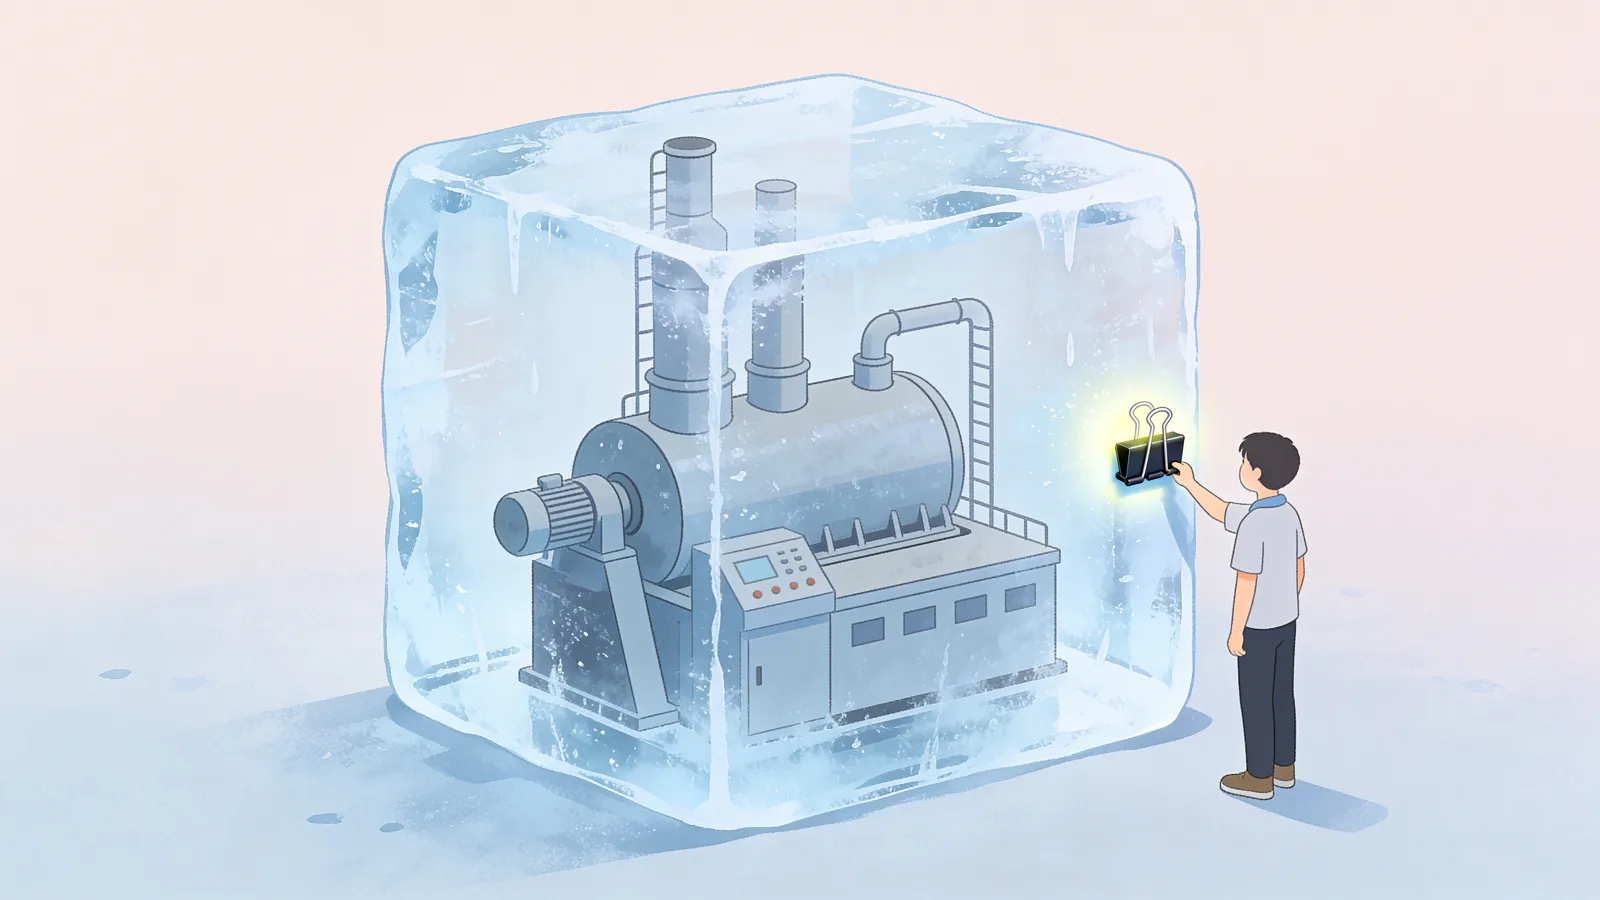
- 이번 주 실습은 과제 1의 출발점이다. 과제 1은 PEFT 기법 하나를 돌려보고 비교표에서 내 결과의 위치를 해석하는 것이다
□ 사전학습, 미세조정, 프롬프트 - 무엇이 다른가
- 모델을 내 일에 맞추는 방법은 크게 세 가지다. 회사에 들어온 신입 직원으로 비유하면 차이가 선명하다
| 방법 | 신입 직원 비유 | 가중치가 바뀌나 | 드는 비용 | 이 과목에서 |
|---|---|---|---|---|
| 사전학습 | 대학에서 몇 년간 폭넓게 공부하기 | 처음부터 전부 만든다 | 매우 큼 | 다루지 않음 (이미 된 모델을 가져옴) |
| 미세조정 | 입사 후 우리 부서 실무를 따로 교육하기 | 바뀐다 (전부 또는 일부) | 중간 | 3주차, 8주차 |
| 프롬프트 | 교육 없이 매번 업무 지시서를 자세히 쥐여 주기 | 바뀌지 않는다 | 작음 (대신 매번 입력이 길어짐) | 4주차 |
- 이번 주는 가운데 줄, 미세조정을 싸게 하는 법이다. “전부 교육”하면 비싸니, 핵심만 교육하는 방법을 찾는다
□ 이번 주가 답하는 질문
- 1.1억 개 모델에서 어댑터와 분류 헤드만 학습하면 무엇을 줄이는가
- 랭크를 두 배로 늘릴 때 어댑터 수·전체 학습 파라미터·proxy 성능이 각각 어떻게 달라지는가
- 파라미터 텐서의 bytes와 학습 peak 메모리는 왜 다른가
- 전체 미세조정을 실행하지 않고 비교표에 적을 수 있는 것과 미측정으로 남겨야 하는 것은 무엇인가
□ 읽기 안내 - 이 노트의 어디와 이어지나
| 읽기 | 이 노트에서 다루는 곳 |
|---|---|
| LoRA, arXiv:2106.09685 | 저랭크 근사, 어댑터 수, 가중치 병합 |
| QLoRA, arXiv:2305.14314 | 동결 가중치 양자화와 메모리 어림 |
| DoRA, arXiv:2402.09353 | 크기와 방향을 나누는 변형 |
| VB-LoRA, arXiv:2405.15179 | 공용 벡터 은행 |
| WaveFT v3, arXiv:2505.12532 | 웨이블릿 변형과 언어 이해 검증 범위 |
| 위키백과 제주특별자치도 고정 판 | CPU 실습의 공개 한국어 입력과 규칙 기반 proxy label |
온라인 (2시수)
Section titled “온라인 (2시수)”강의: PEFT 이론 - 저랭크 근사, LoRA·QLoRA
Section titled “강의: PEFT 이론 - 저랭크 근사, LoRA·QLoRA”□ 전체 미세조정은 왜 부담인가
- 2주차에 확인한 한국어 분류 모델의 전체 파라미터 수는 112,922,882개다. 전체 미세조정(full fine-tuning)은 이 1.1억 개를 전부 다시 학습시킨다
- 비유: 백과사전 한 권을 우리 마을 사정에 맞게 고치고 싶은데, 책 전체를 처음부터 다시 쓰는 셈이다
- 비용은 파라미터 수보다 더 크다. 학습 중에는 파라미터마다 그래디언트(어디로 고칠지)와 옵티마이저 상태(지금까지의 고침 기록, Adam 계열은 두 벌)가 따라붙는다. 그래서 학습 파라미터를 하나 줄일 때마다 메모리는 그 몇 배(아래 계산에서는 12바이트)씩 준다
- 1.1억 개짜리 모델이라서 이 정도다. 수십억 개짜리 모델을 전체 미세조정하려면 소규모 조직의 장비로는 애초에 손도 못 댄다
○ 메모리를 직접 어림해 보기
- 파라미터 하나가 학습 중에 차지하는 메모리를 32비트(4바이트) 기준으로 세어 보자
- 가중치 자체 4바이트 + 그래디언트 4바이트 + Adam 옵티마이저의 기록 두 벌 8바이트 = 파라미터당 16바이트
- 전체 미세조정: 112,922,882개가 모두 학습 대상이다. 112,922,882 x 16 = 1,806,766,112바이트, 약 1.68GiB
- LoRA: 가중치 112,922,882개는 얼려도 메모리에는 올려야 하므로 x 4바이트 = 451,691,528바이트. 학습하는 739,586개만 그래디언트와 Adam 기록이 붙는다. 739,586 x 12 = 8,875,032바이트. 새로 붙인 어댑터 147,456개의 가중치 자체도 x 4바이트 = 589,824바이트. 합하면 461,156,384바이트, 약 0.43GiB
- 약 3.9배 줄었다. 이 계산에는 중간 계산값(활성값)과 16비트 계산 같은 실제 설정이 빠져 있으므로 어림으로만 쓴다
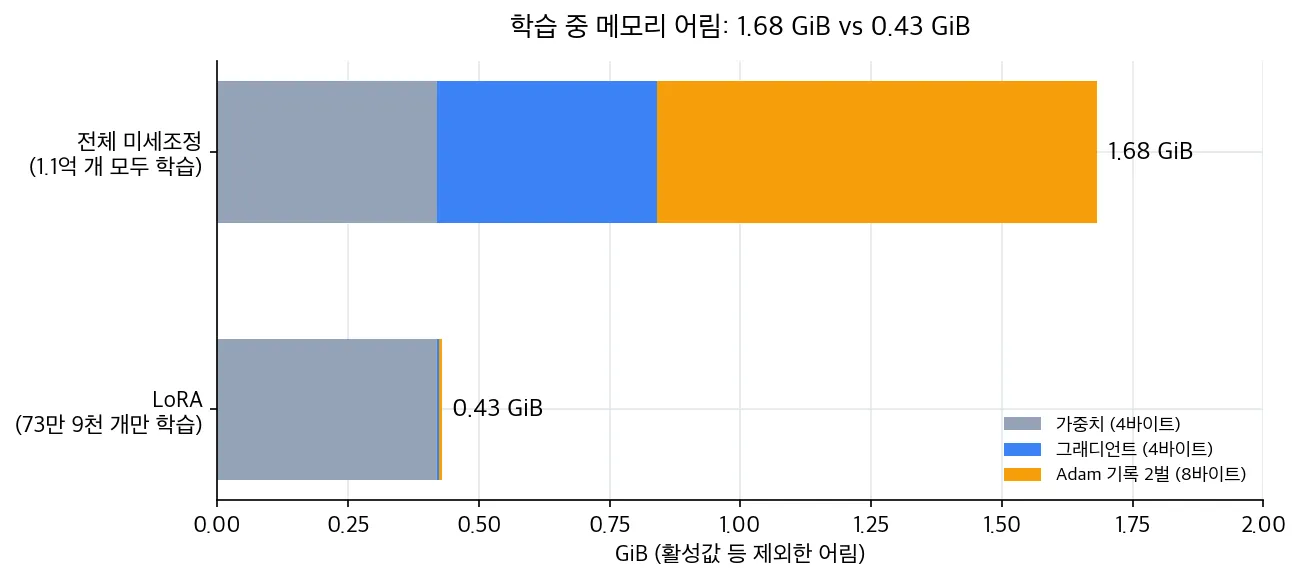
- 그림에서 눈여겨볼 점: LoRA 막대는 거의 회색(얼린 가중치)뿐이다. 학습할 것은 크게 줄였지만, 원래 모델을 올려 두는 비용은 그대로 남는다. 이 남은 회색을 줄이려는 것이 뒤에 나오는 QLoRA다
□ 저랭크 근사 - “핵심만 고치면 충분하다”
- 미세조정이 가중치에 가하는 변화량(ΔW)은 사실 복잡하지 않다는 것이 LoRA(arXiv:2106.09685)의 출발점이다. 비유하면, 1,000페이지 소설의 독후감을 고칠 때 매 페이지를 다시 쓸 필요 없이 핵심 문장 몇 줄만 바꾸면 되는 경우가 많은 것과 같다
- 수학으로는 이 “핵심만”을 랭크가 낮은 행렬의 곱으로 표현한다. 큰 변화량 행렬 하나를 통째로 학습하는 대신, 작은 행렬 두 개(A와 B)의 곱으로 근사한다
- 작은 수치 예 (이 계산은 손으로 따라올 수 있다). 768 x 768 가중치 행렬의 변화량을 통째로 학습하면 768 x 768 = 589,824개 파라미터다. 이를 ΔW = B·A (A는 4 x 768, B는 768 x 4)로 놓으면 학습할 것은 4 x 768 + 768 x 4 = 6,144개. 약 1%(1.04%)로 줄어든다
- 여기서 4가 랭크(r) 다. 랭크를 키우면 표현력이 늘지만 파라미터도 늘어난다. 이 저울질이 3주차의 핵심 감각이다
○ 랭크를 손으로 느껴 보기
- “랭크가 낮다”는 말을 가장 작은 예로 보자. 세로 숫자 [1, 2, 3]과 가로 숫자 [1, 0, 2]를 곱하면 3 x 3 표가 나온다
- 칸마다 “세로 숫자 x 가로 숫자”다. 첫째 줄은 1 x [1, 0, 2] = [1, 0, 2], 둘째 줄은 2 x [1, 0, 2] = [2, 0, 4], 셋째 줄은 3 x [1, 0, 2] = [3, 0, 6]
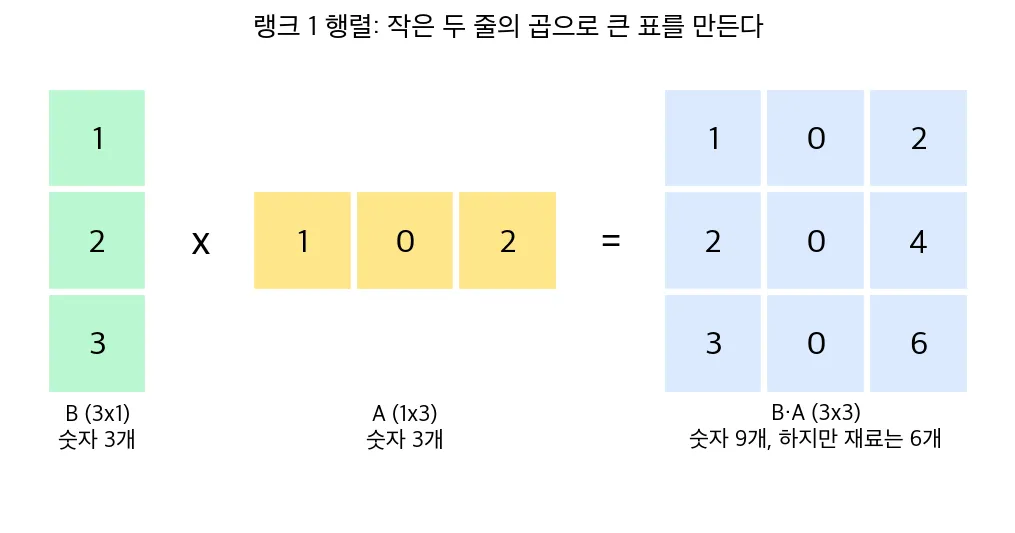
- 표에는 숫자가 9개지만 재료는 6개(3 + 3)뿐이다. 모든 줄이 [1, 0, 2]의 배수라서, 사실상 “한 가지 패턴”만 담고 있다. 이것이 랭크 1이다
- 랭크 r은 “몇 가지 패턴을 섞어 만든 표인가”라고 생각하면 된다. LoRA는 가중치의 변화량이 몇 가지 패턴만으로 충분히 표현된다고 가정하고, 그 패턴의 재료(A와 B)만 학습한다
- 768 x 768 가중치 한 장에서 랭크별 재료 수는 r x (768 + 768) = r x 1,536이다
| 랭크 r | LoRA 파라미터 | 통째로(589,824) 대비 |
|---|---|---|
| 1 | 1,536 | 0.26% |
| 2 | 3,072 | 0.52% |
| 4 | 6,144 | 1.04% |
| 8 | 12,288 | 2.08% |
| 16 | 24,576 | 4.17% |
| 64 | 98,304 | 16.67% |
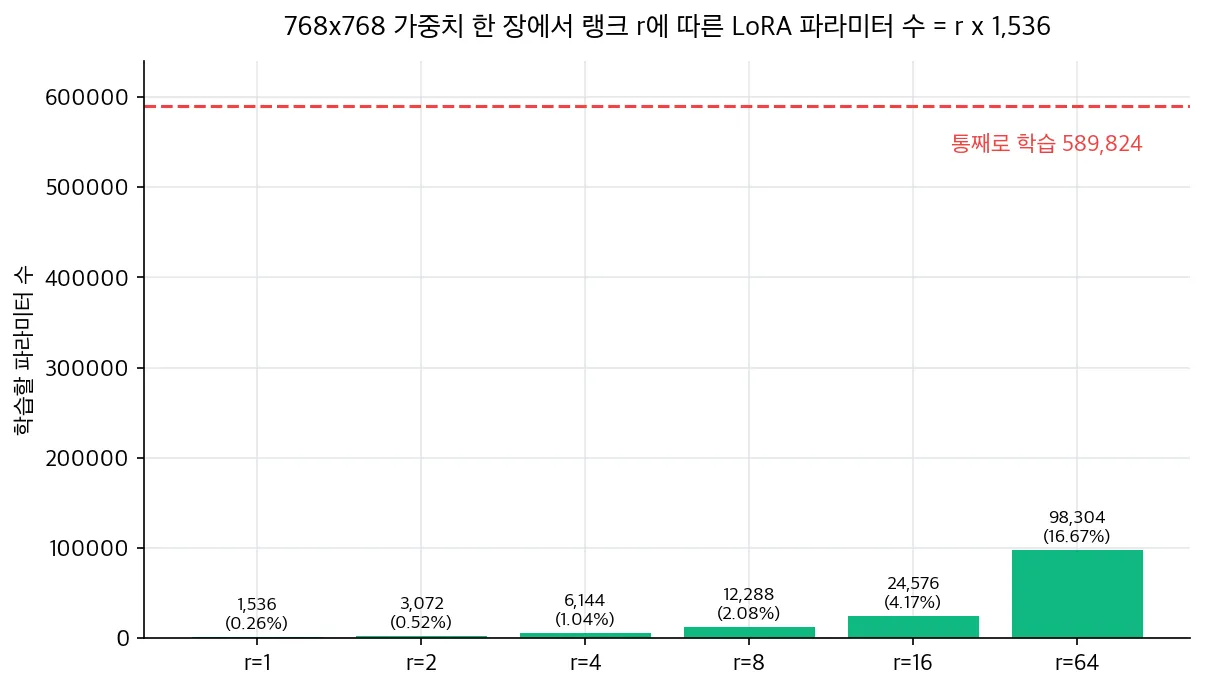
- 랭크가 2배면 파라미터도 정확히 2배다. 랭크 64까지 올려도 통째로 학습하는 양의 6분의 1이다
□ LoRA의 동작 - 얼린 큰 길 옆에 작은 옆길
- 원래 가중치 W는 동결(freeze) 한다. 손대지 않고 얼려 둔다
- 그 옆에 방금 본 작은 행렬 A, B를 옆길처럼 붙이고, 이 둘만 학습한다
- 순전파는
W·x + (α/r)·B·A·x. 원래 길(W)로 가던 것에 옆길(B·A)의 기여를 더한다. 스케일링 계수 α(실습에서는 r의 2배를 쓴다)는 옆길의 목소리 크기다 - 시작할 때 옆길은 조용하다. LoRA 논문은 A를 무작위 값으로, B를 0으로 시작한다. 그러면 B·A = 0이라서, 학습 첫 순간의 모델은 원래 모델과 똑같이 동작한다. 멀쩡한 모델을 망가뜨리지 않고 출발하기 위한 장치다
- B가 0이면 학습이 안 되는 것 아닌가 싶지만, A가 0이 아니므로 B에 대한 그래디언트는 0이 아니다. 첫 step부터 B가 움직이기 시작한다
- α/r 의 역할을 숫자로 보자. r = 4, α = 8이면 α/r = 2. 제공된 함수는 α = 2r로 함께 설정해 r = 8에서도 α = 16, α/r = 2를 유지
- 학생이 바꾸는 값은 r 한 곳. 스케일이 절반으로 줄어드는 효과를 섞지 않도록 제공 골격이 비율을 고정. 데이터 분할·step·배치·seed도 같은 조건으로 사용
- 같은 seed가 모든 rank에서 동일한 무작위 경로까지 보장하는 것은 아님. 어댑터의 모양과 초기화가 바뀌므로 작은 성능 차이를 rank의 일반 효과로 단정하지 않는 해석
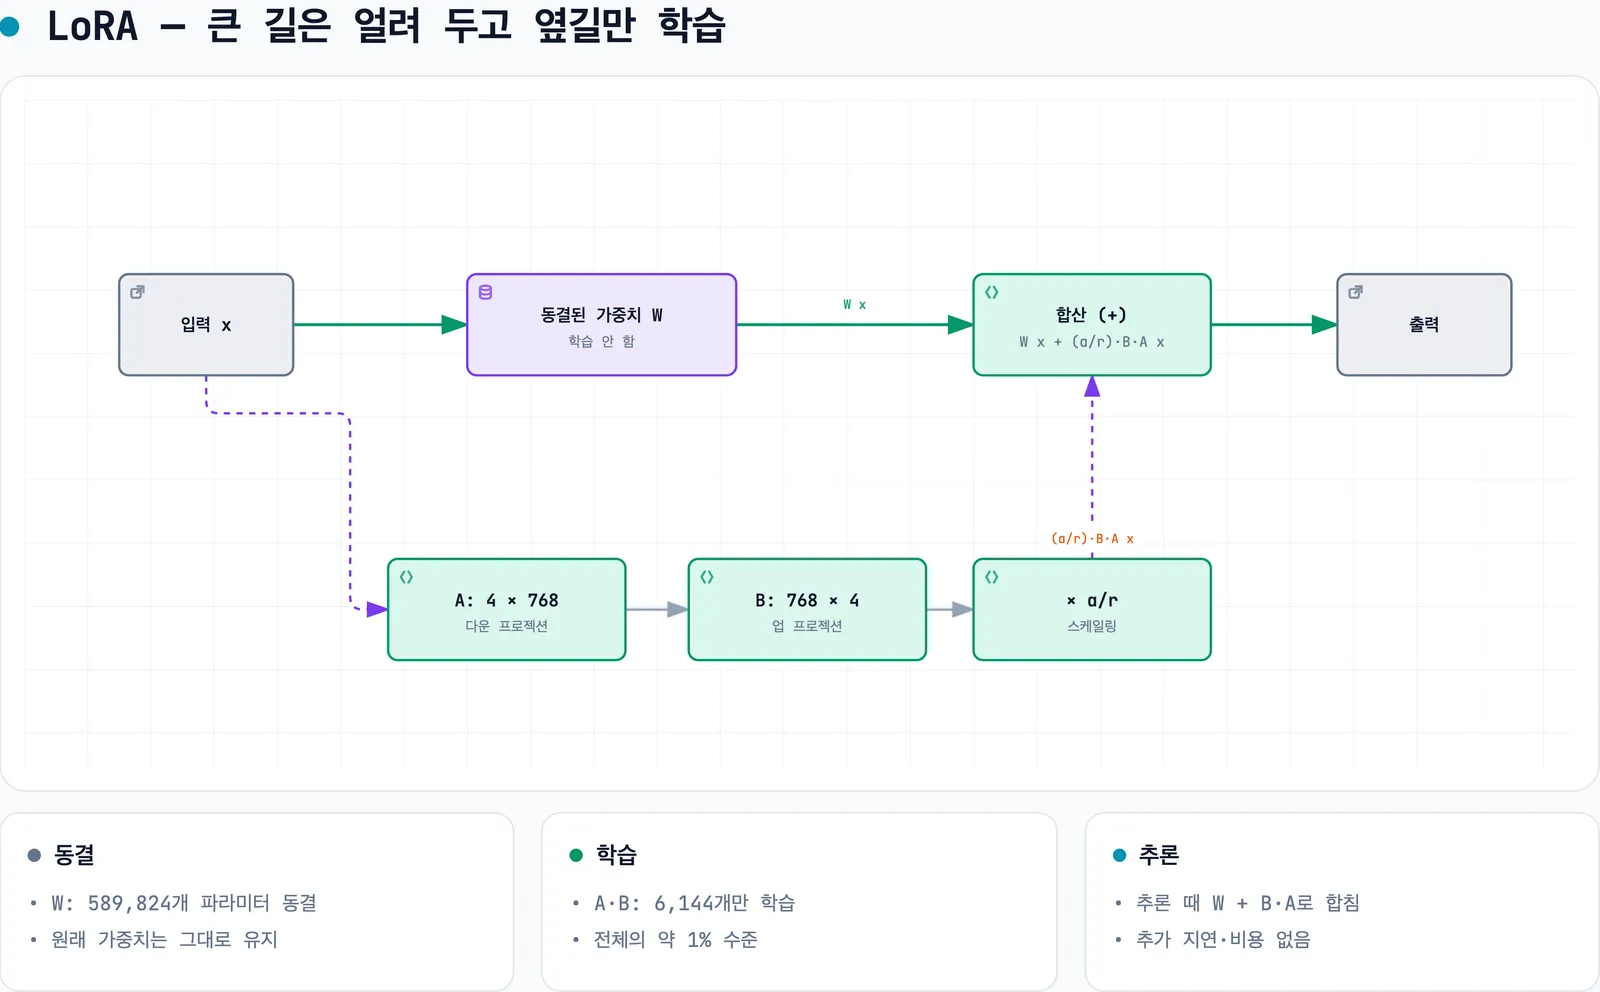
- 학습이 끝나면 옆길(B·A)을 원래 길(W)에 합산할 수 있다. 그래서 추론(실제 사용) 때는 그냥 모델 하나처럼 돌아가 추가 비용이 없다. 이것이 LoRA가 널리 쓰이는 이유 하나다
- 파라미터 구성 참고값(KoELECTRA base, query·value에 r=4 적용, 학습 성능·peak 메모리 수치 아님):
| 항목 | 값 |
|---|---|
| 전체 미세조정 학습 파라미터 | 112,922,882 (100%) |
| LoRA 학습 파라미터 | 739,586 (0.65%) |
| └ 어댑터(A·B) | 147,456 |
| └ 분류 헤드(새로 초기화된 부품) | 592,130 |
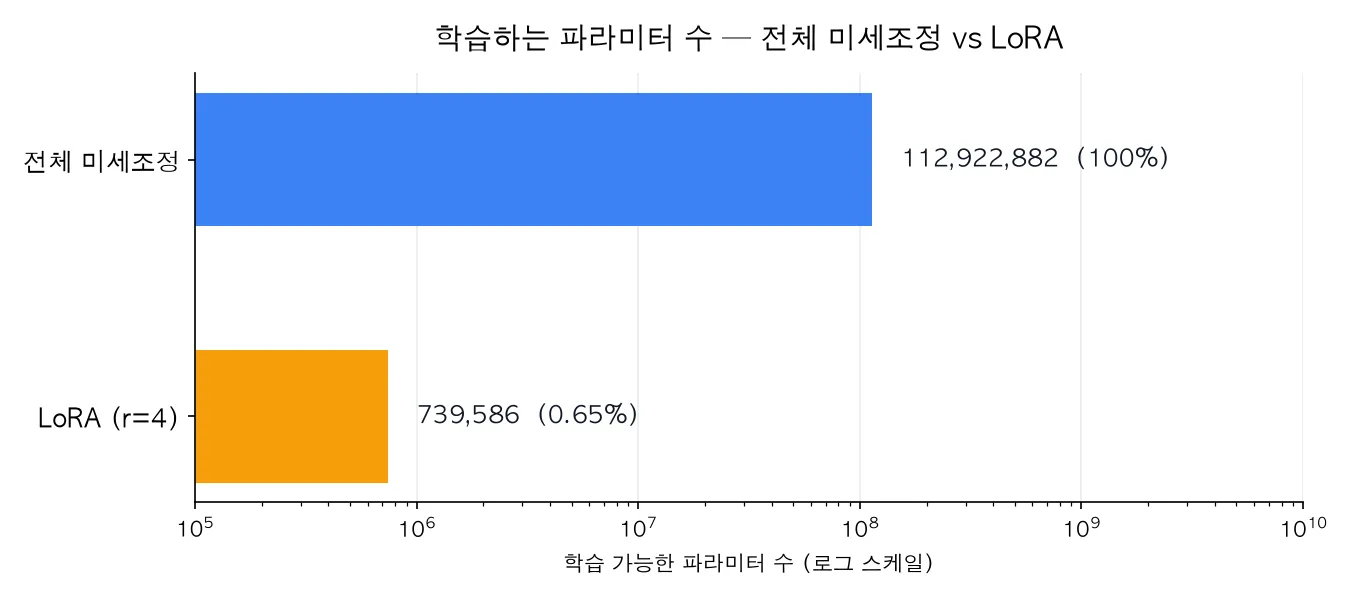
- 어댑터 자체는 15만 개 남짓이다. 1.1억 개 중 0.13%다. 분류 헤드(마지막 판정 부품)는 원래 가중치가 없어 새로 길들여야 하므로 함께 열어 둔다. 그래도 합쳐서 전체의 1%가 안 된다
○ 표의 숫자를 손으로 맞춰 보기
- 위 파라미터 개수는 계산으로 재현된다. 모델은 12층이고, 층마다 어텐션의 query와 value 가중치(각각 768 x 768)에 r = 4 어댑터를 붙였다
- 어댑터: 한 장당 4 x 1,536 = 6,144개, 층마다 2장(query, value), 12층이므로 6,144 x 2 x 12 = 147,456개. 표와 일치한다
- 분류 헤드: 768 x 768 가중치와 768개 편향으로 된 층 하나(590,592개), 그리고 768 x 2 가중치와 2개 편향으로 된 최종 판정 층(1,538개). 합하면 592,130개. 역시 일치한다
- 왜 query와 value인가. LoRA 논문은 연구 범위를 어텐션 가중치만 적응시키는 것으로 한정했고, 실습도 그 관례를 따라 query와 value를 골랐다. 어디에 붙일지는 설정 한 줄로 바꿀 수 있으며, 붙이는 곳이 늘면 파라미터도 그만큼 는다
□ QLoRA - 모델을 더 작게 올려 놓고 시작
- QLoRA(arXiv:2305.14314)는 한 발 더 나간다. 베이스 모델의 가중치를 4비트로 압축(양자화) 해서 메모리에 올리고, 그 위에 LoRA를 학습한다
- 비유: 원본 사진 앨범을 통째로 들고 다니는 대신 축약 인쇄본을 들고 다니면서, 메모는 정확하게 하는 것이다
○ 양자화 - 숫자를 몇 비트로 적느냐
- 가중치 하나를 32비트로 적는다고 하자. 소수점 아래까지 아주 촘촘한 눈금이다. 16비트는 저장 공간을 절반으로 줄이는 대신 눈금이 거칠어지고, 4비트는 눈금이 16칸(2의 4제곱)뿐이다
- 눈금이 거칠어지면 정밀도는 조금 잃지만 크기가 확 준다. 가중치만 계산하면 다음과 같다 (1GB = 1,000,000,000바이트로 계산)
| 모델 | 32비트 (4바이트) | 16비트 (2바이트) | 4비트 (0.5바이트) |
|---|---|---|---|
| 실습 모델 112,922,882개 | 451.7MB | 225.8MB | 56.5MB |
| 가상의 70억 개 모델 | 28GB | 14GB | 3.5GB |
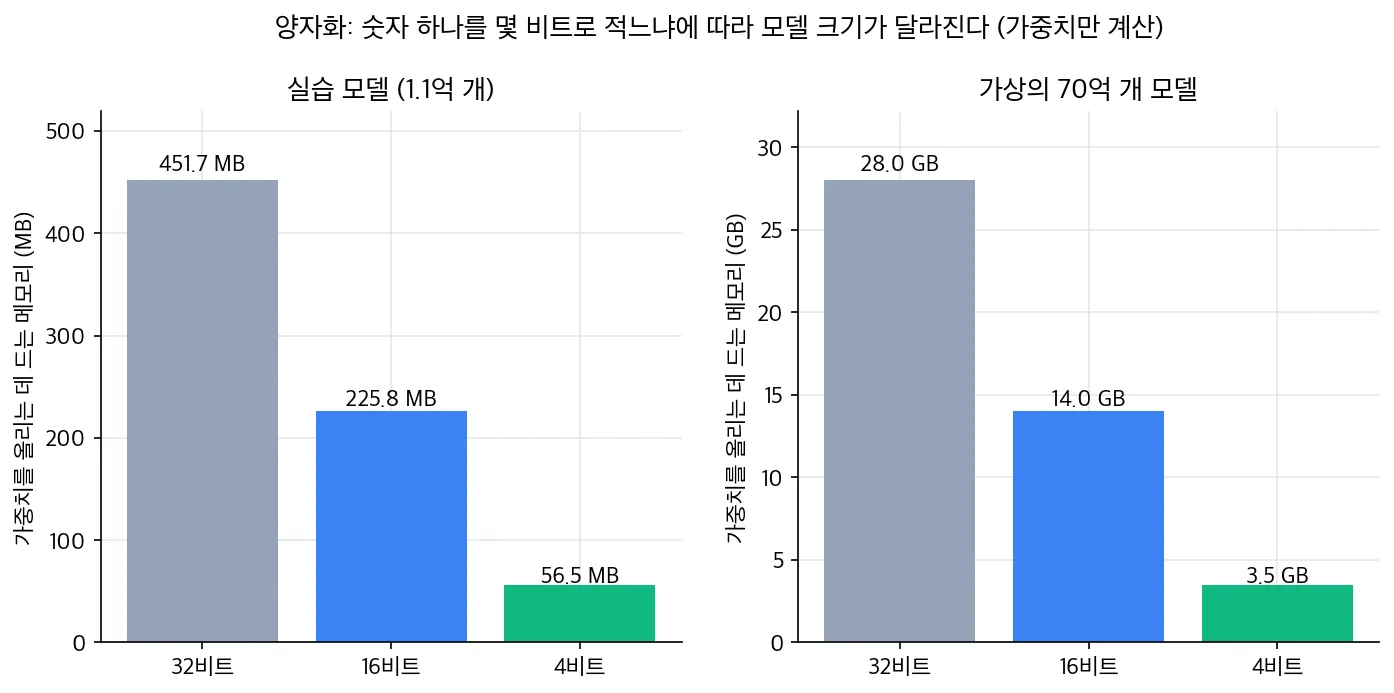
- 70억 개 모델을 32비트로 올리려면 28GB가 필요하다. 4비트면 3.5GB다. 앞의 메모리 막대에서 LoRA에 남은 회색(얼린 가중치)을 32비트 기준 8분의 1로 줄이는 것이 QLoRA의 효과다
- 실제 4비트 저장에는 눈금을 되살리는 보조 숫자가 조금 더 붙어서, 표보다 약간 크다
○ QLoRA의 세 가지 장치 (한 줄씩)
- NF4(4-bit NormalFloat): 가중치 값은 대체로 0 근처에 몰려 있다. 16칸 눈금을 똑같은 간격으로 두지 않고, 값이 많이 몰린 곳에 눈금을 촘촘히 두는 4비트 형식이다
- 이중 양자화(double quantization): 앞에서 말한 “눈금을 되살리는 보조 숫자”까지 한 번 더 압축해 평균 메모리를 더 줄인다
- 페이지 옵티마이저(paged optimizers): 학습 중 메모리가 순간적으로 치솟을 때 옵티마이저 기록 일부를 잠시 다른 메모리로 옮겨, 메모리 부족으로 멈추는 일을 막는다
- 학습 파라미터 수는 LoRA와 같은데, 모델이 메모리에 올라가는 크기 자체가 확 줄어든다. 그래서 작은 GPU로 큰 모델을 미세조정할 때 널리 쓰인다
- 우리 실습 모델은 작아서 양자화 이득이 크지 않다. 개념과 “언제 필요한가”(모델이 GPU에 안 올라갈 때)를 알아두는 것이 목적이다
- 기법별(전체 미세조정 / LoRA / QLoRA) 학습 파라미터 수와 예상 메모리 사용량을 표로 정리하고, 어느 조건에서 무엇을 고를지 선택 근거를 작성한다
- 기준은 숫자다. “가벼운 것 같다”가 아니라 “학습 파라미터가 전체의 몇 퍼센트인가”로 말한다
대면 (1시수)
Section titled “대면 (1시수)”변형 기법의 차이 분석 - DoRA·VB-LoRA·WaveFT
Section titled “변형 기법의 차이 분석 - DoRA·VB-LoRA·WaveFT”□ 공통점과 갈림길
- 세 기법 모두 LoRA의 “작은 옆길만 학습” 골격 위에 있다. 갈림길은 무엇을 더 쪼개거나, 무엇을 함께 쓰는가다
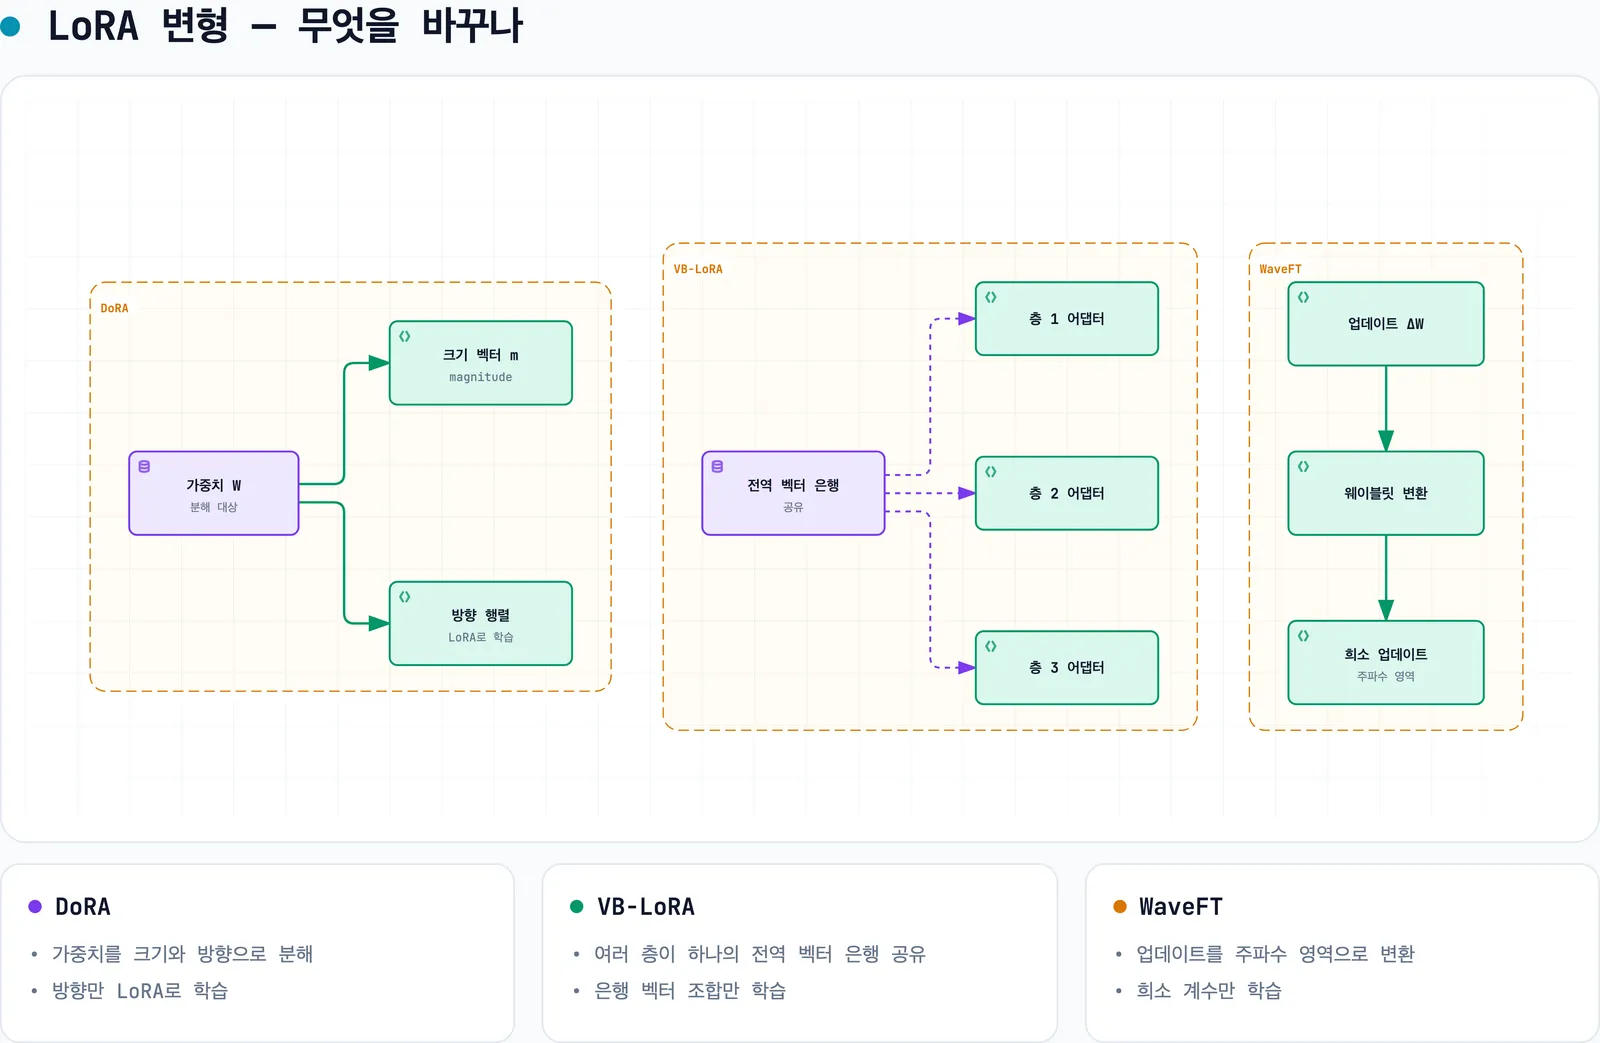
| 기법 | 바꾸는 것 | 쉬운 설명 | 출처 |
|---|---|---|---|
| DoRA | 가중치를 크기(magnitude)와 방향(direction)으로 분해 | 벡터를 “길이”와 “방향”으로 나눠, 방향은 LoRA로, 길이는 따로 조정. 전체 미세조정의 학습 패턴에 더 근접한다고 보고됨 | arXiv:2402.09353 (ICML 2024) |
| VB-LoRA | 어댑터 재료를 모든 층이 함께 쓰는 벡터 은행에서 조달 | 각 층이 재료를 따로 사지 않고 공용 창고에서 골라 씀. 파라미터를 극단적으로 절감 | arXiv:2405.15179 |
| WaveFT | 업데이트를 웨이블릿(무늬의 굵기와 위치) 변환 영역에서 학습 | 그림을 원본 대신 “물결 무늬의 재료 목록”으로 바꿔 필요한 무늬만 조금씩 조정. 파라미터 수를 세밀하게 조절, v3에 언어 이해 실험도 포함 | arXiv:2505.12532 |
○ DoRA - 크기와 방향을 따로 고친다
- 숫자 묶음(벡터)은 크기(얼마나 긴가)와 방향(어느 쪽을 가리키나)으로 나눌 수 있다. 벡터 (3, 4)의 크기는 √(3 x 3 + 4 x 4) = √25 = 5, 방향은 크기로 나눈 (3/5, 4/5), 곧 0.6과 0.8의 짝이다
- 다시 곱하면 원래대로다. 5 x (0.6, 0.8) = (3, 4)
- DoRA는 가중치를 이렇게 나눠서 방향은 LoRA로, 크기는 따로 학습 가능한 숫자로 고친다. 한 손잡이로 길이와 방향을 동시에 돌리는 대신, 손잡이를 둘로 나눈 셈이다
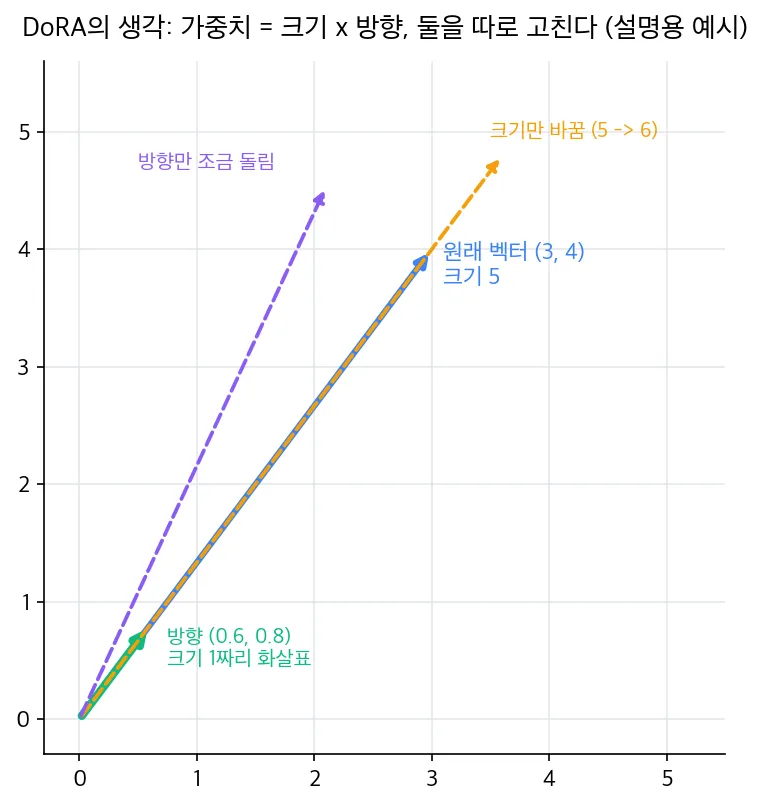
- 논문은 이렇게 나누면 전체 미세조정이 가중치를 바꾸는 패턴에 더 가까워진다고 보고했다. 학습 후 병합이 가능해 추론 비용은 늘지 않는다
○ VB-LoRA - 공용 창고에서 재료 꺼내 쓰기
- 일반 LoRA는 어댑터를 붙인 곳마다 자기 A, B를 따로 가진다. 실습 설정(12층 x query·value 2곳)이면 재료 세트가 24벌이다
- VB-LoRA는 모든 층이 함께 쓰는 벡터 은행(공용 창고)을 하나 두고, 각 층은 거기서 필요한 벡터 몇 개를 골라 섞어 자기 어댑터를 만든다
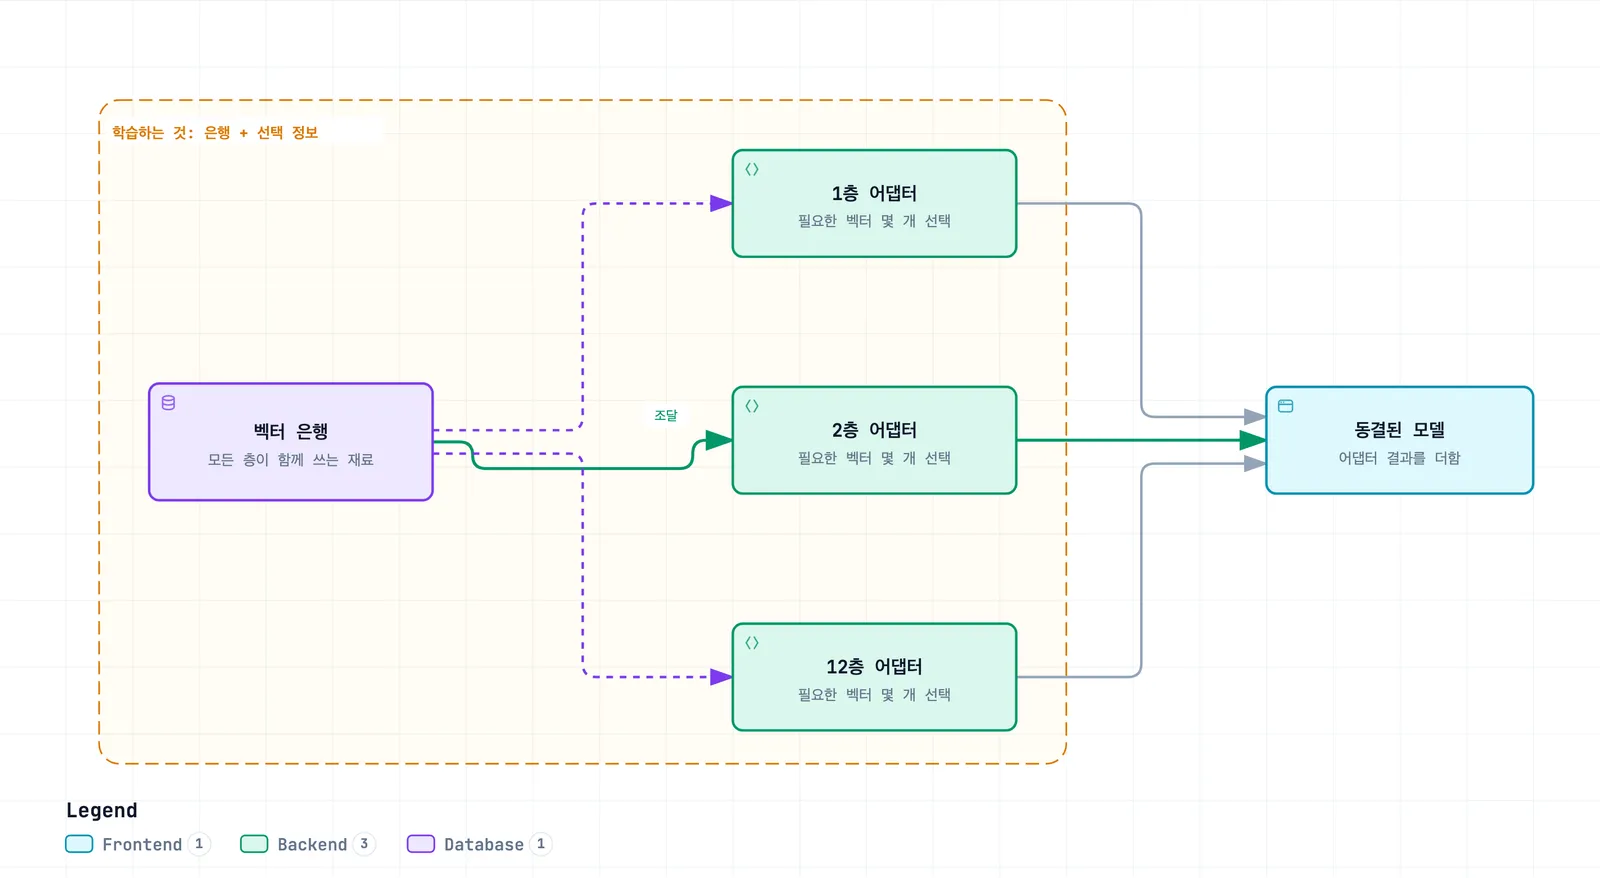
- 층마다 재료를 사지 않으니 전체 파라미터가 극단적으로 줄어든다. 대신 창고를 어떻게 나눠 쓰는지가 성능을 좌우한다
○ WaveFT - 원본 대신 “무늬”를 고친다
- 사진을 저장할 때 픽셀 하나하나 대신 “굵은 무늬와 잔무늬의 조합”으로 적는 방법이 있다. 웨이블릿 변환이 그런 방식이다
- WaveFT는 가중치의 변화량을 이런 무늬 영역에서 학습하고, 고칠 무늬의 개수를 정해 파라미터 수를 세밀하게 조절한다
- v3 원문 부록 C.3는 RoBERTa-base의 GLUE 6개 언어 이해 과제도 평가. 시각 실험뿐이라거나 텍스트 검증이 없다고 설명하지 않는 범위
- 해당 검증을 제주 한국어 데이터의 성능으로 옮기지는 않는다. 수업의 KoELECTRA·규칙 기반 proxy와 모델·언어·과제가 다르므로 직접 성능 비교 불가
□ 비교할 때 보는 것
- 파라미터 수만 보지 않는다. 추론 시 추가 비용이 있는가, 표준 라이브러리에서 바로 쓸 수 있는가, 논문의 검증이 어떤 과제·모델에서 이뤄졌는가를 함께 본다
- 예: LoRA와 DoRA는 병합이 가능해 추론 비용이 늘지 않는다. 또한 WaveFT는 제안된 지 얼마 되지 않아 텍스트 과제 검증이 제한적이다. “최신”과 “검증됨”은 다른 말이다
□ 어떤 미세조정을 고를까 - 판단 순서
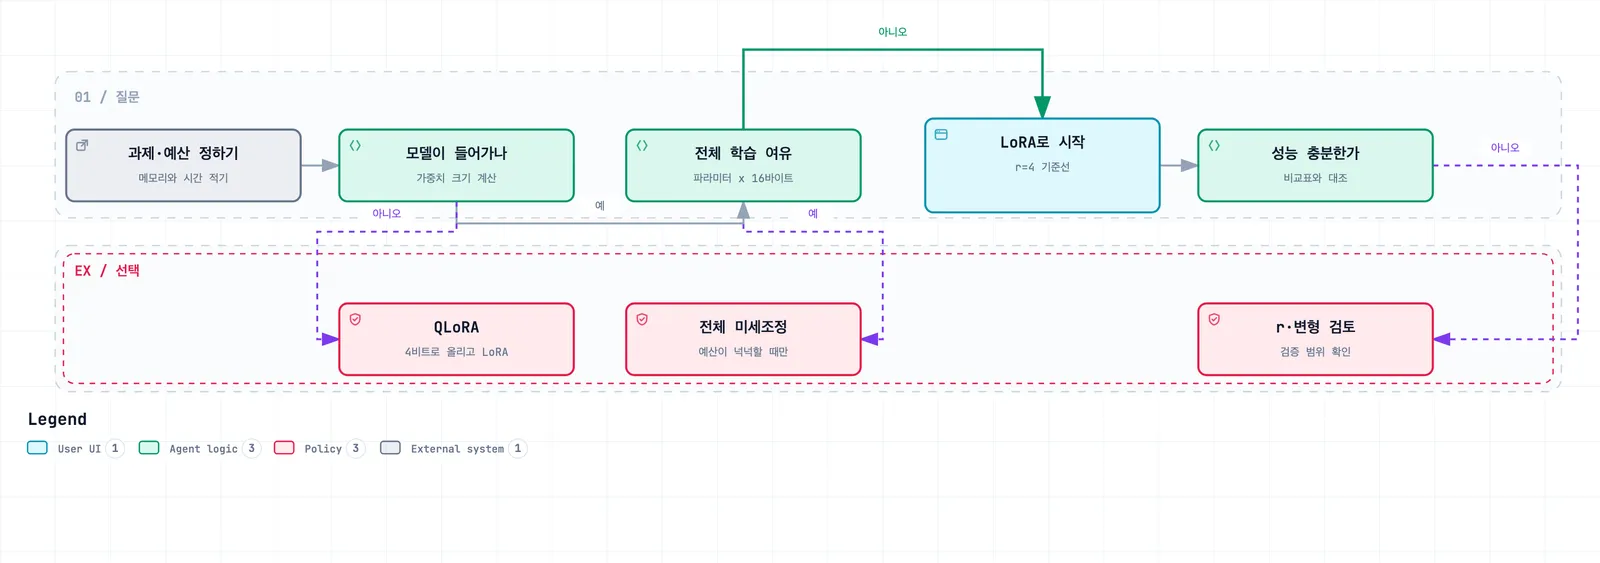
- 1단계, 예산부터 적는다. “메모리 몇 GB, 학습 시간 몇 시간”을 숫자로 먼저 쓴다. 기법 이름보다 조건이 먼저다
- 2단계, 모델이 들어가나: 파라미터 수 x 4바이트(32비트), 안 되면 x 2바이트(16비트)로 가중치 크기를 계산해 예산과 비교한다. 둘 다 안 들어가면 QLoRA(x 0.5바이트)로 간다. 그래도 안 되면 더 작은 모델을 고른다
- 3단계, 전체 학습 여유가 있나: 파라미터 수 x 16바이트가 예산 안이고 데이터도 넉넉하면 전체 미세조정도 선택지다. 도내 소규모 조직 조건에서는 대부분 여기서 “아니오”다
- 4단계, LoRA r = 4로 기준선을 만든다. 비교표에서 위치를 확인한다
- 5단계, 성능이 부족하면 랭크를 올리거나 변형 기법을 검토한다. 이때도 예산 안에 있는지 다시 계산한다
[이론] 저랭크 근사가 왜 전체 미세조정을 대체할 수 있는지 작은 수치 예로 확인하고(768 x 768 = 589,824개 vs 6,144개 계산), 각 변형이 무엇을 바꾸는지 대조
[구현] 어댑터가 붙은 미세조정 코드를 받아 실행하고, 학습 파라미터 수가 전체 미세조정 대비 얼마나 줄었는지 출력값으로 확인. 랭크 값 하나를 바꿔 변화를 관찰. r을 4에서 8로 올리면 어댑터 파라미터는 정확히 두 배가 된다(147,456 → 294,912개). 분류 헤드 592,130개는 그대로라 출력되는 전체 학습 파라미터는 887,042개로, 두 배가 아니다. 성능도 두 배가 되는지는 출력으로 확인한다
[실무] 과제 1 - 한국어 데이터셋에서 PEFT 기법 한 가지를 돌려보고 제공된 비교표에서 자기 결과의 위치를 해석. 도내 소규모 조직이 감당할 메모리·시간 예산을 조건으로 명시하고 그 안에서 선택 근거를 대는 것이 채점 대상 (3단계 부분점수 적용)
□ 실습 조건과 측정 범위
- 입력: 위키백과 「제주특별자치도」 고정 판 42464087, 공개 한국어 문서의 52토큰 이내 조각. 원문 URL·판 번호·CC BY-SA 4.0 표기, 원본은 실행 때 다운로드
- label: 보이는 텍스트에
기후,지형,화산,해안,한라산중 하나가 포함되면 1, 없으면 0인 교수 규칙 기반 proxy. 감성 정답이나 사람이 판정한 실제 주제 gold가 아님 - 서로 다른 원문 문단에서 class별 학습 4개·평가 2개 선택, 전체 학습 8개·평가 4개. 같은 문단을 양쪽에 넣지 않도록 문단 ID 기준 분리
- KoELECTRA base 한국어 tokenizer·분류 모델 재사용, CPU 스레드 2, 입력 최대 64토큰·배치 2·설정별 6 step으로 규모 제한
- r = 4와 선택 rank를 각각 새 모델로 실제 학습·평가. 기본 선택은 r = 8이며 TODO 미수정 상태에서도 두 설정의 비교 완료
- 출력: 초기·학습 후 proxy 정확도, trainer 학습 구간 시간, 어댑터·분류 헤드·전체 학습 파라미터 수, 파라미터 텐서 bytes
- proxy 평가 4개이므로 1개 차이가 정확도 0.25. 제주 전체 데이터의 일반 성능으로 해석 불가
- 텐서 bytes는 저장 크기. 활성값·gradient·optimizer 상태와 peak 메모리는 포함하지 않은 수치. 위의 16바이트 규칙과 메모리 그림은 이론 어림, 실제 peak 실측과 구별
- 전체 미세조정은 파라미터 수만 계산. 전체 학습의 시간·정확도·peak 메모리는 미측정, LoRA 시간과 비교한 속도 향상을 만들어 쓰지 않는 원칙
- 제공된 비교표에는 LoRA 실측과 단위를 채우되, 전체 미세조정의 실행하지 않은 칸은 “미측정”. 이론 어림과 실측을 같은 칸의 숫자로 섞지 않는 규칙
□ 과제 1 따라 하기 체크리스트
- 1단계, 조건 적기: “전용 GPU 없음, 무료 실습 환경, 학습 시간 30분 이내”처럼 내가 상정한 조직의 예산을 첫 줄에 쓴다 (예시 조건이며, 각자 정한다)
- 2단계, 기준선 실행: 노트북을 TODO 그대로 끝까지 실행해 학습 파라미터 수와 평가 정확도를 기록한다
- 3단계, 한 가지만 바꾸기: 랭크 r 하나만 바꿔 다시 실행한다. 두 가지를 동시에 바꾸면 무엇 때문에 달라졌는지 알 수 없다
- 4단계, 숫자로 비교: 학습 파라미터 수, 전체 대비 비율, proxy 정확도, 학습 구간 시간, 파라미터 bytes와 단위를 기록. 실행하지 않은 full FT 시간·정확도와 peak 메모리는 미측정으로 유지
- 5단계, 위치 해석: 제공된 비교표에서 내 결과가 어디쯤인지, 1단계의 예산 안에서 왜 이 설정을 골랐는지 문장으로 쓴다
- 채점은 “가장 높은 점수”가 아니라 조건과 선택 근거가 숫자로 연결되는가를 본다
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. 일부만 학습하는 LoRA는 전체 미세조정보다 성능이 늘 떨어지는가?
늘 그런 것은 아니다. LoRA 논문은 여러 모델에서 전체 미세조정과 비슷하거나 더 나은 품질을 보고했다. 다만 과제와 데이터에 따라 달라지므로, 내 과제에서는 비교표로 직접 확인한다.
Q2. 랭크 r은 클수록 좋은가?
어댑터 파라미터는 r에 정확히 비례해서 늘지만, 전체 메모리는 얼린 가중치가 대부분이라 조금만 는다. 성능이 r만큼 오르는지는 보장되지 않는다. 작게 시작해서, 올렸을 때 얻는 것이 늘어난 비용만큼인지 숫자로 판단한다.
Q3. QLoRA는 모든 계산을 4비트로 하는가?
아니다. 얼린 가중치를 4비트로 보관하고, 계산할 때는 잠깐 풀어서 쓴다. 학습하는 LoRA 어댑터는 더 정밀한 형식으로 유지한다. 그래서 메모리는 크게 줄이면서 품질 손실을 줄인다.
Q4. B를 0으로 시작하면 옆길이 영원히 0으로 남지 않나?
남지 않는다. B·A의 결과는 처음에 0이지만, A가 0이 아니므로 B를 어느 쪽으로 바꾸면 손실이 줄지(그래디언트)는 계산된다. 첫 갱신부터 B가 0에서 벗어난다.
Q5. 최신 변형 기법을 쓰면 과제 점수를 더 받는가?
아니다. 채점 대상은 기법의 새로움이 아니라 예산 조건 안에서의 선택 근거다. 검증이 부족한 기법을 골랐다면 그 위험도 함께 적어야 한다.
스스로 점검
Section titled “스스로 점검”- 768 x 768 가중치에 r = 8 LoRA를 붙이면 파라미터는 몇 개이고, 통째로 학습하는 양의 몇 퍼센트인가?
- 12층 모델의 query와 value에 r = 8을 붙이면 어댑터 파라미터는 모두 몇 개인가?
- 파라미터 1억 개를 전체 미세조정할 때 파라미터당 16바이트로 어림하면 몇 바이트인가?
- 70억 개 모델의 가중치를 4비트로 저장하면 약 몇 GB인가? (보조 숫자는 무시)
- 벡터 (6, 8)의 크기와 방향은?
정답 보기
- 8 x 1,536 = 12,288개, 12,288 / 589,824 = 약 2.08%
- 12,288 x 2 x 12 = 294,912개 (r = 4일 때 147,456개의 정확히 2배)
- 100,000,000 x 16 = 1,600,000,000바이트 (1.6GB)
- 7,000,000,000 x 0.5 = 3,500,000,000바이트, 3.5GB
- 크기는 √(36 + 64) = 10, 방향은 (0.6, 0.8). (3, 4)와 방향이 같고 크기만 2배다
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 한 줄 뜻 |
|---|---|
| 미세조정 | 사전학습 모델을 내 과제 데이터로 추가 학습하는 일 |
| PEFT | 파라미터 일부만 학습해 미세조정 비용을 줄이는 기법의 총칭 |
| 동결 (freeze) | 가중치를 학습하지 않고 그대로 두기 |
| 랭크 r | 변화량을 몇 가지 패턴으로 표현할지 정하는 수. LoRA의 크기 손잡이 |
| LoRA | 얼린 가중치 옆에 작은 행렬 A, B의 옆길을 붙여 그것만 학습 |
| α / r | 옆길의 목소리 크기를 정하는 스케일 |
| 병합 | 학습이 끝난 옆길을 원래 가중치에 더해 모델 하나로 만들기 |
| 양자화 | 숫자를 더 적은 비트로 적어 크기를 줄이기 |
| QLoRA | 4비트로 보관한 모델 위에서 LoRA를 학습 |
| NF4 | 값이 몰린 곳에 눈금을 촘촘히 둔 4비트 형식 |
| DoRA | 가중치를 크기와 방향으로 나눠 따로 학습 |
| VB-LoRA | 모든 층이 공용 벡터 은행에서 재료를 골라 어댑터를 구성 |
| WaveFT | 웨이블릿(무늬) 영역에서 변화량을 희소하게 학습 |
실습 노트북
Section titled “실습 노트북”
- 제주 공개 한국어 문서 조각에 규칙 기반 proxy label을 붙인 제공 골격. 기존 한국어 분류 모델에 LoRA를 붙여 CPU에서 r = 4와 r = 8 각각 실제 학습·평가
- 바꿀 곳은 rank 값 한 곳. 같은 제공 trainer로 재학습과 평가까지 실행하므로 파라미터 수만 출력하고 비교를 끝내지 않는 구조
- 실험 결과는
week03-results.json으로 저장. 성능은 키워드 규칙의 작은 proxy 정확도이며 감성 분석 성능이 아님 - 파라미터 저장 bytes와 학습 구간 시간만 기록, full FT 학습과 peak 메모리 미측정. 무료 CPU 환경에서 실행, 모델·원문 다운로드 오류를 숨기는 fallback 없음
과제 1 안내와 비교표는 assignments/week-03/에 있다.