
5주차: 평가 시스템과 지표가 측정하지 못하는 것
평가 시스템과 지표가 측정하지 못하는 것
□ 이 주차가 놓이는 자리
- 4주차 끝에서 프롬프트 후보를 자동 채점으로 고르는 루프를 봤다. 그때 의문 하나가 남았다. “채점 기준을 누가, 무엇으로 정하는가?” 이번 주는 그 질문을 정면으로 다룬다
- 채점 기준이 잘못되면 루프는 잘못된 목표를 아주 열심히 최적화한다. 그렇다면 모델이 맞았는지 틀렸는지는 무엇으로 판단해야 옳은가
- 답은 하나가 아니다. 채점하는 “자(ruler)“마다 보는 것과 놓치는 것이 다르다. 이번 주는 네 가지 자를 차례로 본다
| 자 | 보는 것 | 놓치는 것 |
|---|---|---|
| 정확도·F1 | 라벨이 정답과 같은가 | 왜 틀렸는지, 얼마나 치명적인지, 근거가 옳은지 |
| LLM judge | 출력이 루브릭에 비춰 그럴듯한가 | 그럴듯하게 포장된 오답 (false acceptance) |
| pass@k | k번 시도 안에 한 번이라도 맞히는가 | 곡선 한 점만 보면 “한 번에 맞히는 효율”과 “닿을 수 있는 범위”가 섞인다 |
| 사람 | 근거, 맥락, 실제 비용 | 속도와 일관성. 대량 채점에는 너무 비싸다 |
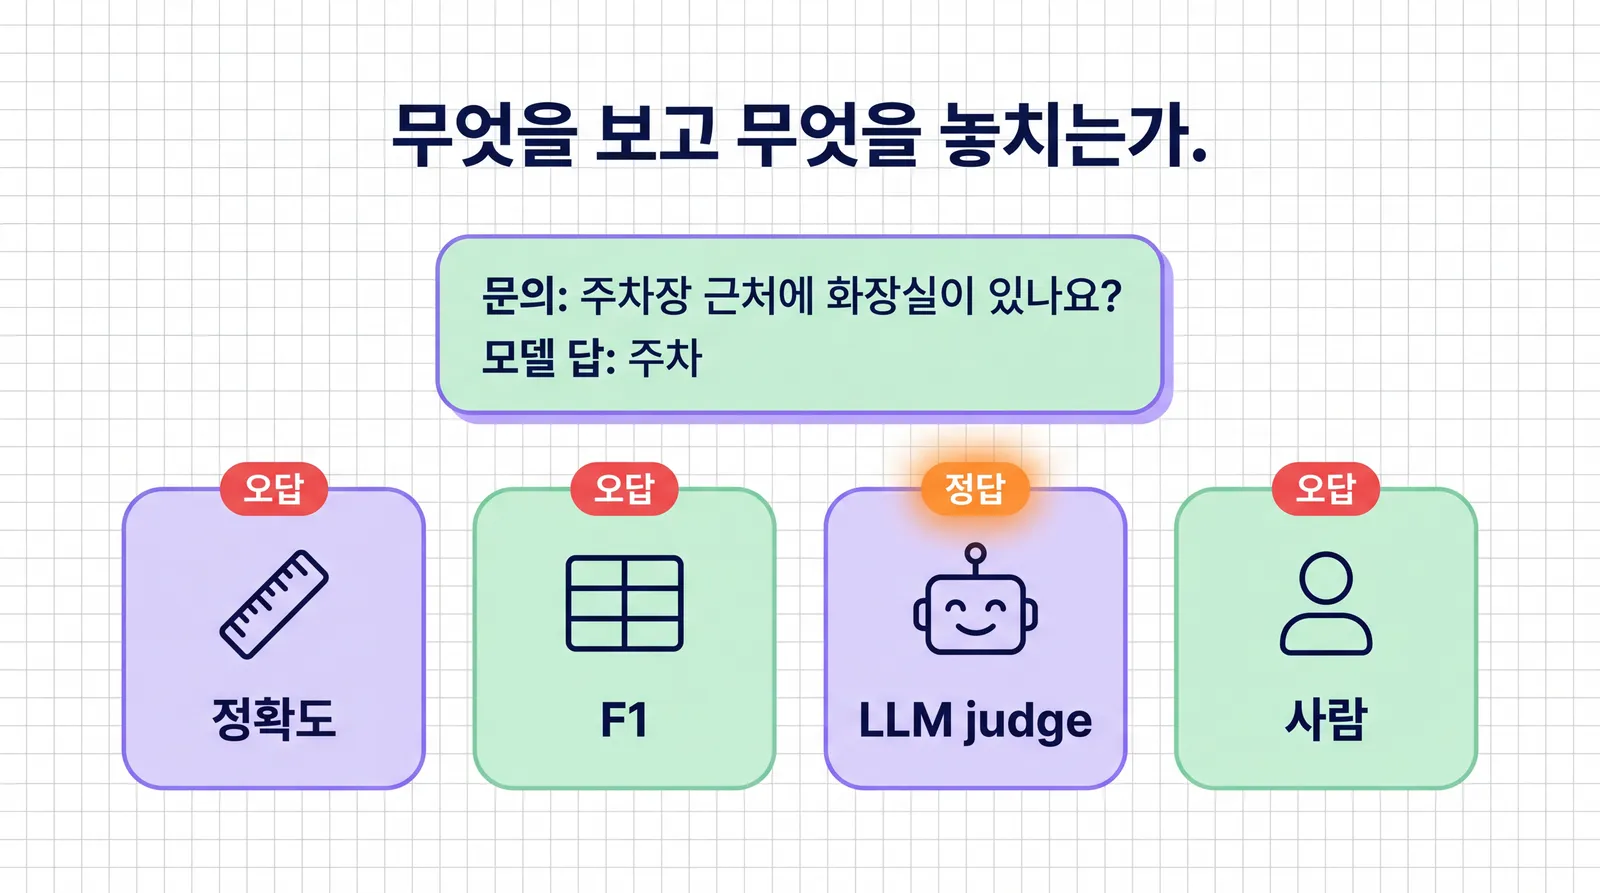
- 결론을 먼저 말하면 이렇다. 완벽한 자는 없다. 그래서 지표를 쓸 때마다 “이 지표가 무엇을 놓치는가”를 같이 적는다. 대면 시간의 Q4 근거 기준이 바로 이 습관이다
□ 이번 주가 답하는 질문
- 정확도 0.83이면 잘하는 모델인가 (지표가 보는 것 vs 놓치는 것)
- LLM judge가 통과시켰는데 사람이 “아니오”라 한다면, 누구를 믿어야 하는가 (false acceptance의 구조)
- 학습 뒤 pass@1이 올랐다. 모델이 새 능력을 얻은 것인가, 원래 할 줄 알던 것을 더 자주 하게 된 것인가 (천장 vs 앞머리)
- 임계값 0.5와 0.95 중 어느 것이 “정답”인가 (둘 다 아니다. 선택일 뿐)
□ 읽기 안내 - 이 노트의 어디와 이어지나
| 읽기 | 이 노트에서 다루는 곳 |
|---|---|
| SLP3 4.10 Test sets and Cross-validation | 채점셋을 들여다보며 고치면 생기는 일 |
| SLP3 4.11 Statistical Significance Testing | 1문항 차이를 믿어도 되는가 |
| SLP3 11.6 Evaluating Question Answering | 자유 서술 답의 채점 (exact match, token F1) |
| pass@k 원전 arXiv:2107.03374 | pass@k와 무편 추정량 |
| RLHF Book ch16 Evaluation (선택) | 이번 주 전체 |
□ 채점셋의 출처와 실측 범위
- 4·5주차의 제주 관광 문의 24건: 저장소에 제공된 교수 작성 교육용 fixture로 취급. 공개 포털에서 수집한 실제 문의라는 출처는 확인되지 않은 상태
- 장소명과 상황을 제주 맥락으로 구성한 분류 연습용 문장. 실제 방문객 기록·관광지 운영 사실·기업 제공 데이터 아님
- 본문의 정확도·judge·pass@k는 이 fixture에 대한 모델 실행값. 교육 예시의 문장·정답 라벨과 모델 출력은 서로 다른 자료
- 라벨 기준: 주차·시설·요금으로 교수가 정한 교육용 기준. 겹치는 문의는 기준과 한계를 기록하며 실제 문의의 참값으로 승격하지 않기
- 공개 데이터 실무 활동은 아래 벤치마크 후보표의 별도 활동. 실제 원문·수집 경로·권리를 확보한 경우에만 공개 데이터 분석이라고 보고
온라인 (2시수)
Section titled “온라인 (2시수)”강의: 전통 지표 vs LLM judge - 무엇을 보고 무엇을 놓치는가
Section titled “강의: 전통 지표 vs LLM judge - 무엇을 보고 무엇을 놓치는가”□ 채점에도 사람이 필요하다 - 4주차에서 넘어온 의문
- 4주차의 자동 채점 루프를 떠올려 보자. 후보 프롬프트를 만들고, 채점셋을 돌려, 점수로 고른다. 채점 스크립트는 코드가 돌리지만, “무엇을 점수로 삼을지”는 사람이 정한다. 정확도를 점수로 삼을지, 형식 준수율을 삼을지에 따라 1등 후보가 달라진다
- 이 질문에 대답하는 도구가 지표(metric) 다. 모델의 출력이 좋은지 나쁜지를 숫자 하나로 재는 자다
- 지표가 필요한 이유는 채점을 자동으로, 대량으로, 반복해서 해야 하기 때문이다. 사람이 한 건씩 채점하면 느리고 비싸고 사람마다 기준이 흔들린다. 하지만 기준을 코드로 옮기는 순간 사람이 보던 것 중 일부가 반드시 빠진다
- 그래서 이번 주는 관점을 거꾸로 잡는다. 지표를 완벽한 도구로 보지 않고, 각 지표가 무엇을 보고 무엇을 놓치는지를 먼저 기록한다
□ 읽기 준비 - 모든 분류 지표는 네 칸짜리 표에서 나온다
- 분류 지표를 이해하는 가장 빠른 길은 혼동행렬(confusion matrix) 한 장이다. 정답과 모델 예측을 가로세로로 놓고 건수를 센다
- 예로 “긴급 문의 탐지”를 보자. 찾으려는 쪽(긴급)을 양성(positive), 나머지(일반)를 음성(negative) 이라 부른다
| 실제로 긴급 | 실제로 일반 | |
|---|---|---|
| 모델이 “긴급” | TP (진짜 양성). 긴급을 긴급으로 | FP (거짓 양성). 일반을 긴급으로 올림. 오경보 |
| 모델이 “일반” | FN (거짓 음성). 긴급을 일반으로 흘림. 놓침 | TN (진짜 음성). 일반을 일반으로 |
- 이 네 칸으로 세 지표를 만든다
정확도 (accuracy) = (TP + TN) / 전체정밀도 (precision) = TP / (TP + FP) "긴급이라고 외친 것 중 진짜 긴급의 비율"재현율 (recall) = TP / (TP + FN) "진짜 긴급 중 잡아낸 비율"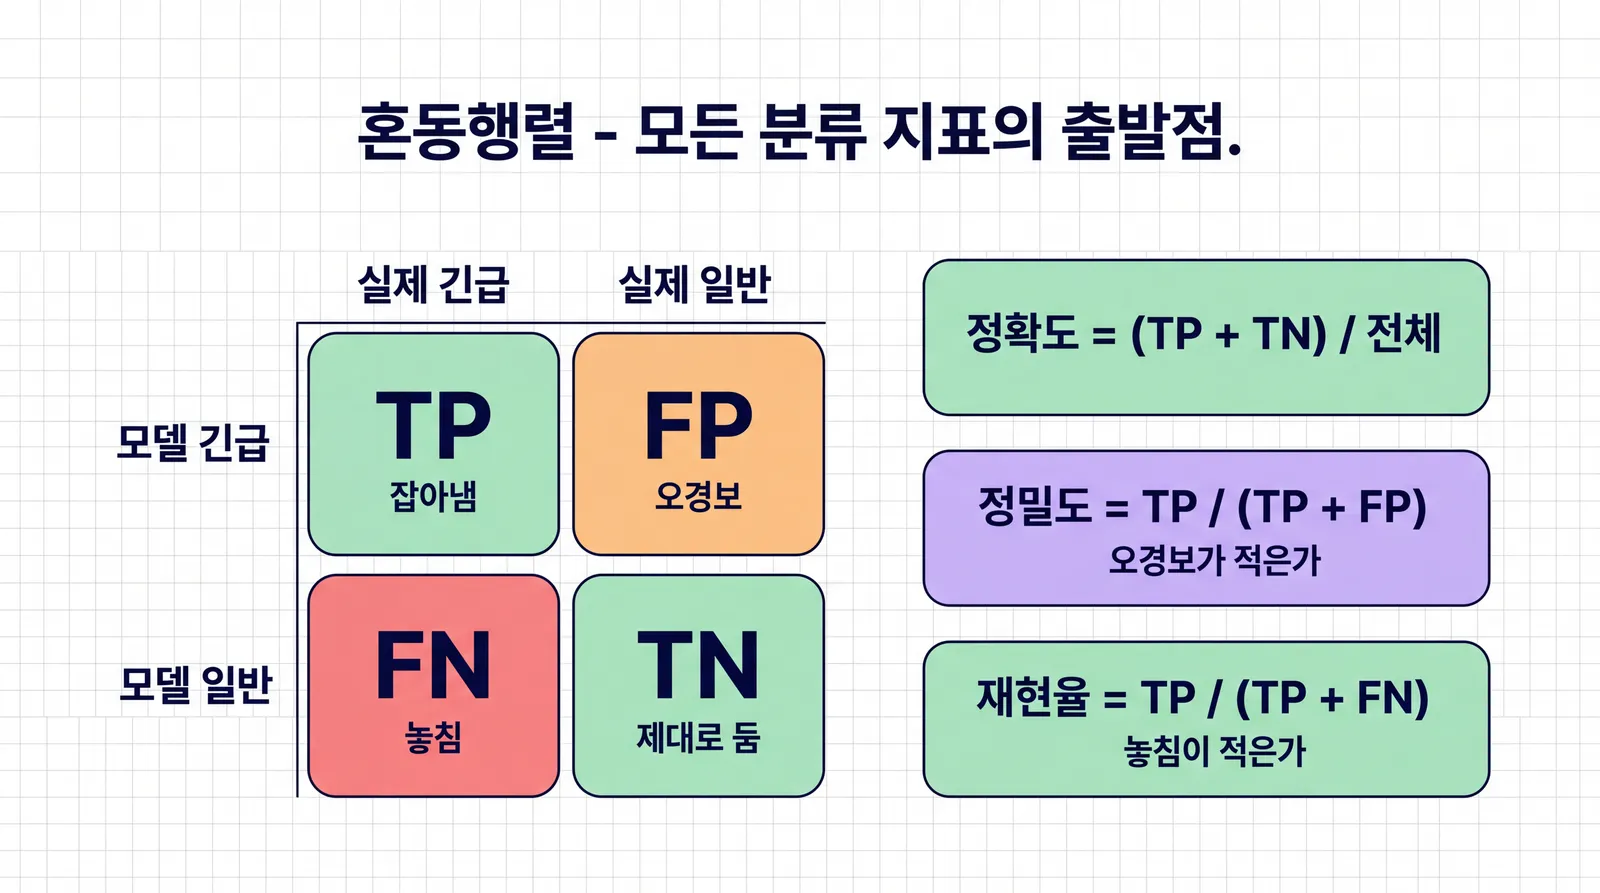
- 정밀도가 낮다는 것은 오경보가 많다는 뜻이고, 재현율이 낮다는 것은 놓침이 많다는 뜻이다. 두 실수는 성격이 다르다. 안전 신고를 놓치는 것(FN)과 일반 문의에 출동하는 것(FP)은 비용이 다르다
○ 정확도의 함정 - 드문 부류가 중요할 때
- 문의 1,000건 중 긴급이 20건이라 하자. 아무것도 배우지 않은 모델이 무조건 “일반”이라고만 답하면 어떻게 될까
- TP 0, FN 20, FP 0, TN 980
- 정확도 = 980 / 1,000 = 0.98
- 긴급 재현율 = 0 / 20 = 0
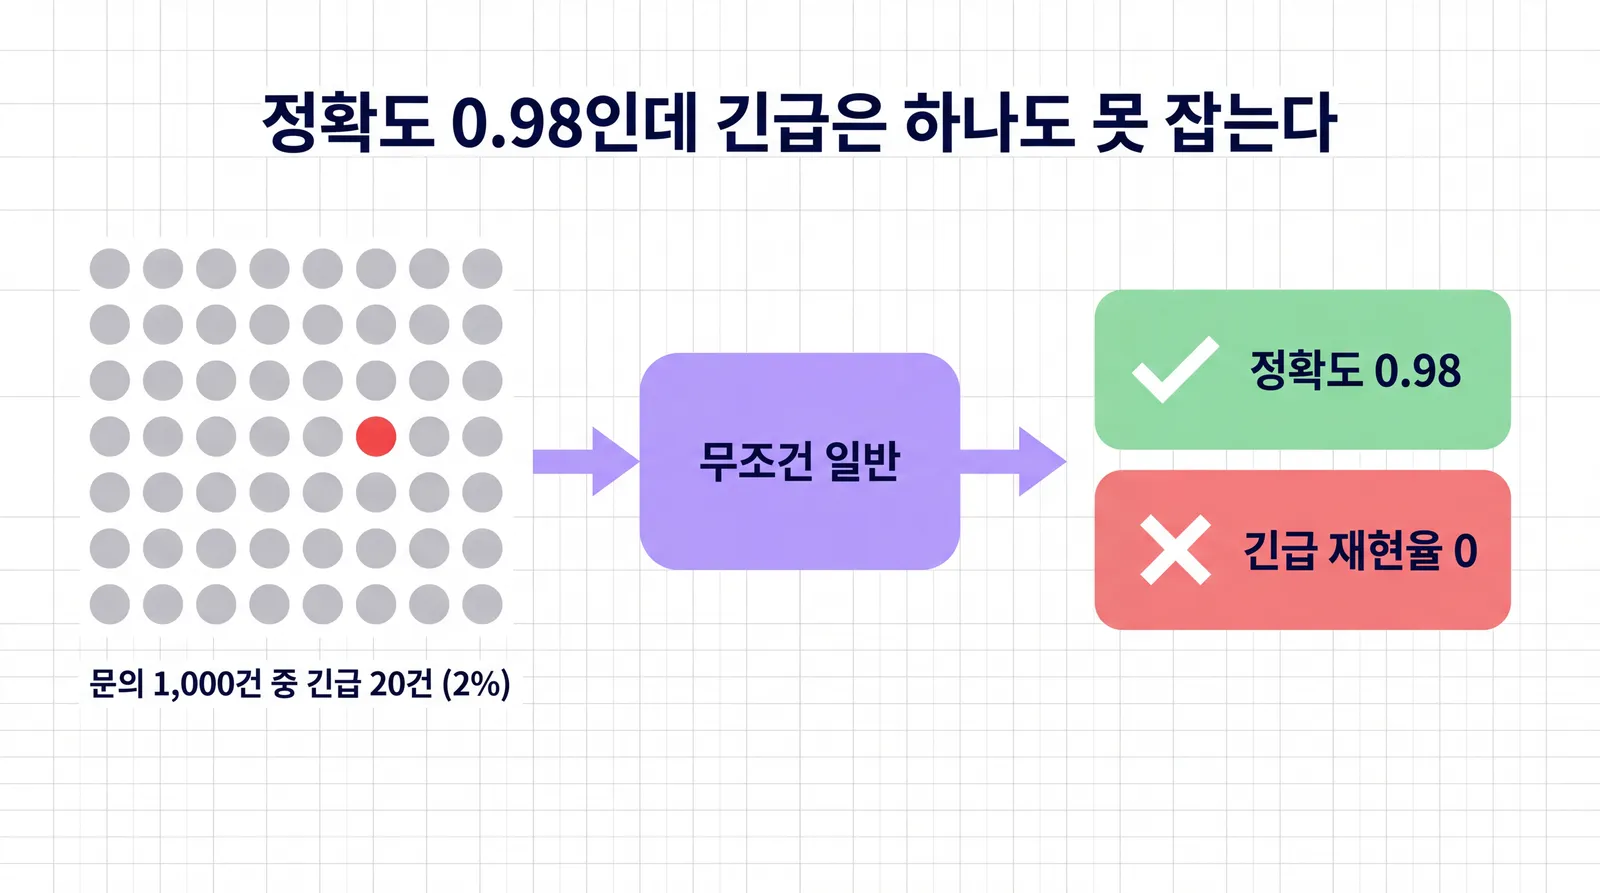
- 정확도 0.98인데 긴급은 하나도 못 잡는다. 찾으려는 부류가 드물수록 정확도는 거의 아무것도 말해 주지 않는다. 그래서 부류별 정밀도·재현율을 따로 본다
□ 정확도와 F1 - 빠르지만 “라벨 한 칸”만 본다
- 정확도는 전체 중 라벨이 정답과 같은 비율이다. 문의 24건 중 20건을 맞히면 20/24 = 0.83이다
- 장점은 분명하다. 계산이 단순하고, 코드로 대량 채점이 쉽고, 프롬프트 후보 100개를 밤새 돌려도 모두 같은 자로 잰다
- 한계도 분명하다. 정확도는 “라벨이 일치했는가” 한 가지만 본다. 그래서 두 가지를 놓친다
- 첫째, 왜 틀렸는지, 얼마나 치명적인지 모른다. 휠체어 접근성 문의를 주차로 보낸 실수와 파라솔 문의를 잘못 보낸 실수가 똑같이 “1건”이다
- 둘째, “거의 맞음”을 표현할 길이 없다. 라벨은 틀렸지만 근거는 훌륭한 경우와, 라벨도 근거도 엉터리인 경우가 같은 점수다
- F1은 한 부류에 대해 정밀도와 재현율을 조화평균한 값이다
F1 = 2 x 정밀도 x 재현율 / (정밀도 + 재현율) = 2TP / (2TP + FP + FN)- 산술평균 대신 조화평균을 쓰는 이유는 둘 중 작은 쪽에 끌려가게 하기 위해서다. 정밀도 1.0, 재현율 0.1이면 산술평균은 0.55지만 F1은 0.18이다. 한쪽만 잘해서는 F1이 오르지 않는다
- 부류가 여럿이면 부류마다 F1을 구해 단순 평균한다. 이것을 macro-F1이라 한다. 드문 부류도 같은 무게로 들어간다
- 참고로, 문항마다 라벨을 딱 하나 고르는 다중 분류에서 모든 부류의 TP·FP·FN을 합쳐 한 번에 계산하는 micro-F1은 정확도와 같은 값이 된다. 그래서 치우침을 보려면 macro 쪽이나 부류별 값을 본다
○ 실측 예 - 4주차 프롬프트 A의 혼동행렬
- 4주차 실습의 프롬프트 A(지시문만)를 제주 관광 문의 채점셋 24건에 돌린 결과다. 이번 주 실습 노트북 1-4에서 그대로 재현된다
| 정답 \ 예측 | 주차 | 시설 | 요금 |
|---|---|---|---|
| 주차 (8건) | 8 | 0 | 0 |
| 시설 (8건) | 0 | 8 | 0 |
| 요금 (8건) | 0 | 4 | 4 |
- 대각선(굵은 칸)이 맞힌 것이다. 정확도는 (8 + 8 + 4) / 24 = 0.83
- 부류별로 쪼개 보자
| 부류 | TP | FP | FN | 정밀도 | 재현율 | F1 |
|---|---|---|---|---|---|---|
| 주차 | 8 | 0 | 0 | 1.00 | 1.00 | 1.00 |
| 시설 | 8 | 4 | 0 | 0.67 | 1.00 | 0.80 |
| 요금 | 4 | 0 | 4 | 1.00 | 0.50 | 0.67 |
- macro-F1 = (1.00 + 0.80 + 0.67) / 3 = 0.82
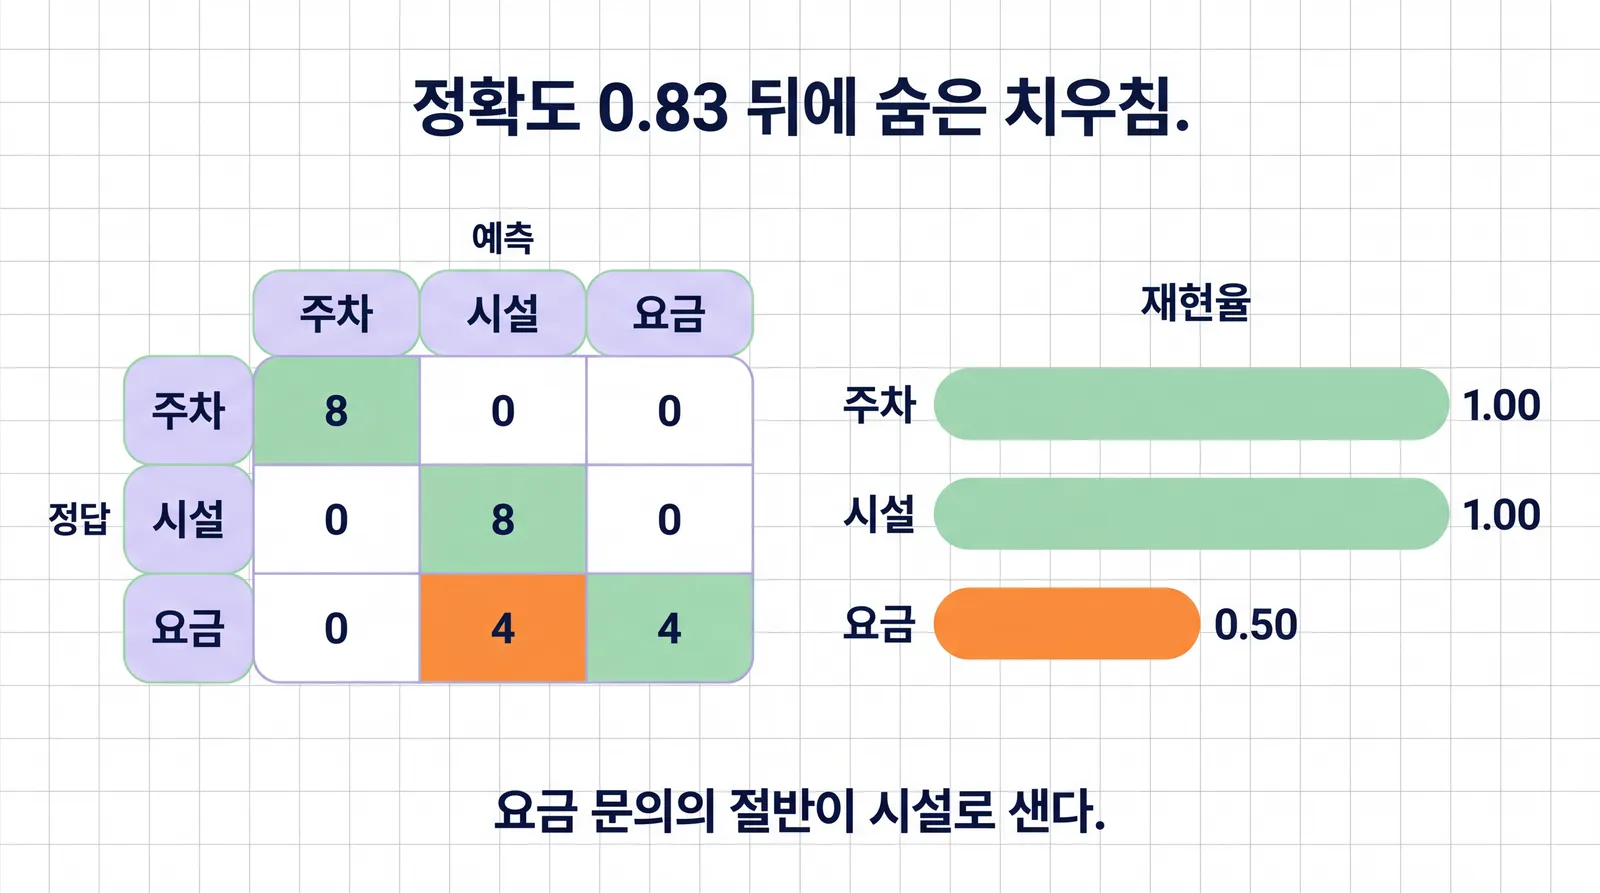
- 정확도 0.83만 보면 “고르게 잘한다”로 읽힌다. 부류별로 보면 이야기가 달라진다. 요금 문의의 절반이 시설로 샌다. 틀린 4건(“입장료가 얼마예요?”, “입장료 할인이 있나요?”, “트레킹은 무료인가요?”, “청소년은 입장료가 할인되나요?”)이 모두 요금 -> 시설 방향이다. 시설의 정밀도가 0.67로 떨어진 것도 같은 4건 때문이다
- 같은 채점셋에서 4주차 프롬프트 B(예시 2개)도 정확도가 20/24 = 0.83이다(4주차 막대그래프의 A 0.62, B 0.83은 설명용 예시였고, 노트북 실측은 둘 다 0.83이다). 그런데 B는 주차 2건, 요금 2건을 틀린다. 정확도가 같다고 같은 모델이 아니다. 실수의 방향이 다르고, 어느 쪽이 더 비싼지는 운영이 정한다
- 이것이 F1이 하는 일이다. 치우침의 방향을 보여 준다. 그래도 그 4건이 왜 틀렸는지는 한 건씩 봐야 안다
○ 자유 서술 답은 어떻게 채점하나 - exact match와 token F1
- 라벨이 아니라 문장으로 답하는 과제(질의응답, 안내 응답 생성)에서는 두 방법을 흔히 쓴다 (SLP3 11.6)
- exact match (EM): 예측이 정답과 글자 그대로 같은 비율. 보기 중 고르는 문제처럼 답의 형태가 정해진 경우에 맞다
- token F1: 예측과 정답을 단어 주머니로 보고 겹치는 단어로 정밀도·재현율·F1을 구한다. 부분적으로 맞은 답에 부분 점수를 준다
- 짧은 예로 보자. 질문은 “짐 보관함은 어디에 있나요?”, 정답은 “매표소 옆”이다 (띄어쓰기 단위로 셈)
| 예측 | EM | 겹친 단어 | 정밀도 | 재현율 | token F1 |
|---|---|---|---|---|---|
| 매표소 옆 | 1 | 2 | 2/2 | 2/2 | 1.00 |
| 매표소 바로 옆 | 0 | 2 | 2/3 | 2/2 | 0.80 |
| 매표소 옆 아님 | 0 | 2 | 2/3 | 2/2 | 0.80 |
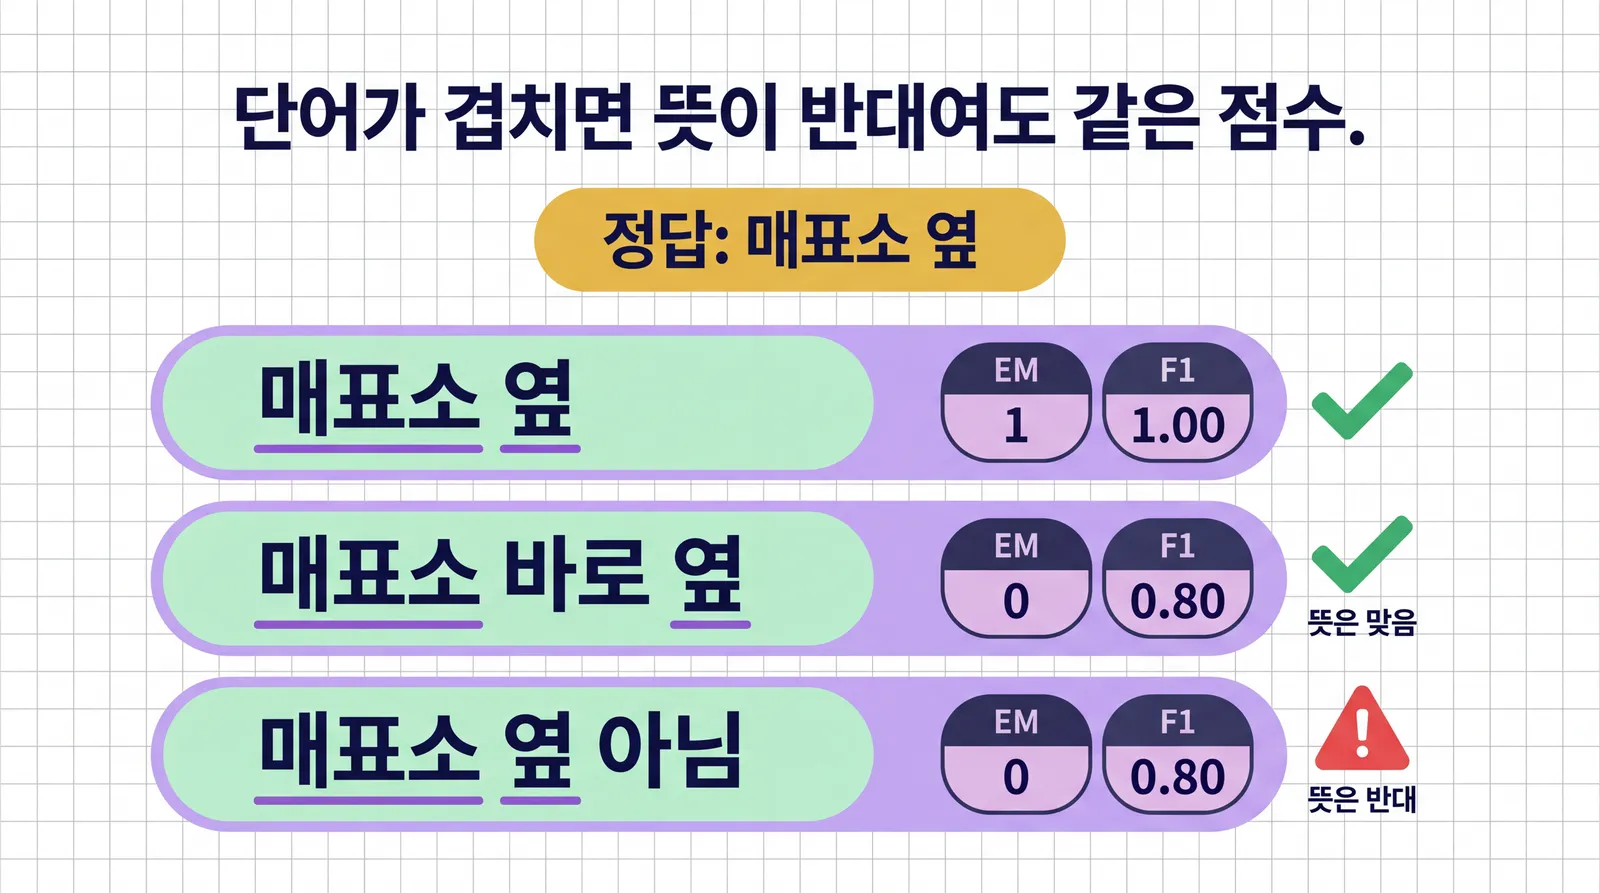
- 두 번째 답은 뜻이 맞는데 EM은 0이다. token F1이 그 억울함을 덜어 준다. 그런데 세 번째 답은 뜻이 정반대인데 token F1이 두 번째와 똑같다. 단어가 겹치는지만 보고 뜻은 보지 않기 때문이다. 자유 서술 채점에 LLM judge가 등장한 이유가 여기 있다
○ 지표별 판정을 한눈에 보기 - 사례 카드
- 정확도, F1, LLM judge, 사람이 같은 문항을 어떻게 채점하는지 대조해 보자. 카드를 눌러 보라 (모델 출력과 판정은 설명용 예시)
예시 카드를 눌러 보세요. 같은 문항을 네 채점자가 각각 어떻게 판정하는지 표가 바뀝니다. (모델 출력과 판정은 설명용 예시)
| 채점자 | 보는 것 | 이 예시의 판정 | 놓치는 것 |
|---|---|---|---|
| 정확도 | 라벨이 정답과 같은가 | 정답 | 왜 틀렸는지, 얼마나 치명적인지 |
| F1 | 부류별 TP·FP·FN 개수 | 요금 TP +1 | 문항 하나하나의 사정, 라벨 밖의 근거 |
| LLM judge | 출력이 루브릭에 비춰 그럴듯한가 | 정답 | 그럴듯하게 포장된 오답 |
| 사람 | 근거, 맥락, 실제 비용 | 정답 | 속도와 일관성 (대량 채점엔 비쌈) |
라벨도 근거도 맞다. 네 채점자가 모두 같은 판정을 내린다. 갈등이 없는 문항이다.
- 예시 2는 치명도의 문제다. 모두가 틀렸다고 보지만 정확도와 F1은 그것을 “1건”으로만 센다. 정확도 0.83 뒤에 숨은 4건이 휠체어 접근성 문의였다면 이야기가 완전히 달라진다
- 예시 3은 근거의 문제다. 라벨이 맞으면 라벨만 보는 지표는 모두 통과시킨다
- 예시 4가 다음 절의 주제다. 라벨이 틀렸는데 judge가 그럴듯한 근거에 넘어가 통과시켰다. 이것이 false acceptance(오답 승인)다
□ 채점셋을 들여다보며 고치면 생기는 일 - 개발셋과 시험셋
- 4주차 루프를 다시 보자. 24건으로 점수를 재고, 틀린 문항을 보며 프롬프트를 고치고, 다시 잰다. 이것을 여러 번 반복하면 프롬프트가 그 24건에 맞춰진다. 점수는 오르지만 새 문의에서도 오른다는 보장은 없다. 시험 문제를 미리 보고 공부한 것과 같다
- 그래서 데이터를 역할별로 나눈다 (SLP3 4.10)
- 개발셋(devset): 들여다보고 고치는 데 쓰는 데이터. 4주차 채점셋 24건이 여기에 해당한다
- 시험셋(test set): 다 고친 뒤 마지막에 한 번만 재는 데이터. 한 번도 들여다보지 않은 것이어야 한다
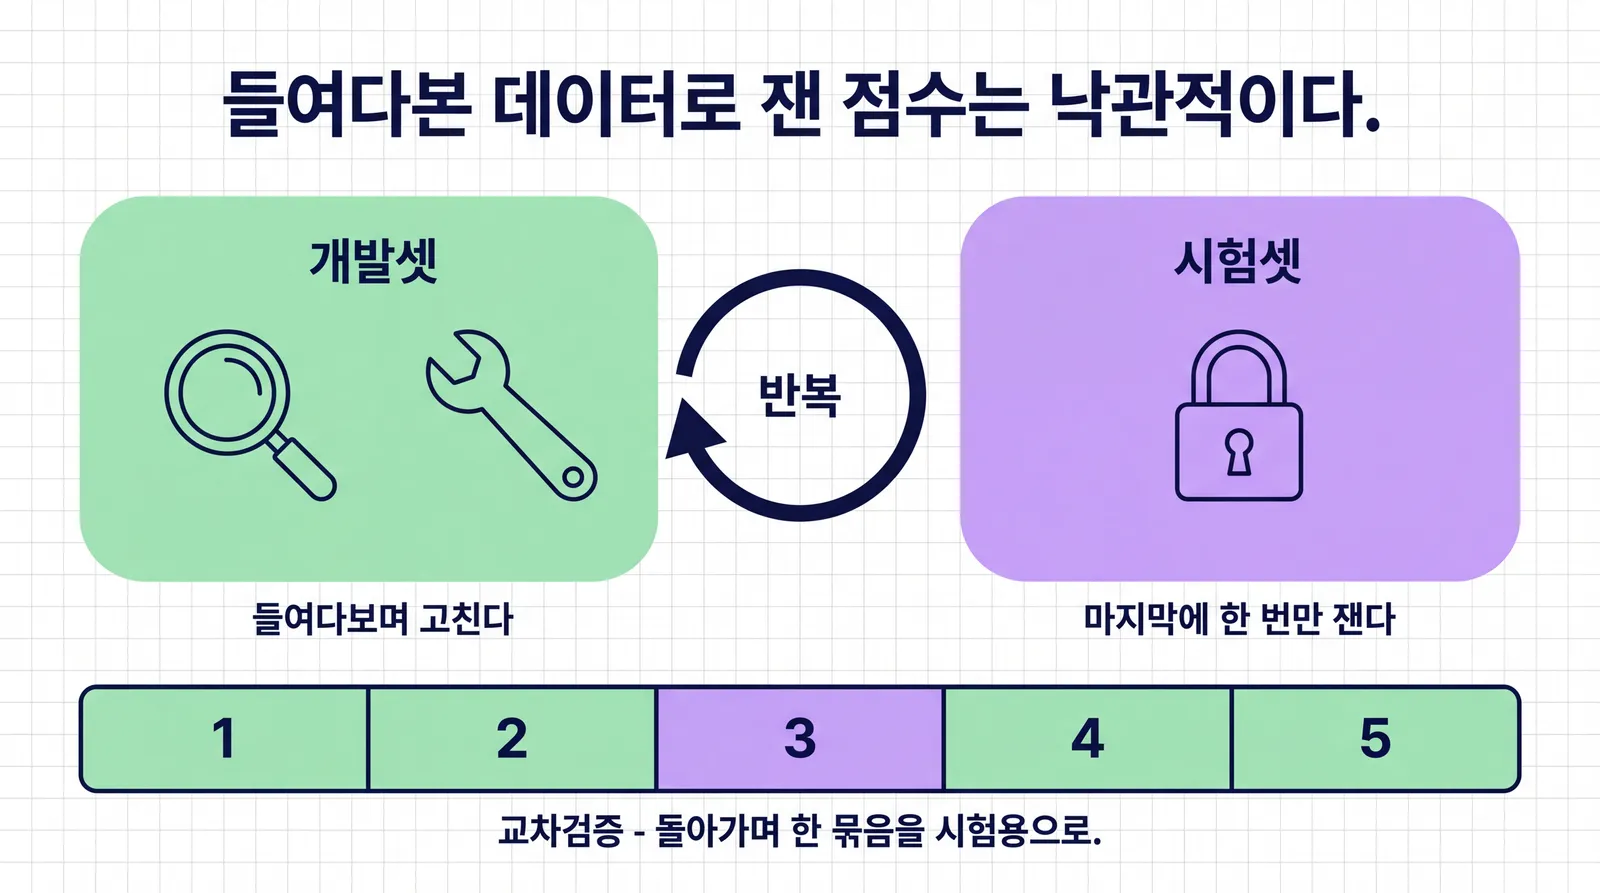
- 데이터가 적어 떼어 두기 아까우면 교차검증(cross-validation) 을 쓴다. 데이터를 k개 묶음(fold)으로 나눠, 돌아가며 한 묶음을 시험용으로 쓰고 나머지로 개발한 뒤 k개 점수를 평균한다. 여기 k는 뒤에 나올 pass@k의 k와 다른 k다
- 실무 규칙 하나. 시험셋 점수를 보고 다시 고쳤다면, 그 시험셋은 이제 개발셋이다. 새 시험셋이 필요하다
□ 1문항 차이를 믿어도 되는가 - 통계적 유의성
- 두 후보 X와 Y가 있다고 하자. X가 21/24, Y가 20/24다. 차이는 0.042, 1문항이다. “X가 낫다”고 말해도 될까
- 두 점수의 차이를 효과 크기(effect size) δ라 한다. 문제는 이 δ가 우연히 생겼을 수 있다는 것이다. 채점셋 24건이 조금만 달랐어도 뒤집힐 수 있다
- SLP3 4.11이 소개하는 쌍체 부트스트랩(paired bootstrap) 의 발상은 이렇다
- 채점셋에서 문항을 복원추출로 24개 뽑아 “가상의 채점셋”을 만든다. 같은 문항이 두 번 뽑힐 수도 있다
- 가상 채점셋에서 X와 Y의 점수 차 δ를 다시 잰다. “쌍체”란 문항 하나를 뽑을 때 그 문항에 대한 X와 Y의 결과를 함께 가져온다는 뜻이다. 두 후보가 같은 문항을 두고 겨룬 결과를 비교해야 하기 때문이다
- 이것을 수천 번 반복해 δ가 얼마나 흔들리는지 본다. 가상 채점셋은 원래 채점셋에서 뽑았으므로 δ가 0이 아니라 원래 δ 근처에 모인다. 그래서 SLP3는 가상 δ가 원래 δ의 두 배 이상 나온 비율을 p값으로 센다(0 대신 δ만큼 옮긴 기준). 이 비율이 0.05나 0.01 같은 기준보다 작을 때만 “X가 낫다”고 말한다
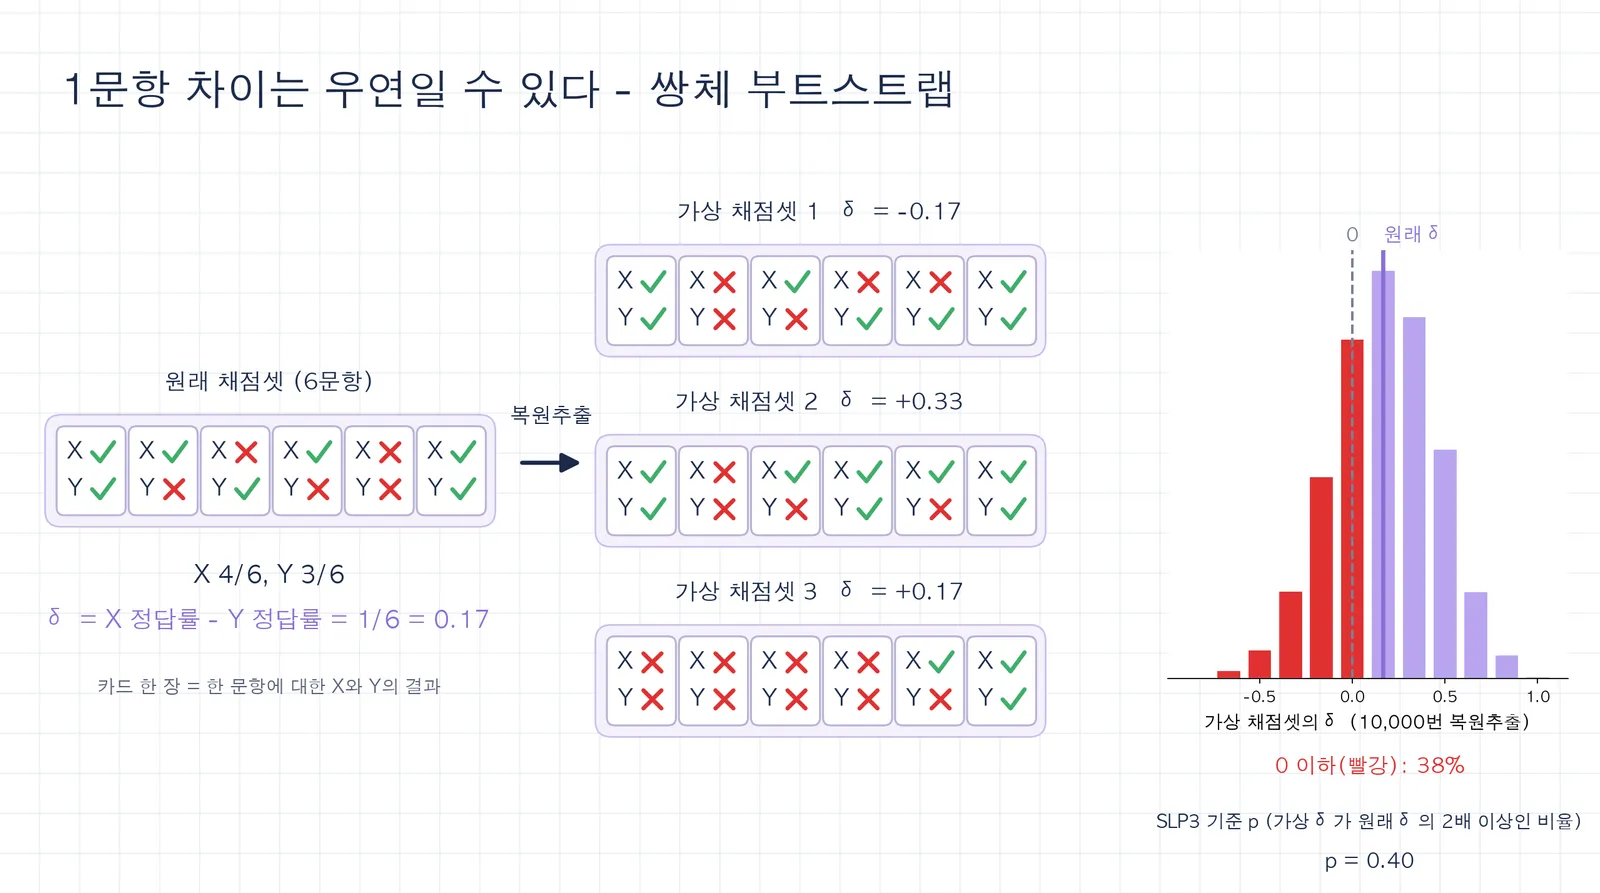
- 위 그림은 6문항에서 X가 딱 1문항 앞선 경우를 실제로 1만 번 복원추출한 결과다. 가상 채점셋의 38%에서 δ가 0 이하로 떨어지고, SLP3 방식 p값은 0.40이다. “X가 낫다”고 말할 근거가 되지 못한다
- 실무 결론은 단순하다. 24건에서 1-2문항 차이는 문항 한두 개만 바뀌어도 뒤집히는 크기다. “X가 낫다”를 말하려면 채점셋을 늘리거나 유의성 검정을 붙인다. 그렇지 못하면 Q4 “무엇을 놓쳤나”에 그 사실을 적는다
□ LLM judge - 루브릭을 읽고 채점하는 언어모형
- token F1의 한계(뜻을 못 봄)를 메우려고 쓰는 것이 LLM judge다. 큰 언어모형에게 루브릭(채점 기준표)을 주고 “이 출력을 채점하라”고 시킨다
- 사람이 보는 “근거가 있는가, 문장이 자연스러운가, 답이 질문과 이어지는가” 같은 것을 모델이 대신 봐 준다. 그래서 정확도보다 훨씬 유연하고 세밀한 채점이 가능하다
- judge를 쓰는 방식은 크게 셋이다 (Zheng 외, 2023, arXiv:2306.05685)
- 단일 채점: 답 하나를 주고 점수나 합격/불합격을 매기게 한다
- 쌍 비교: 답 두 개를 주고 더 나은 쪽을 고르게 한다
- 참조 기반 채점: 정답이나 모범 답안을 함께 주고 비교하게 한다. 아래 실험의 “정답지 포함 채점”이 이것이다
- 같은 논문은 judge의 알려진 치우침도 정리했다
- 위치 편향: 쌍 비교에서 답을 제시한 순서에 따라 판정이 달라진다
- 장황함 편향: 길고 자세해 보이는 답을 더 좋게 본다
- 자기 선호: 자기와 같은 계열 모델이 쓴 답을 더 좋게 본다
- 대응책도 구조적이다. 순서를 바꿔 두 번 채점하고, 참조 답을 주고, 사람 판정 표본과 대조한다
- 이제 4주차의 통찰이 다시 등장한다. judge도 언어모형이라 다음 토큰의 확률을 계산하는 기계다. “이 출력은 정답이다”라는 판정도, 그 자리에 “정답”이라는 토큰이 올 확률이 높아서 나온 것이다
- judge에게 판정을 시키는 프롬프트를 보자. 과제는 제주 관광 문의 분류다 (설명용 예시)
[역할] 당신은 분류 채점자입니다.아래 문의와 모델 출력을 보고, 출력이 문의를 정확히 분류했는지 판정하시오.답은 "정답" 또는 "오답"으로만 쓰시오.
[루브릭]- 문의의 핵심 요구와 라벨이 일치하면 정답- 근거 문장이 문의의 핵심 요구를 짚으면 정답- 라벨이 핵심 요구에서 빗나가면 오답
[문의] 천지연폭포 주차장 근처에 화장실이 있나요?[모델 출력] 분류: 주차 - 문의에 "주차장"이 있으므로 주차 문의다
[판정]- 마지막 “[판정]” 바로 다음에 judge가 이어 쓰는 토큰이 곧 판정이다. “정답”에 높은 확률이 가면 정답으로 본다
- 이 문의가 물은 것은 화장실(시설)이다. 그런데 출력은 “주차장”이라는 단어를 붙잡아 주차로 분류했다. 문제는 근거 문장이 문의의 단어를 그대로 인용하고 있어서 겉보기에 앞뒤가 맞는다는 것이다
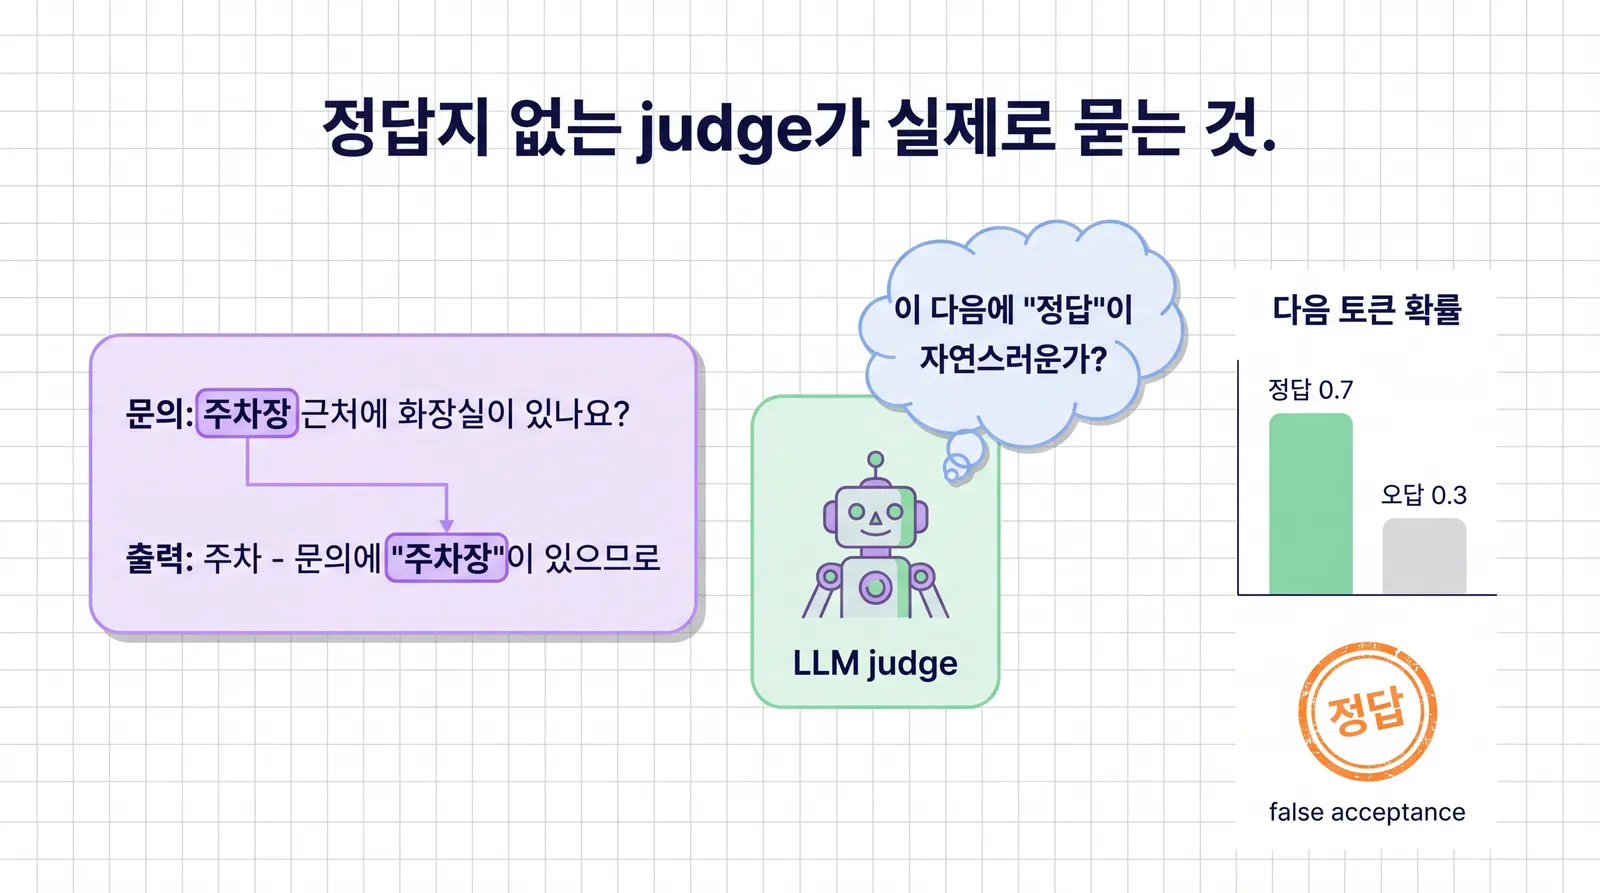
- 정답지가 없는 judge가 실제로 계산하는 것은 “이 출력이 맞는가”가 아니라 “이 문맥 다음에 ‘정답’이라는 말이 자연스러운가” 다. 문의와 근거가 같은 단어를 공유하고 문장에 모순이 없으면, “정답”은 그 자리에 아주 자연스러운 토큰이 된다
□ judge 실험 - 정답지 유무로 판정이 뒤집힌다
- judge가 “그럴듯함”을 보고 채점한다는 것을 가장 선명하게 보여 주는 실험이 있다. 판정 프롬프트에 정답지를 넣었다 빼는 것만으로 판정이 바뀌는지 보는 것이다 (출력과 판정 모두 설명용 예시)
토글을 바꿔 보세요. judge 프롬프트에 정답을 넣고 빼는 것만으로 판정이 달라집니다.
문의: 함덕해수욕장에 샤워실이 있나요?
분류: 시설 - 샤워실 유무를 묻는 시설 이용 문의다
정답지: 시설
문의: 우도 왕복 배 삯이 얼마인가요?
분류: 요금 - 뱃삯 금액을 묻는 문의다
정답지: 요금
문의: 천지연폭포 주차장 근처에 화장실이 있나요?
분류: 주차 - 문의에 "주차장"이 있으므로 주차 문의다
정답지: 시설
문의: 월정리해수욕장에 짐 보관함이 있나요?
분류: 주차 - 방문객이 차에 짐을 두는 문제와 관련된 문의다
정답지: 시설
- 정답지 없이 채점하면 4건 모두 “정답”이다. 실제로는 2건(j3, j4)이 오답이다. 정답지를 넣자 그 2건이 뒤집혔다
- j3: 앞에서 본 “주차장 근처 화장실” 문의다. 근거가 문의의 단어를 인용하므로 정답지가 없으면 반박할 거리가 프롬프트 안에 없다
- j4: “짐 보관함” 문의에 “차에 짐을 두는 문제”라는 문의에 없는 사정을 지어내 주차로 분류했다. 이야기가 자연스러워서 통과한다. 그럴듯한 근거는 인용으로도, 창작으로도 만들어진다
- 정답지(“정답지: 시설”)를 넣자 둘 다 뒤집힌다. judge가 강해진 것이 아니다. “정답은 이것이다”라는 외부 정보를 프롬프트가 붙여 준 것이다
- 이 실험의 교훈은 두 가지다
- 첫째, judge 판정은 정답이라는 근거가 프롬프트 안에 있는가에 크게 좌우된다. 정답을 넣으면 채점이 쉬워지지만, 운영의 새 입력에는 쓸 수 없다. 정답을 모르니까 judge를 쓰는 것이다
- 둘째, 정답 없이 judge만으로 “맞다”를 믿으면 형식만 그럴듯한 오답이 통과한다. 이것이 구조적인 false acceptance다
○ 실측 - 작은 모델을 judge로 쓰면
- 실습 노트북은 4주차와 같은 작은 모델(0.6B)을 judge로 쓴다. 프롬프트 A의 분류 결과 24건(맞은 20건, 틀린 4건)을 채점시킨 결과는 이렇다. 판정은 “정답”과 “오답” 두 토큰 중 확률이 높은 쪽이다
- 정답지 없이: 24건 모두 “정답”. 틀린 4건이 전부 통과했다. false acceptance 4/4. 다만 노트북의 judge는 근거 문장 없이 “라벨: 시설”만 본다. 그러니 이 4건은 그럴듯한 근거에 넘어간 것이 아니라, 무엇을 보든 “정답” 쪽으로 기우는 치우침 때문이다
- 정답지를 넣어도: 판정 단어는 여전히 24건 모두 “정답”
- 판정 단어만 보면 정답지가 아무 소용이 없어 보인다. 그런데 확률을 보면 다르다. “정답”과 “오답” 두 토큰의 확률만 놓고 합이 1이 되게 다시 나눈 값을 P(정답)이라 하자
| 조건 | 맞은 20건의 P(정답) | 틀린 4건의 P(정답) |
|---|---|---|
| 정답지 없음 | 0.70 ~ 0.92 | 0.62 ~ 0.75 |
| 정답지 포함 | 0.95 ~ 0.99 | 0.76 ~ 0.80 |
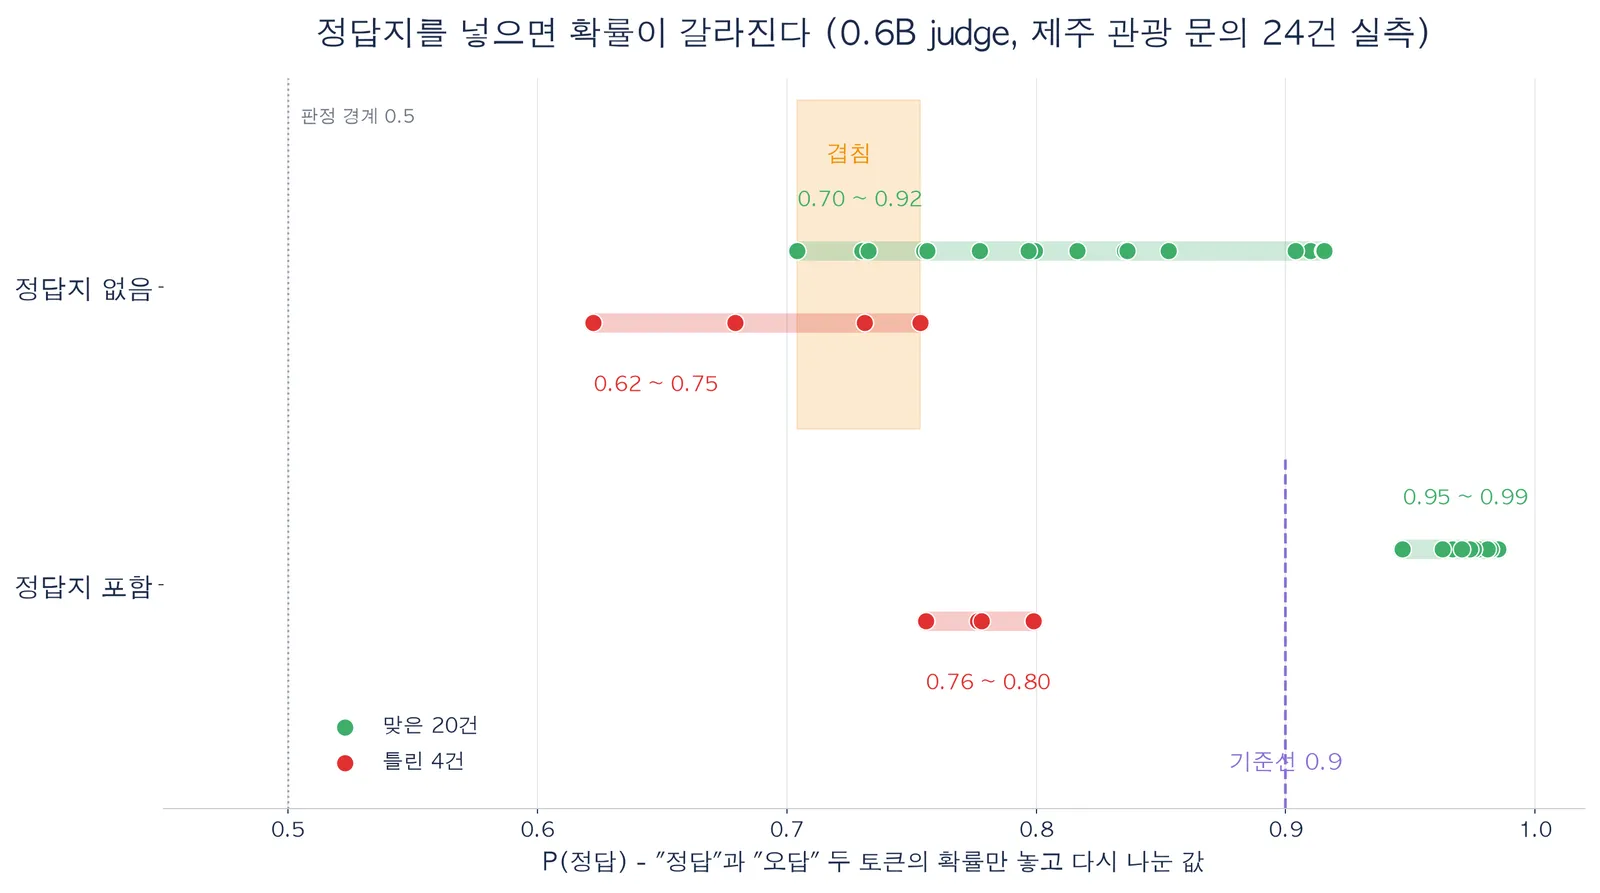
- 정답지가 없으면 두 범위가 겹친다. 0.70 ~ 0.75 구간에 맞은 것과 틀린 것이 섞여 있어서, 어떤 기준선을 그어도 깔끔히 가를 수 없다
- 정답지를 넣으면 두 범위가 떨어진다. 예컨대 “P(정답)이 0.9 이상일 때만 정답”으로 두면 24건이 모두 올바르게 갈린다. 단, 0.9는 이 24건을 보고 고른 값이다. 앞의 개발셋 이야기 그대로, 새 문항에서도 통한다는 보장은 없다
- 여기서 두 가지를 배운다
- 작은 judge에는 “정답”이라고 말하는 쪽으로 기우는 치우침이 있다. 판정 단어가 아니라 확률로 읽어야 정보가 보인다
- 그런데 확률로 읽으려면 0.9 같은 기준선이 필요하고, 그 기준선은 다시 사람이 정하는 선택이다. 뒤의 임계값 이야기로 이어진다
- 수치는 이 저장소에서 실행한 값이다. 환경에 따라 소수점 둘째 자리가 조금 다를 수 있다
○ false acceptance가 구조적인 이유 - 우연이 아니다
- judge가 오답을 통과시키는 것은 운 나쁜 사고가 아니다. judge도 다음 토큰 확률 기계이고, 다음 토큰 확률은 “그 자리에 오면 문맥 전체가 자연스러워지는 토큰” 에 높게 붙는다. 오답의 근거가 그럴듯하게 쓰여 있으면 “정답”이 가장 자연스러운 토큰이 된다
- 정답지가 없는 judge에게는 근거가 옳은지 확인하는 단계가 따로 없다. 루브릭에 “근거가 요구를 짚으면 정답”이라고 써 두어도, 그 문장을 읽고 “짚었다”고 느끼는 것 자체가 같은 확률 계산이다
- 이 구조는 4주차의 CoT 연쇄 오류와 같은 뿌리다. CoT에서 중간 단계가 틀려도 그 뒤가 조리 있게 이어지면 최종 답이 그럴듯해 보였다. judge도 똑같다. 중간 과정(근거 문장)이 형식적으로 그럴듯하면 최종 판정(정답)이 자연스러워진다
- 채점받는 모델과 judge가 같은 계열이면 사정이 더 나빠질 수 있다. 같은 데이터로 배운 모델은 같은 단어에 같은 방식으로 끌릴 수 있다. 앞의 자기 선호 편향과 같은 방향의 위험이다
- 그래서 4주차의 규칙이 그대로 이어진다. 중요한 판정은 judge 출력만 믿지 않고, 근거가 옳은지 따로 확인한다. judge는 검증이 아니라 “그럴듯한 초안”이다. 검증은 정답지, 코드 계산, 사람 판단과의 대조로 한다
- 판정을 여러 번 뽑아 다수결하면 나아질까. 실습 노트북 3-2의 계산을 보면 반대다. 틀린 4건에서 기대되는 오답 승인 건수는 판정을 1번 뽑을 때 2.79건, 5번 뽑아 다수결할 때 3.30건, 확률이 높은 쪽을 고를 때(다수결을 끝없이 한 것과 같다) 4건이다. P(정답)이 0.5보다 큰 문항에서 다수결은 “정답”을 더 굳힌다. 다수결은 우연한 흔들림을 줄일 뿐, 한쪽으로 기운 치우침은 고치지 못한다
- 이번 주 온라인 학습활동이 judge와 규칙 채점의 불일치를 기록하는 이유가 이것이다. 불일치가 난 자리에서 false acceptance가 드러난다
□ 감독 신호 신뢰성 - 참값으로 승격시키지 않는다
- 여기까지 “지표가 무엇을 놓치는가”를 봤다. 더 위험한 실수가 있다. 믿을 만해 보이는 신호를 참값(ground truth)으로 바꿔 버리는 실수다
- 학습·평가·운영 어디에서든 판단의 근거로 쓰이는 신호가 있다. 이것을 감독 신호라 부른다. 대표적인 셋이 이렇다
| 신호 | 왜 처음에는 그럴듯한가 | 무엇이 문제인가 |
|---|---|---|
| teacher 신호 | 더 크고 잘 학습된 모델의 출력이라서 | teacher도 틀린다. 틀린 출력을 정답으로 삼으면 그 틀림이 학습에 그대로 새겨진다 |
| LLM judge 판정 | 루브릭을 읽고 그럴듯하게 채점해서 | 앞서 본 false acceptance. 형식이 그럴듯하면 오답이 통과한다 |
| 도메인 임계값 | “0.5 이상이면 긴급”처럼 숫자로 딱 정해져서 | 그 값은 운영이 정한 선택이지 자연의 진리가 아니다 |
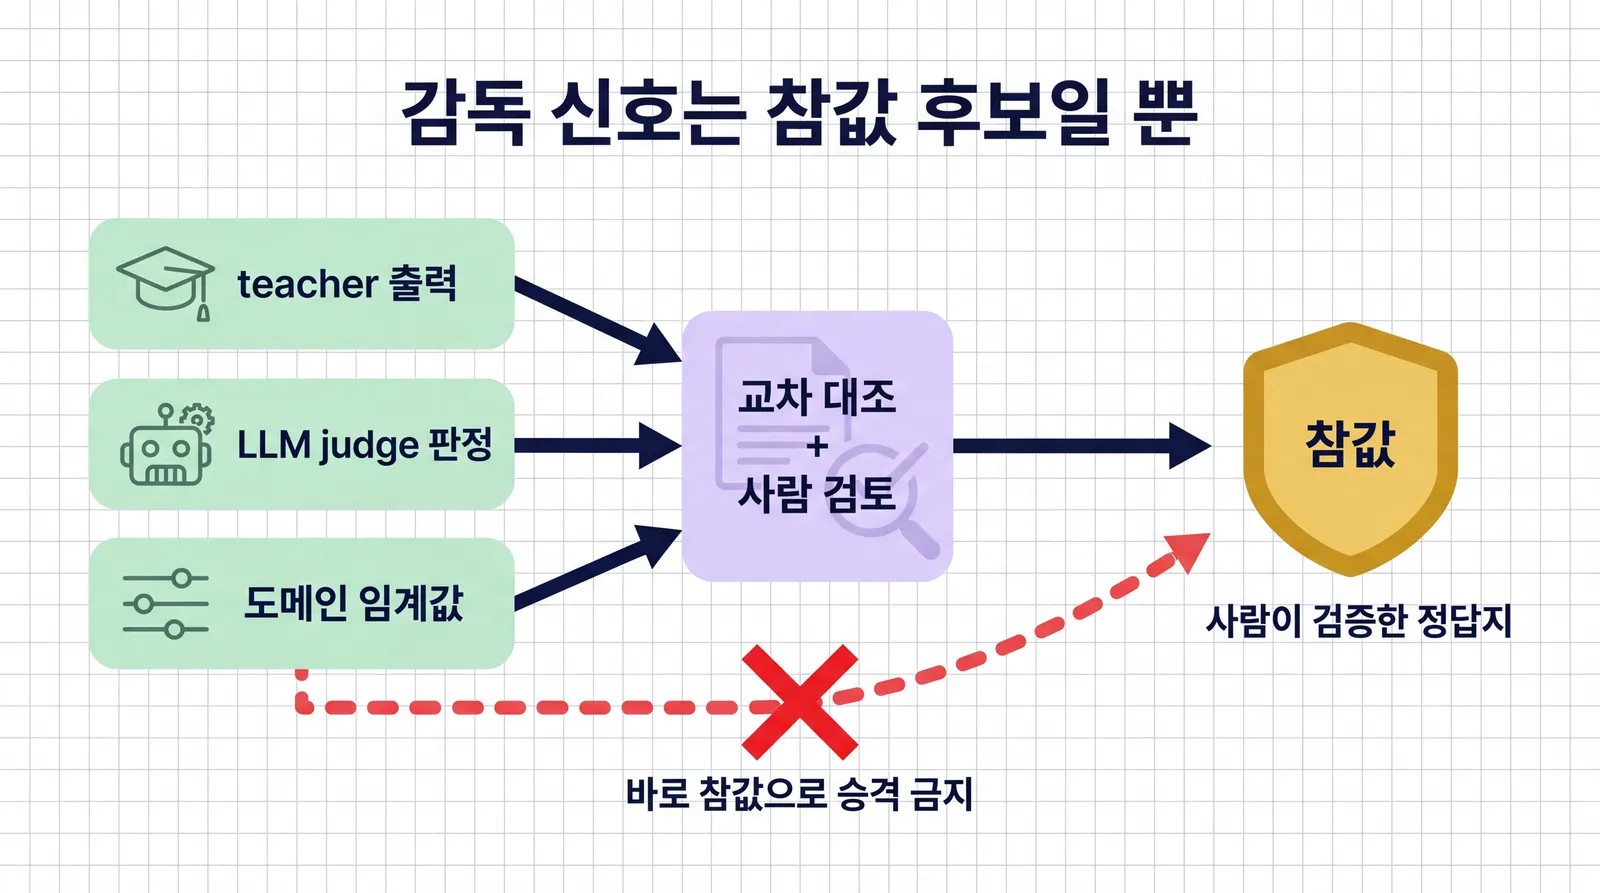
- 이 셋을 참값으로 승격시키지 않는다. 참값이라면 오답은 아무리 그럴듯해 보여도 여전히 오답이어야 한다. 셋 모두 그 성질을 보장하지 못한다
- 참값에 가까이 가는 방법은 두 가지다
- 첫째, 사람이 검증한 소규모 정답지를 기준으로 삼는다. 시험 정답지와 같다
- 둘째, 사람 검증이 아직 부족하면 여러 신호를 교차 대조한다. 신호끼리 불일치가 나면 “어느 쪽을 믿을까”를 사람 판단(또는 사람이 미리 정한 기준)으로 올린다
- 이번 주 대면에서 배울 Q4 근거 기준이 바로 여기서 온다. “어느 근거로 이 판정을 내렸는가”를 묻지 않으면 judge라는 그럴듯한 신호가 조용히 참값의 자리를 차지한다
○ 임계값은 선택이다 - 직접 움직여 보기
- 앞의 혼동행렬에서 두 실수를 봤다. 놓침(FN) 과 오경보(FP) 다. 점수에 임계값을 그어 분류하면, 임계값을 옮길 때마다 두 실수가 서로 맞바뀐다 (아래 문의와 점수는 설명용 예시)
슬라이더로 임계값을 움직여 보세요. 점수가 임계값 이상이면 긴급으로 분류됩니다. (문의와 점수는 설명용 예시)
영업시간 안의 단순 위치 문의
-탐방로 낙석을 봤다는 안전 신고
-같은 불편을 세 번째 알리는 항의 문의
-"급해요"를 여러 번 쓴 일반 예약 문의
-- 임계값을 올리면 긴급이라고 부르는 기준이 까다로워져 오경보는 줄고 놓침은 는다. 내리면 반대다
- 모든 임계값이 선택지인 것은 아니다. 이 예에서 0.7은 0.5보다 놓침만 2건 늘고 오경보는 줄지 않는다. 0.5보다 나은 점이 하나도 없으니 고를 이유가 없다. 선택이 필요한 것은 한쪽 실수를 줄이면 다른 쪽이 늘어나는 구간이다
- 이 예에는 “급해요”를 여러 번 써서 점수가 0.90까지 올라간 일반 문의가 있다. 그래서 어떤 임계값도 두 실수를 동시에 0으로 만들지 못한다. 점수 자체가 틀린 문항이 있으면 임계값으로는 고칠 수 없다
- 그렇다면 0.5와 0.95 중 어느 것이 “정답”인가. 0.5는 놓침 0건·오경보 1건, 0.95는 놓침 2건·오경보 0건이다. 둘 다 아니다. 어떤 실수를 감당할지 정한 선택일 뿐이다. 안전 신고를 놓치는 비용이 크면 낮추고, 대응 인력이 부족하면 올린다. 도메인이 다르면 잃는 것도 다르므로 값도 다르다
- 3주차 과제(효율적 미세조정)에서 낸 결과를 두 가지 방식으로 채점한다. 첫째, 정답지가 있는 규칙 채점(코드가 정답과 비교). 둘째, 정답지 없이 문서만 준 judge 채점(판정 프롬프트 + 루브릭만)
- 두 채점 결과를 문항별로 나란히 놓고 불일치가 나는 지점을 기록한다. judge는 맞다고 했는데 규칙 채점은 틀렸다고 한 사례와, 그 반대 사례를 각각 적는다
- 특히 정답 없이 문서만 준 judge가 오답을 승인한 사례 1건을 수집한다. 그 사례에서 judge가 무엇을 보고 “정답”이라고 판정했는지, 그 판정이 왜 틀렸는지 한 문장씩 쓴다
- 실습 노트북 1-5 ~ 1-7이 이 활동의 연습판이다. 같은 절차를 제주 관광 문의 채점셋으로 먼저 해 볼 수 있다
대면 (1시수)
Section titled “대면 (1시수)”Q4 근거 기준, pass@k 대조 - 결과가 맞아도 근거가 없으면 통하지 않는다
Section titled “Q4 근거 기준, pass@k 대조 - 결과가 맞아도 근거가 없으면 통하지 않는다”□ Q4 근거 기준 - “맞다”와 “근거가 있어서 맞다”는 다르다
- 대면의 주제는 “결과가 맞아도 근거를 대지 못하면 현장에서 통하지 않는다” 는 것이다. 채점, 발표, 운영 보고 어디서든 같다
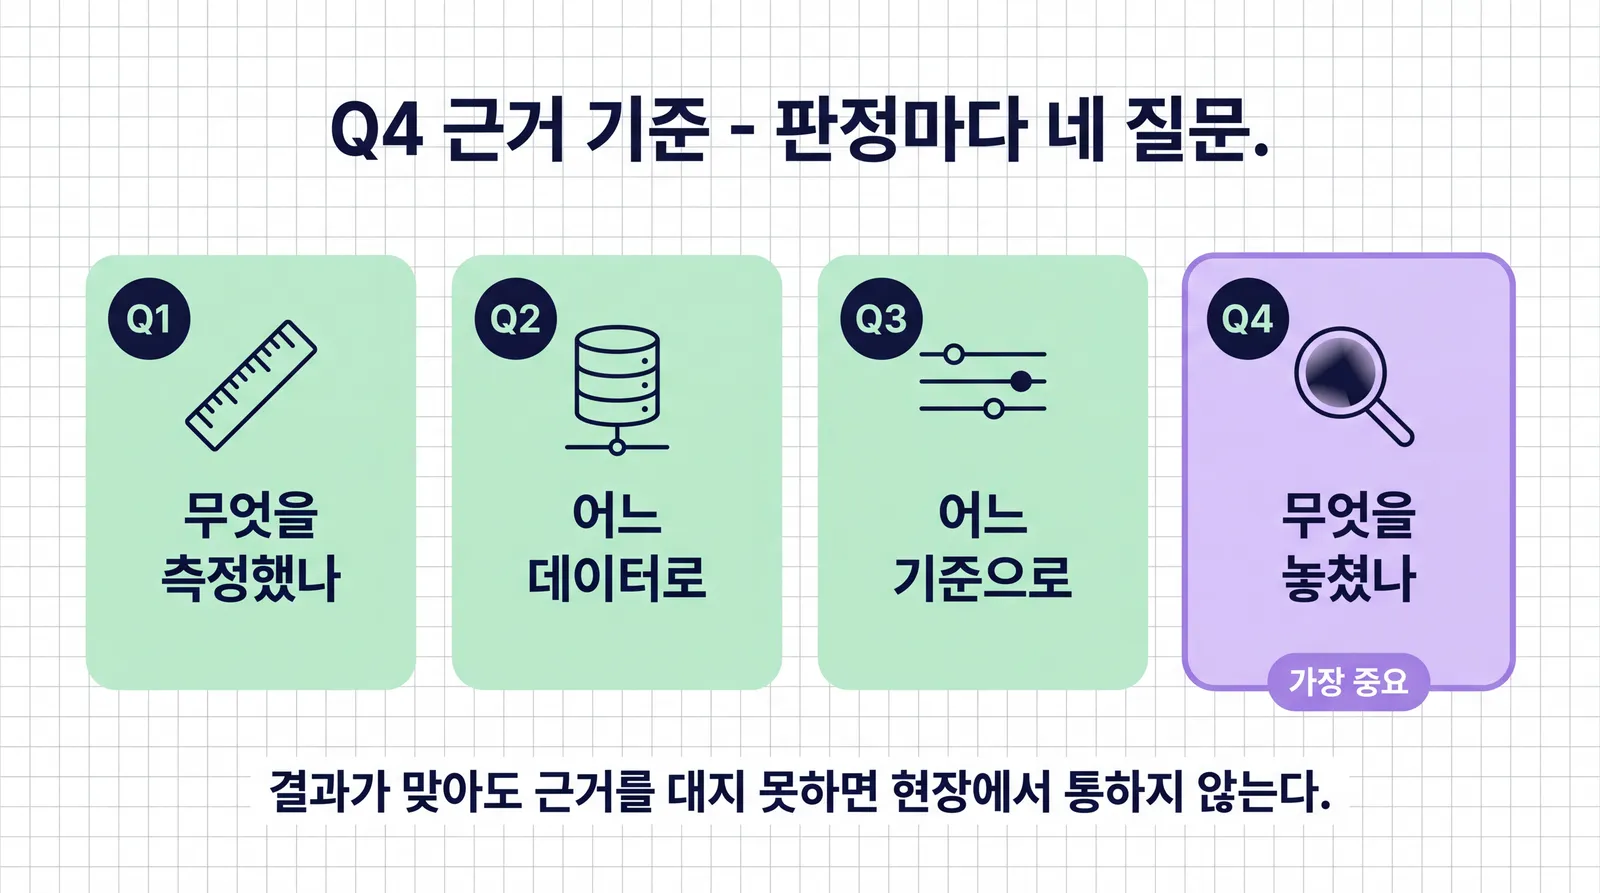
- Q4 근거 기준은 어떤 판정이든 네 가지 질문으로 근거를 확인하는 틀이다
| 질문 | 내용 | 안 되는 답 |
|---|---|---|
| Q1. 무엇을 측정했나 | 정확도인가, 부류별 재현율인가, judge 판정인가, 사람 판정인가 | “그냥 잘 돌아갔다” |
| Q2. 어느 데이터로 | 어떤 채점셋, 몇 건, 어떤 분포, 개발셋인가 시험셋인가 | “제주 관광 데이터” (대상을 못 박지 않음) |
| Q3. 어느 기준으로 | 임계값이 몇인가, 어떤 루브릭인가, 누가 정했나 | “충분히 높은 기준” |
| Q4. 무엇을 놓쳤나 | 이 지표가 보지 못하는 것은 무엇인가 | “놓친 게 없다” |
- Q1 ~ Q3이 “무엇을 기준으로 이 판정을 내렸는가”를 못 박고, Q4가 “그 기준이 무엇을 놓치고 있는가”까지 인정하게 한다. Q4가 가장 중요하다. 지표가 완벽하다는 주장은 대개 지표가 놓치는 것을 모르는 데서 온다
○ Q4 근거를 갖춘 판정의 예
- 좋은 예 (앞의 실측 혼동행렬을 근거로 쓴 기록):
판정: 프롬프트 B 채택Q1 측정: 정확도(라벨 일치)와 부류별 재현율 A: 정확도 0.83 / 재현율 주차 1.00, 시설 1.00, 요금 0.50 B: 정확도 0.83 / 재현율 주차 0.75, 시설 1.00, 요금 0.75Q2 데이터: 제주 관광 문의 채점셋 24건 (주차·시설·요금 각 8건). 4주차에 프롬프트를 고르며 이미 들여다본 개발셋Q3 기준: 정확도 0.80 이상을 먼저 통과시키고, 동점이면 가장 낮은 부류 재현율이 높은 쪽을 고름 (운영 담당이 사전에 정함)Q4 놓침: 두 후보의 차이는 24건 중 몇 건의 실수 방향뿐이라 우연일 수 있음. 개발셋 점수라 새 문의에서는 더 낮을 수 있음. 라벨 밖의 근거 품질은 보지 못함. -> 새 문의 50건을 시험셋으로 따로 모아 다시 잴 예정- 나쁜 예 (근거 없는 판정):
판정: A 프롬프트 채택. 정확도가 0.83으로 괜찮아 보였다.- 나쁜 예는 Q1 ~ Q4 어디에도 답하지 못한다. “0.83”이 어느 데이터의 어느 기준인지 모른다. 게다가 A와 B는 정확도가 같으므로 “0.83이라서 A”라는 말은 선택의 이유조차 되지 못한다
- 학습활동 [실무]의 벤치마크 항목표는 Q4를 의무 항목으로 넣은 표다. 지표마다 “놓치는 것” 칸을 비울 수 없다
□ pass@k - k번 시도 중 한 번이라도 맞히는가
- pass@k는 이름 그대로 “문항마다 k번 시도해 그중 한 번이라도 맞히는 비율”이다
- 이 지표가 나온 곳은 코드 생성이다 (Chen 외, 2021, arXiv:2107.03374). 코드는 단위 테스트로 맞았는지 자동으로 확인할 수 있다. 그리고 생성 모델은 샘플링할 때마다 다른 답을 낸다. 한 번 뽑은 결과는 운이 섞인다. 그래서 “여러 번 뽑았을 때 테스트를 통과하는 답이 하나라도 나오는가”를 잰다
- 직관적으로, 문항당 1번 풀어 맞힌 비율이 pass@1이고, k번까지 풀어 보고 한 번이라도 맞은 비율이 pass@k다. k를 늘리면 실수를 몇 번 더 봐주는 셈이라 값은 내려가지 않는다
- 쓸 수 있는 조건이 있다. 맞았는지를 자동으로 가려 줄 검증기(단위 테스트, 정답 대조)가 있어야 한다. judge로 맞았는지를 가리면 앞의 false acceptance가 pass@k에 그대로 섞인다
○ 주의 - 보기가 몇 개뿐이면 찍어도 오른다
- 라벨이 3개인 분류를 생각해 보자. 아무 생각 없이 무작위로 찍어도 한 번에 맞힐 확률은 1/3이다
pass@1 = 1/3 = 0.33pass@3 = 1 - (2/3)^3 = 0.70pass@5 = 1 - (2/3)^5 = 0.87- 찍기만으로 pass@5가 0.87이다. pass@k는 답의 가짓수가 아주 많은 과제(코드, 수식, 자유 서술)에서 의미가 있다. 실습 노트북이 라벨 3개 안에서 뽑지 않고 모델의 전체 어휘에서 다음 토큰을 뽑게 한 이유가 이것이다
○ pass@k 계산 - 무편 추정량
- 가장 단순한 방법은 문항마다 딱 k개를 뽑아 하나라도 맞으면 1로 세는 것이다. 틀린 방법은 아니지만 k마다 따로 뽑아야 하고, 값이 많이 흔들린다
- 흔한 실수는 이것이다. n개를 뽑아 맞은 비율 p = c/n을 구한 뒤
1 - (1 - p)^k에 넣는다. 원전은 이 방식이 편향되어 있고, 실제 값보다 일관되게 낮게 나온다고 보였다. 곡선1 - (1 - p)^k가 휘어 있어서, p를 추정할 때 생긴 오차가 위아래로 고르게 나도 결과는 아래쪽으로 치우친다 - 원전의 방법은 이렇다. 문항마다 n개를 한 번에 뽑고(원전은 n = 200, k는 100 이하), 맞은 개수 c를 센다. 그다음 “그 n개 안에서 k개를 골랐을 때 k개가 모두 오답일 확률” 을 정확히 계산해 1에서 뺀다
pass@k = 1 - C(n - c, k) / C(n, k)- C(a, b)는 a개 중 b개를 고르는 가짓수다
- C(n, k): n개 중 k개를 고르는 모든 방법
- C(n - c, k): 오답 n - c개 중에서만 k개를 고르는 방법
- 나누면 “고른 k개가 모두 오답일 확률”, 1에서 빼면 “적어도 하나는 정답일 확률”
- 이 값은 기댓값이 참 pass@k와 정확히 같다. 이런 성질을 무편(unbiased) 이라 한다. 채점셋 전체의 pass@k는 문항별 값의 평균이다
○ 손으로 풀어 보기 - n = 20, c = 2
- 한 문항을 20번 뽑았더니 2번 맞았다. 오답은 18개다
k = 1: 1 - C(18, 1) / C(20, 1) = 1 - 18/20 = 0.10k = 2: 모두 오답일 확률 = 18/20 x 17/19 = 306/380 = 0.805 pass@2 = 1 - 0.805 = 0.195k = 5: 1 - C(18, 5) / C(20, 5) = 1 - 8568/15504 = 0.447k = 19: 오답이 18개뿐이라 19개를 고르면 반드시 정답이 섞인다 = 1.00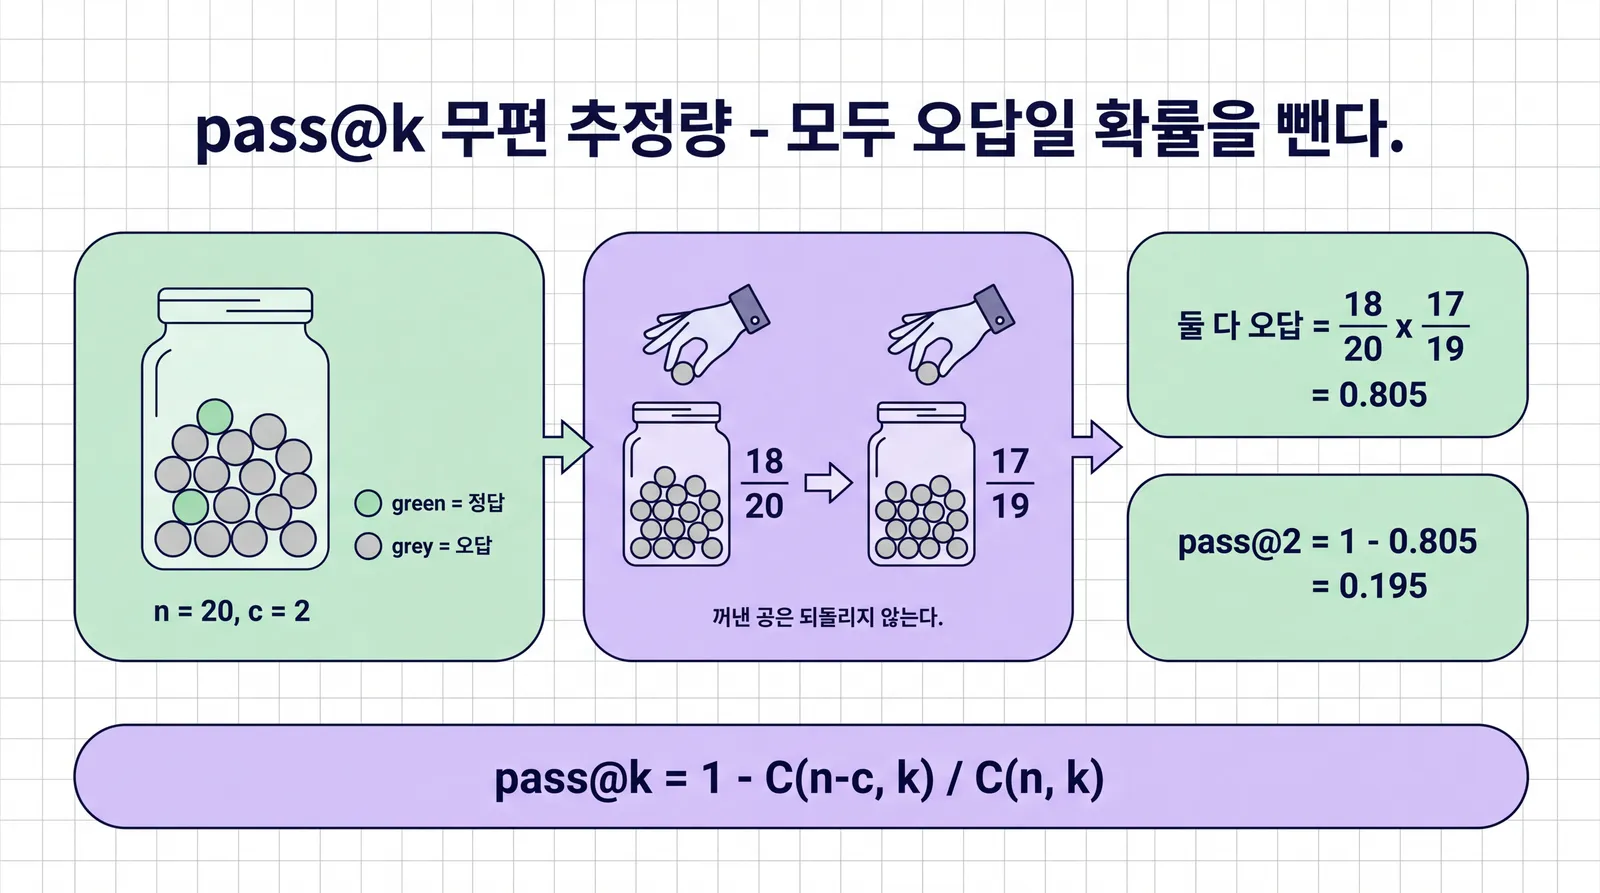
- k = 1이면 언제나 c/n이다. 20번 중 2번 맞았으니 한 번에 맞힐 확률은 0.10으로 읽는다
- k = 2의 계산이 식의 뜻을 잘 보여 준다. 첫 번째로 고른 것이 오답일 확률 18/20, 남은 19개 중 두 번째도 오답일 확률 17/19. 둘 다 오답일 확률을 곱하고 1에서 뺀다
- k = 5에서 흔한 실수 방식을 쓰면
1 - 0.9^5 = 0.410이다. 무편 추정량 0.447보다 낮다. 원전이 지적한 “낮게 나오는” 편향이 이것이다
□ pass@k 곡선을 읽는 법 - 앞머리와 천장
- pass@k를 k의 함수로 그리면 곡선이 나온다. 이 곡선에서 두 곳을 본다
- 앞머리 (k = 1 근처): 한 번에 맞히는 비율. 운영에서 사용자가 실제로 받는 품질에 가깝다. 보통 답을 한 번만 내니까
- 천장 (k가 클 때 곡선이 평평해지는 높이): 여러 번 시도하면 한 번이라도 맞힐 수 있는 문항의 비율. 이 모델이 닿을 수 있는 범위다
- 곡선은 k가 커질수록 오르거나 평평해질 뿐 내려가지 않는다. 그래서 “k를 늘리니 올랐다” 자체는 정보가 아니다
- 주의할 점. 곡선 끝이 아직 오르는 중이라면 그 끝값은 천장이 아니다. 시도 예산이 모자란 것이다
- 이 구분이 왜 중요한가. 학습(미세조정, 강화학습)으로 pass@1이 올랐다고 하자. 가능성은 두 가지다
- 새 능력: 학습 전에는 몇 번을 시도해도 못 풀던 문항을 풀게 됐다. -> 천장이 오른다
- 탐색 효율 개선: 학습 전에도 낮은 확률로 가끔 풀던 문항을 더 자주 맞히게 됐다. -> 앞머리는 오르지만 천장은 그대로
- pass@1만 보면 두 경우 모두 “올랐다”로 똑같아 보인다
시나리오를 고르고 슬라이더로 k(문항당 시도 횟수)를 바꿔 보세요. 점선(학습 후 pass@1)이 학습 전 곡선의 어디에 걸리는지가 핵심입니다.
학습 전 pass@1 = 0.10
학습 후 pass@1 = 0.21
- 판정하는 방법은 학습 전 pass@k 곡선 위에 학습 후 pass@1을 수평선으로 긋는 것이다
| 관찰 | 해석 |
|---|---|
| 학습 후 pass@1이 학습 전 곡선의 천장보다 높다 | 학습 전에는 몇 번을 시도해도 못 풀던 문항을 한 번에 푼다. 새 능력의 증거 |
| 학습 후 pass@1이 학습 전 천장 아래에 있고, 학습 전 곡선이 어떤 k에서 그 높이에 닿는다 | 학습 전에도 k번이면 얻던 정답률을 1번에 얻는다. 탐색 효율 개선일 가능성이 크다 |
| 큰 k에서 학습 전 곡선이 학습 후 곡선을 앞지른다 | 한 번에 맞히는 효율은 올랐지만 닿는 범위는 오히려 좁아졌다 |
| pass@1도 천장도 그대로다 | 개선이 없다 |
- 셋째 줄은 가상의 이야기가 아니다. 강화학습으로 훈련한 추론 모델을 원래 모델과 비교한 연구에서, 작은 k에서는 훈련한 모델이 앞서지만 큰 k에서는 원래 모델이 더 높은 양상이 보고됐다 (Yue 외, 2025, arXiv:2504.13837). 훈련이 원래 모델이 가진 범위 안의 답을 더 자주 뽑게 만들었을 뿐, 범위를 넓히지는 못했다는 해석이다
- 엄밀하게는 문항 단위로 본다. 학습 후 맞힌 문항들이 학습 전 n번 시도 안에 한 번이라도 맞힌 문항 집합 안에 들어 있는가. 비율만 비교하면 서로 다른 문항을 맞힌 경우를 놓친다
- 탐색 효율 개선도 가치 있는 개선이다. 한 번에 맞히게 된 것은 운영에서 큰 차이다. 문제는 어느 쪽인지 밝히지 않고 “모델이 추론을 배웠다”고 말하는 것이다. 이것이 Q4 “무엇을 놓쳤나”에 들어갈 문장이다
- 위 곡선은 설명용 단순 모형이다. 풀 수 있는 문항의 비율을 s, 그런 문항을 한 번에 맞힐 확률을 q라 두면
pass@k = s x (1 - (1 - q)^k)다. 학습 전은 s = 0.30, q = 1/3이라 pass@1 = 0.10, 천장 0.30이다
○ 실습의 대조 실험 - 가중치가 그대로인데 pass@1이 오르면
- 실습 노트북은 학습을 하지 않는다. 대신 4주차의 프롬프트 A(지시문만)와 B(예시 2개)를 비교한다. 가중치가 똑같으므로 새로 배운 것이 없다는 사실을 우리가 이미 아는 경우다. pass@k 대조가 이 사실을 제대로 보여 주는지 확인하는 대조 실험이다
- 문항당 n = 200번 뽑아(원전과 같은 값) 잰 결과다. 노트북의 TODO 예시 목록으로 실행하면 같은 값이 나온다(같은 CPU 환경 기준). 시드를 바꾸면 소수점 둘째 자리가 조금 흔들린다
| 프롬프트 | pass@1 | pass@4 | pass@16 | pass@64 | pass@200 |
|---|---|---|---|---|---|
| A (지시문만) | 0.11 | 0.34 | 0.67 | 0.87 | 0.92 |
| B (예시 2개) | 0.64 | 0.91 | 1.00 | 1.00 | 1.00 |
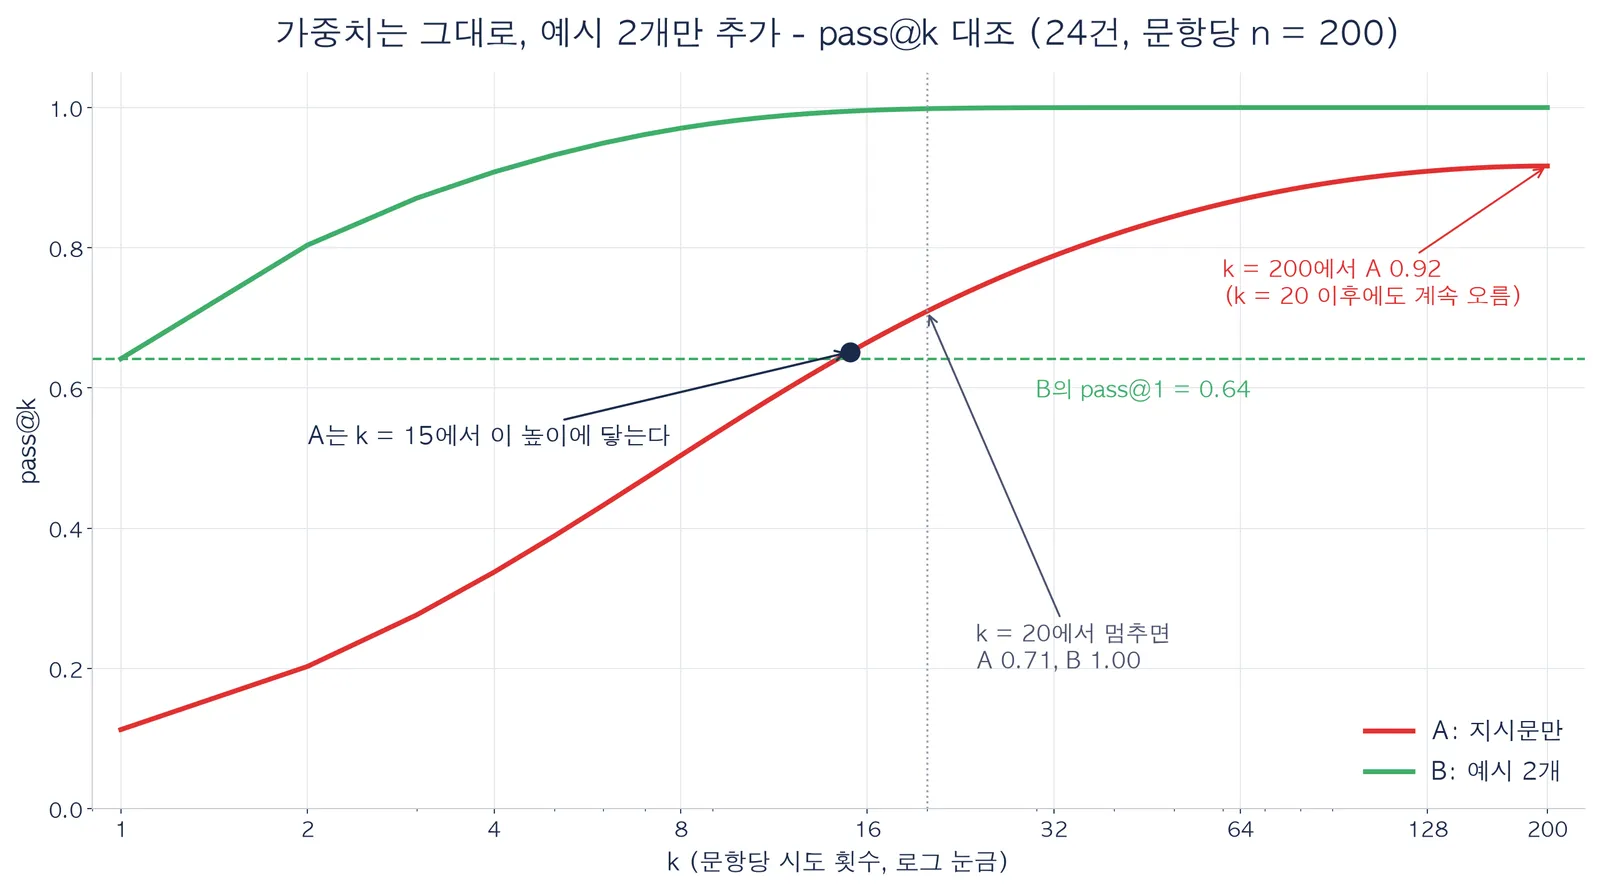
- B의 pass@1(0.64)은 A가 15번쯤 시도해야 닿는 높이다(k를 1씩 늘리면 15, 노트북 예시 목록에서는 16에서 처음 넘는다). 예시 두 개가 한 일은 “원래 15번쯤 뽑아야 나오던 정답을 첫 번에 나오게” 한 것이다. 판정 표의 둘째 줄(학습 후 pass@1이 학습 전 곡선의 어떤 k 높이에 닿는다)에 해당하고, 가중치가 그대로이니 새 능력일 수 없다는 설계상 예상과도 일치한다
- A의 정확도는 0.83인데 pass@1은 왜 0.11일까. 정확도는 라벨 3개의 확률만 비교해 가장 큰 것을 골랐다. pass@k는 전체 어휘에서 뽑는다. 지시문만 있는 A는 라벨 대신 문의 속 단어나 공백 같은 토큰을 자주 낸다. 라벨들 사이의 순위는 대체로 맞지만 답의 형식을 지키지 못하는 것이다. B의 예시 두 개는 “라벨: 주차” 같은 형식을 보여 줘 확률을 라벨 토큰으로 모은다. B의 이득 대부분은 이 형식 끌어내기다
- 문항 단위로 보면 2건이 A의 200번 커버리지 밖에 있다. 이 과제는 답이 토큰 하나라 A가 정답을 낼 확률을 직접 계산할 수 있는데, 0.0013과 0.0045다. 평균 약 770번, 220번을 뽑아야 한 번 나오는 수준이라 n을 수천으로 늘리면 커버리지 안으로 들어온다고 본다. 천장과 커버리지는 시도 예산 n에 상대적이다. 긴 답을 생성하는 과제에서는 이렇게 확률을 직접 계산할 수 없으므로, 예산을 명시하고 판정해야 한다
- 함정도 하나 있다. k = 20에서 멈췄다면 A 0.71, B 1.00을 보고 “B의 천장이 더 높다, 새 능력이다” 라고 읽었을 것이다. 그러나 A 곡선은 그 뒤로도 계속 올라 k = 200에서 0.92가 된다. 평평해지기 전의 끝값은 천장이 아니다
□ 학습활동 [구현]과 pass@k의 관계
- 온라인 학습활동은 “규칙 채점 vs judge 채점”의 불일치였다. 대면 구현이 그것을 이어받는다
- pass@k를 측정하는 코드를 받아 실행하고, k 값을 바꿔 가며 곡선을 그린다. 학습 전 pass@k 곡선 위에 학습 후 pass@1을 놓고 대조한다
- 목적은 이 구분이다. 성능 향상이 새 추론 능력인가, 기존 성공 경로의 탐색 효율 개선인가. 위의 판정 표를 순서대로 적용한다
- 학습 전 곡선이 평평해졌는가 (천장을 읽을 수 있는가)
- 학습 후 pass@1이 그 천장보다 높은가, 낮은가
- 낮다면 학습 전 곡선이 몇 번째 k에서 그 높이에 닿는가
- 문항 단위로 보면 학습 후 맞힌 문항이 학습 전 커버리지 안에 있는가
□ 벤치마크 항목표 - 무엇을 측정할지와 무엇을 놓치는지
- 학습활동 [실무]는 제공된 항목표에서 골라 소규모 도메인 벤치마크를 구성하는 것이다. 항목표는 “무엇을 측정할지”와 “그 지표가 무엇을 놓치는지”를 한 줄에 함께 적게 한다
- 데이터 소스는 이 과목에서 쓰는 공개 데이터다 (자세한 목록은 데이터 출처)
| 후보 과제 | 데이터 소스 | 지표 | 지표가 놓치는 것 |
|---|---|---|---|
| 제주 관광 문의 분류 | 제주데이터허브·관광 빅데이터 플랫폼의 문의/방명록 데이터 | 정확도, 부류별 재현율 | 왜 틀렸는지, 근거 품질, 오분류의 고객 비용 |
| 방언-표준어 대응 | AI Hub 「한국어 방언 발화(제주도)」 | exact match, token F1 | 방언의 맥락, 화자 의도, 뜻은 같고 표현만 다른 번역 |
| 관광 명소 리뷰 분석 | 관광 빅데이터 플랫폼의 후기 데이터 | 부류별 F1 | 톤과 감정 강도, 부정의 대상 |
| 안내 응답 생성 | 공공데이터포털의 관광 안내 FAQ | LLM judge 판정 | judge false acceptance, 사실성 검증 |
- 항목을 고를 때의 기준은 셋이다
[이론] LLM judge의 false acceptance가 우연이 아니라 구조적인 이유를 다음 토큰 확률 관점에서 정리. judge도 다음 토큰 확률 기계라서, 중간 과정(근거 문장)이 형식적으로 그럴듯하면 “정답”이 그 자리에 자연스러운 토큰이 된다는 것. 4주차의 CoT 연쇄 오류와 같은 뿌리임을 예로 들어 쓴다
[구현] pass@k를 측정하는 코드를 받아 실행하고 k 값을 바꿔 가며 곡선을 그린다. 학습 전 pass@k 곡선과 학습 후 pass@1을 대조해, 성능 향상이 새 추론 능력인지 기존 성공 경로의 탐색 효율 개선인지 구분하고 판정 문장을 쓴다. 학습 후 pass@1이 학습 전 곡선의 천장보다 높은지, 학습 전 곡선이 몇 번째 k에서 그 높이에 닿는지를 근거로 단다
[실무] 제공된 벤치마크 항목표에서 골라 소규모 도메인 벤치마크를 구성한다. 제주데이터허브·관광 빅데이터 플랫폼에서 확보 가능한 데이터를 대상으로 무엇을 측정할지와 그 지표가 놓치는 것을 함께 기술한다. 데이터셋 실물 확보 여부는 개강 전 확인 항목으로 남긴다
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. 정확도가 0.9 이상이면 문제를 다 이해한 것 아닌가?
정확도는 라벨 일치만 센다. 무엇을 틀렸는지, 그 틀림이 고객에게 얼마나 치명적인지는 보지 못한다. 찾으려는 부류가 드물면 아무것도 못 잡는 모델도 정확도가 높게 나온다(긴급 20건 / 1,000건이면 전부 “일반”이라 답해도 0.98). 부류별 재현율을 함께 보고, Q4로 “이 0.9가 무엇을 놓치고 있는가”를 붙인다.
Q2. 정확도가 같으면 두 모델은 사실상 같은 것 아닌가?
아니다. 4주차 프롬프트 A와 B는 둘 다 24건 중 20건을 맞혔다(0.83). 그러나 A는 요금 문의 4건을 시설로 보냈고, B는 주차 2건과 요금 2건을 틀렸다. 정확도는 같아도 실수의 방향과 비용이 다르다. 혼동행렬과 부류별 재현율을 봐야 차이가 보인다.
Q3. LLM judge가 사람보다 더 공정하지 않나?
일관성(같은 입력에 같은 답)은 사람보다 나을 수 있다. 그러나 judge도 언어모형이라 다음 토큰 확률로 판정한다. 근거 문장이 그럴듯하면 오답도 통과시키는 false acceptance가 구조적으로 붙어 있고, 제시 순서·답의 길이·같은 계열 모델에 끌리는 치우침도 보고되어 있다. “일관적이다”는 “옳다”와 다르다.
Q4. judge에게 정답지를 넣어 채점하면 되지 않나?
정답지가 있으면 채점이 쉬워지고 틀린 것을 잘 잡는다. 이미 정답이 있는 개발셋·시험셋을 채점할 때는 좋은 방법이다. 하지만 운영의 새 입력은 정답을 모르기 때문에 judge를 쓰는 것이다. 정답지를 넣은 판정은 “정답을 아는 상태의 채점”이고, 운영의 judge는 정답 없이 판정한다. 그래서 judge의 신뢰도는 정답 없는 조건에서 따로 잰다.
Q5. teacher 모델의 출력은 참값으로 써도 되지 않나?
teacher도 틀린다. 틀린 teacher 출력을 참값으로 삼으면 그 틀림이 학습·평가에 새겨진다. teacher 신호는 그럴듯한 신호일 뿐 사람이 검증한 정답지가 아니다. 감독 신호는 “참값”이 아니라 “참값 후보”로 보고, 검증된 정답지나 교차 대조로 확인한다.
Q6. pass@k에서 k를 늘리면 점수가 오르는 것은 좋은 것 아닌가?
k를 늘리면 누구의 pass@k든 오른다. 보기가 몇 개뿐인 과제라면 찍기만으로도 오른다. 그래서 “오름” 자체가 아니라 두 가지를 본다. 곡선이 평평해진 높이(천장)가 학습 뒤에 올랐는가, 그리고 학습 후 pass@1이 학습 전 곡선의 어디에 걸리는가. 천장이 그대로인데 pass@1만 올랐다면 탐색 효율 개선이다.
Q7. 임계값을 0.5로 두는 것이 “중립적”이라서 안전하지 않나?
0.5도 선택이다. 놓침(FN)과 오경보(FP)의 비용은 도메인마다 다르므로 어느 임계값이 안전한지는 그 도메인이 정한다. 안전 신고를 놓치는 것이 더 나쁘면 낮추고, 헛출동이 더 나쁘면 올린다. 0.5는 계산상 가운데일 뿐 판단상 중립이 아니다.
Q8. 채점셋 점수가 좋으면 운영에서도 좋지 않을까?
그 채점셋을 들여다보며 프롬프트를 고쳤다면 점수는 낙관적이다. 프롬프트가 그 문항들에 맞춰졌기 때문이다. 고치는 데 쓴 데이터(개발셋)와 마지막에 한 번만 재는 데이터(시험셋)를 나눠야 운영 성능에 가까운 숫자를 얻는다.
Q9. 지표가 불완전하다면 차라리 안 쓰는 것이 나은가?
아니다. 지표는 “완벽한 참값을 재는 자”가 아니라 “빠르고 대량으로, 같은 기준으로 비교하는 자”다. 문제는 지표만 절대시하는 것이다. 지표로 후보를 비교하고, 지표가 놓치는 것을 Q4로 적고 사람 검토로 보완하는 이중 구조가 실무의 표준이다. 지표를 버리면 대량 비교가 불가능해진다.
스스로 점검
Section titled “스스로 점검”- 문의 500건 중 긴급이 10건이다. 모든 문의를 “일반”으로 답하는 모델의 정확도와 긴급 재현율은?
- 정밀도 0.5, 재현율 1.0이다. F1은?
- 정확도 0.83이 알려 주지 못하는 것 두 가지를 써 보자.
- judge의 false acceptance가 우연이 아니라 구조적인 이유를 한 문장으로.
- 20번 시도 중 정답이 2번 나왔다. 무편 추정량 1 - C(n-c,k)/C(n,k)로 pass@1과 pass@2를 계산하라.
- 학습 후 pass@1이 0.25다. 학습 전 pass@k 곡선은 k = 4에서 0.25에 닿고 천장은 0.40이다. 어떻게 판정하나?
- 감독 신호(teacher, LLM judge, 도메인 임계값)를 참값으로 승격시키면 왜 위험한가?
- 벤치마크 항목표에서 “지표가 놓치는 것” 칸을 비워 두면 왜 안 되는가?
정답 보기
- 정확도 490/500 = 0.98. 긴급 재현율 0/10 = 0. 정확도가 높아도 찾으려는 것을 하나도 못 잡는다
- F1 = 2 x 0.5 x 1.0 / (0.5 + 1.0) = 1.0 / 1.5 = 0.67
- 첫째, 왜 틀렸는지와 그 실수가 얼마나 치명적인지. 둘째, 어느 부류로 치우쳐 틀리는지(4주차 프롬프트 A는 요금 재현율이 0.50이었다). 이 밖에 근거 품질, “거의 맞음”도 답이 된다
- judge도 다음 토큰 확률 기계라서, 근거 문장이 형식적으로 그럴듯하면 “정답”이 그 자리에 자연스러운 토큰이 된다. 정답지가 없으면 근거가 옳은지 확인하는 단계가 구조에 없다
- pass@1 = 1 - 18/20 = 0.10. pass@2 = 1 - (18/20 x 17/19) = 1 - 0.805 = 0.195
- 학습 후 pass@1(0.25)이 학습 전 천장(0.40) 아래이고, 학습 전에도 4번 시도하면 얻던 정답률이다. 탐색 효율 개선일 가능성이 크다. 새 능력이라 말하려면 학습 후 곡선의 천장이 0.40보다 높은지, 학습 후 맞힌 문항이 학습 전 커버리지 밖에 있는지를 확인해야 한다
- 셋 모두 “그럴듯함”이나 “정해진 숫자”에 근거해서 오답을 정답으로 포장할 수 있다. teacher도 틀리고, judge에는 false acceptance가 있고, 임계값은 선택이다. 참값에 가까운 것은 사람이 검증한 정답지와 교차 대조뿐이다
- “놓치는 것”을 못 쓰면 그 지표가 무엇을 보지 못하는지 모른 채 지표를 절대시하게 된다. Q4 근거 기준의 핵심이 무너진다. 지표를 고를 때는 그 한계를 같이 선언한다
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 한 줄 뜻 |
|---|---|
| 지표 | 모델 출력이 좋은지 숫자로 재는 자(ruler) |
| 혼동행렬 | 정답과 예측을 가로세로로 놓고 건수를 센 표. 분류 지표의 출발점 |
| TP / FP / FN / TN | 진짜 양성 / 거짓 양성(오경보) / 거짓 음성(놓침) / 진짜 음성 |
| 정확도 | 라벨이 정답과 일치한 비율. 드문 부류가 중요하면 거의 아무것도 말하지 않는다 |
| 정밀도 | “그렇다”고 한 것 중 진짜의 비율. 낮으면 오경보가 많다 |
| 재현율 | 진짜 중 잡아낸 비율. 낮으면 놓침이 많다 |
| F1 | 정밀도와 재현율의 조화평균. 작은 쪽에 끌린다 |
| macro-F1 | 부류별 F1의 단순 평균. 드문 부류도 같은 무게 |
| exact match | 예측이 정답과 글자 그대로 같은 비율 |
| token F1 | 예측과 정답의 겹치는 단어로 구한 F1. 부분 점수를 주지만 뜻은 보지 않는다 |
| 개발셋 / 시험셋 | 들여다보며 고치는 데이터 / 마지막에 한 번만 재는 데이터 |
| 교차검증 | 데이터를 k묶음으로 나눠 돌아가며 시험용으로 쓰고 평균하는 방법 |
| 통계적 유의성 | 점수 차이가 우연으로 설명되기 어려운가. 쌍체 부트스트랩으로 확인한다 |
| LLM judge | 루브릭을 준 언어모형이 출력을 채점하는 방식 |
| false acceptance | 그럴듯한 근거에 넘어가 오답을 정답으로 통과시키는 것(오답 승인) |
| 감독 신호 | teacher 출력·judge 판정·도메인 임계값처럼 판단 근거로 쓰이는 신호. 참값이 아니다 |
| 참값 (ground truth) | 사람이 검증한 정답. 채점의 기준이 되는 것 |
| pass@k | 문항마다 k번 시도해 한 번이라도 맞히는 비율 |
| 무편 추정량 | 기댓값이 참값과 같은 추정 방법. pass@k = 1 - C(n-c,k)/C(n,k) |
| 앞머리 | pass@k 곡선의 k = 1 근처. 한 번에 맞히는 효율 |
| 천장 | k가 커져 곡선이 평평해지는 높이. 모델이 닿을 수 있는 범위 |
| 탐색 효율 개선 | 원래 가끔 맞히던 문항을 더 자주 맞히게 된 것. 앞머리만 오른다 |
| 임계값 | 점수를 분류로 나누는 기준선. 놓침과 오경보 중 무엇을 감수할지 정하는 선택 |
| Q4 근거 기준 | 무엇을 측정했나, 어느 데이터로, 어느 기준으로, 무엇을 놓쳤나의 네 질문 |
| 벤치마크 | 과제·지표·데이터를 묶어 성능을 재는 체계. 항목표는 지표의 한계를 함께 적는다 |
실습 노트북
Section titled “실습 노트북”
4주차의 제주 관광 문의 채점셋 24건과 같은 모델을 그대로 쓴다. 먼저 규칙 채점으로 혼동행렬과 부류별 F1을 구하고, 정답지 없이 문서만 준 judge 채점과 대조해 불일치와 오답 승인 사례를 모은다. 그다음 프롬프트 A(지시문만)와 B(예시 2개)의 pass@k 곡선을 그려, B의 pass@1 상승이 새 능력인지 탐색 효율 개선인지 판정한다. 마지막으로 judge 판정을 다수결로 정하면 오답 승인이 줄어드는지 계산해 본다. 바꿀 곳은 k 목록 한 곳이다.