
8주차: 중간고사 및 PEFT 심화
중간고사 및 PEFT 심화
□ 이 주차가 놓이는 자리
- 1~7주차를 마무리하는 주다. 새 주제는 없다. 이미 배운 것을 다시 꺼내 손으로 계산하고, 빠진 마디를 찾는다
- 온라인은 두 가지다
- PEFT 심화: 3주차의 LoRA, QLoRA, DoRA를 4~7주차 실습 모델 Qwen3-0.6B-Base에 다시 적용해 숫자로 비교한다. 3주차 모델(KoELECTRA, 1.1억 개)과 무엇이 달라지는지 본다
- 기출 유형 자가 점검: 1~7주차 핵심 계산을 먼저 예측하고 노트북으로 확인한다
- 대면 시간은 중간고사다
□ 이번 주가 답하는 질문
- 같은 LoRA라도 모델이 바뀌면 학습 파라미터와 메모리가 어떻게 달라지는가
- LoRA를 어디에 얼마나 붙일지는 무엇으로 정하는가 (붙일 곳, 랭크, 예산)
- QLoRA의 메모리 절약은 어느 모델에서 크고 어느 모델에서 작은가
- 1~7주차 개념 위계에서 내가 설명하지 못하는 마디는 어디인가
□ 읽기 안내
- 이번 주 신규 읽기는 없다
- 3주차 읽기를 다시 본다: LoRA(arXiv:2106.09685), QLoRA(arXiv:2305.14314), DoRA(arXiv:2402.09353), VB-LoRA(arXiv:2405.15179), WaveFT(arXiv:2505.12532)
- 1~7주차 강의 노트의 “스스로 점검”과 “자주 하는 오해 Q&A”가 시험 준비의 기본 자료다
| 다시 볼 자료 | 이 노트에서 이어지는 곳 | 확인할 질문 |
|---|---|---|
| 3주차 LoRA·QLoRA 읽기 | 온라인의 모듈별 파라미터와 메모리 어림 | 랭크·붙일 곳·얼린 가중치가 예산에 주는 영향은? |
| 3주차 DoRA·VB-LoRA·WaveFT 읽기 | PEFT 기법 비교표와 DoRA 추가 파라미터 | 각 기법이 학습하는 대상은 무엇인가? |
| 1~7주차 스스로 점검·Q&A | 온라인 자가 점검과 노트북의 일곱 계산 | 손계산과 실행이 다르면 어느 정의를 다시 볼 것인가? |
| 7주차 개념 위계·비교표 | 대면 중간 점검과 팀 프로젝트 예산 | 앞 마디의 결과를 다음 마디에서 어떻게 이용하는가? |
□ 실측에 대하여
- 본문의 파라미터 수는 실습 노트북이 Qwen3-0.6B-Base의 설정으로 모델을 만들고 LoRA, DoRA를 실제로 붙여 센 값이다(모듈별 표, r = 4 비교, r = 32 비교는 같은 공식으로 계산한 값이다). 파라미터 개수는 가중치 값과 상관없으므로 무작위 가중치로 센다
- 메모리는 3주차의 16바이트 규칙으로 계산한 어림이다. 활성값(중간 계산값)과 양자화 보조 숫자는 빠져 있다
온라인 (2시수)
Section titled “온라인 (2시수)”강의: PEFT 기법 비교 분석 - 3주차를 4~7주차 모델에 다시 적용
Section titled “강의: PEFT 기법 비교 분석 - 3주차를 4~7주차 모델에 다시 적용”□ 같은 잣대로 비교한다
- 3주차 대면에서 본 비교 기준을 다시 꺼낸다. 파라미터 수만 보지 않는다
| 잣대 | 묻는 것 |
|---|---|
| 학습 파라미터 | 무엇을, 몇 개 학습하는가 |
| 학습 메모리 | 얼린 가중치와 학습 상태가 몇 GiB인가 |
| 추론 추가 비용 | 학습 뒤 원래 모델에 합쳐서 추가 비용 없이 쓸 수 있는가 |
| 구현 | 표준 라이브러리에서 바로 쓸 수 있는가 |
| 검증 범위 | 논문이 어떤 과제와 모델에서 검증했는가 |
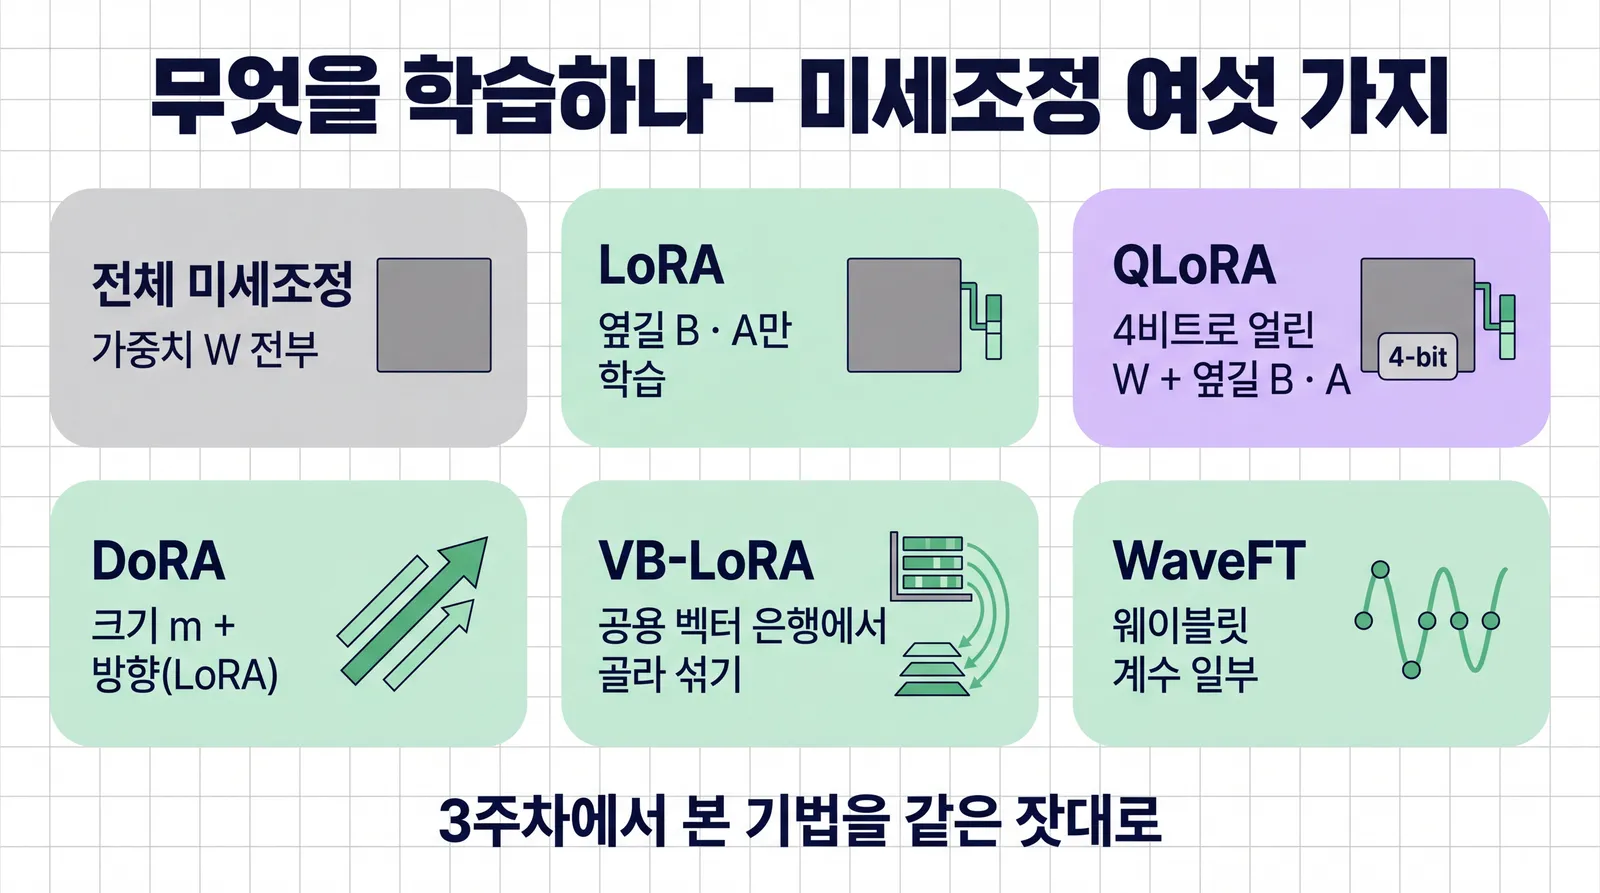
- 3주차의 결론을 한 줄씩 되짚는다
- LoRA와 DoRA는 학습 뒤 원래 가중치에 합칠 수 있어 추론 비용이 늘지 않는다
- QLoRA는 학습 파라미터는 LoRA와 같고, 얼린 가중치를 올리는 크기를 줄인다
- WaveFT는 시각 모델 중심으로 제안되어 텍스트 과제 검증이 제한적이다. “최신”과 “검증됨”은 다르다
□ Qwen3-0.6B 한 층 해부 - 어디에 붙일 수 있나
- 3주차 모델은 query, value가 모두 768 x 768이었다. Qwen3-0.6B-Base는 모양이 제각각이다. 쿼리 헤드 16개 x 128 = 2048, KV 헤드 8개 x 128 = 1024라서 q_proj와 v_proj의 출력이 다르다(7주차의 GQA)
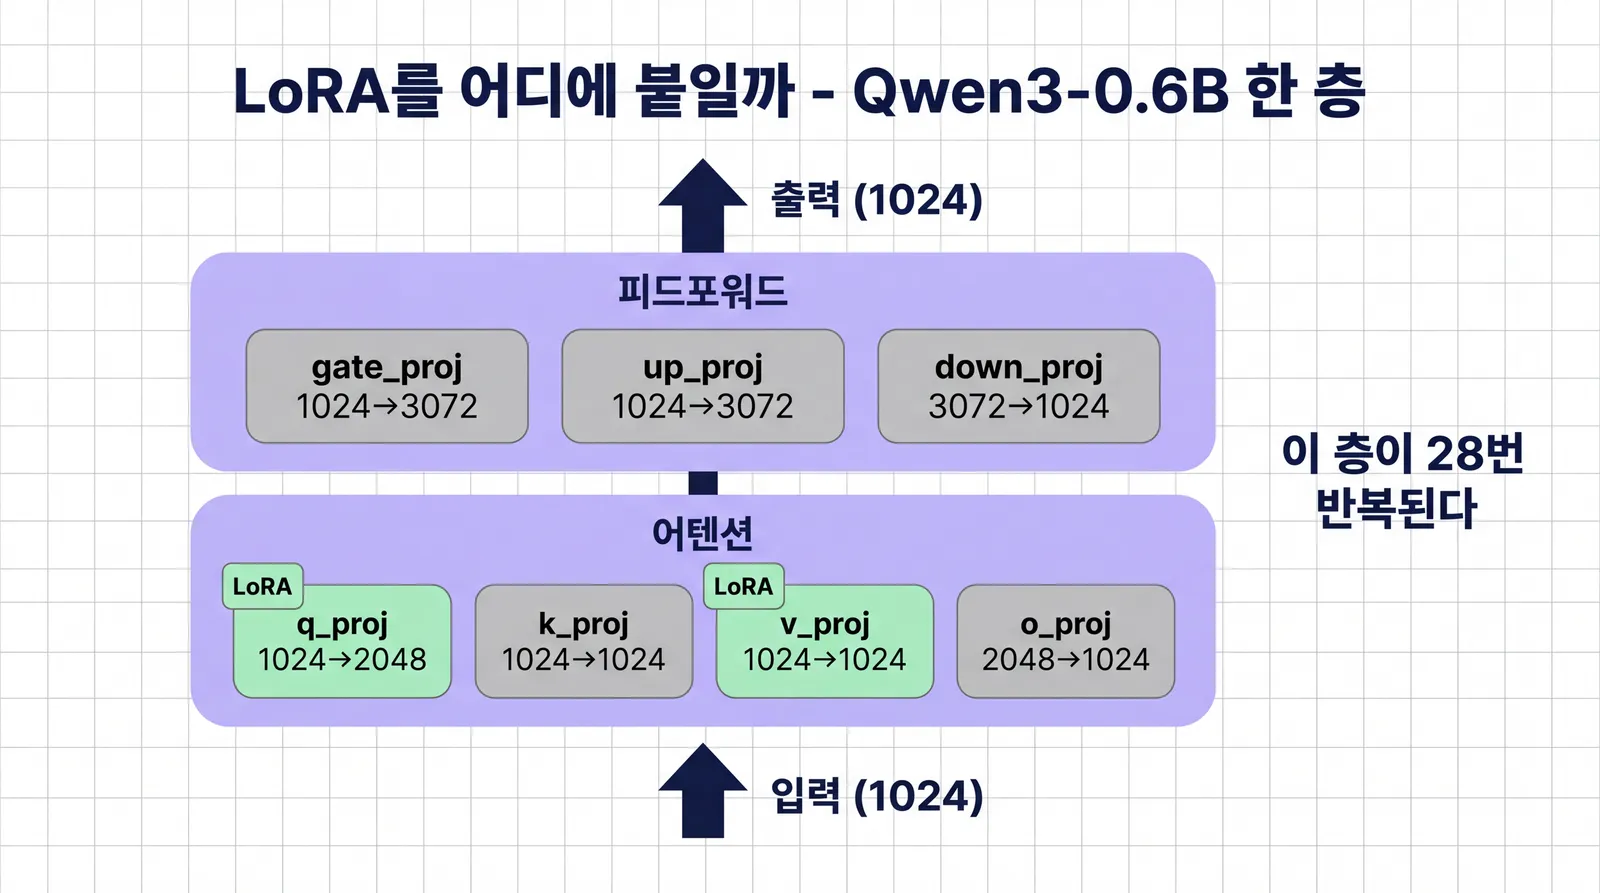
| 모듈 | 입력 -> 출력 | r = 8 LoRA (한 층) |
|---|---|---|
| q_proj | 1024 -> 2048 | 8 x (1024 + 2048) = 24,576 |
| k_proj | 1024 -> 1024 | 16,384 |
| v_proj | 1024 -> 1024 | 16,384 |
| o_proj | 2048 -> 1024 | 24,576 |
| gate_proj | 1024 -> 3072 | 32,768 |
| up_proj | 1024 -> 3072 | 32,768 |
| down_proj | 3072 -> 1024 | 32,768 |
- 공식은 3주차와 같다. 입력 a, 출력 b인 층에 랭크 r을 붙이면 r x (a + b)개다. 모양이 달라도 그대로 적용된다
□ 어디에, 얼마나 - 붙일 곳과 랭크
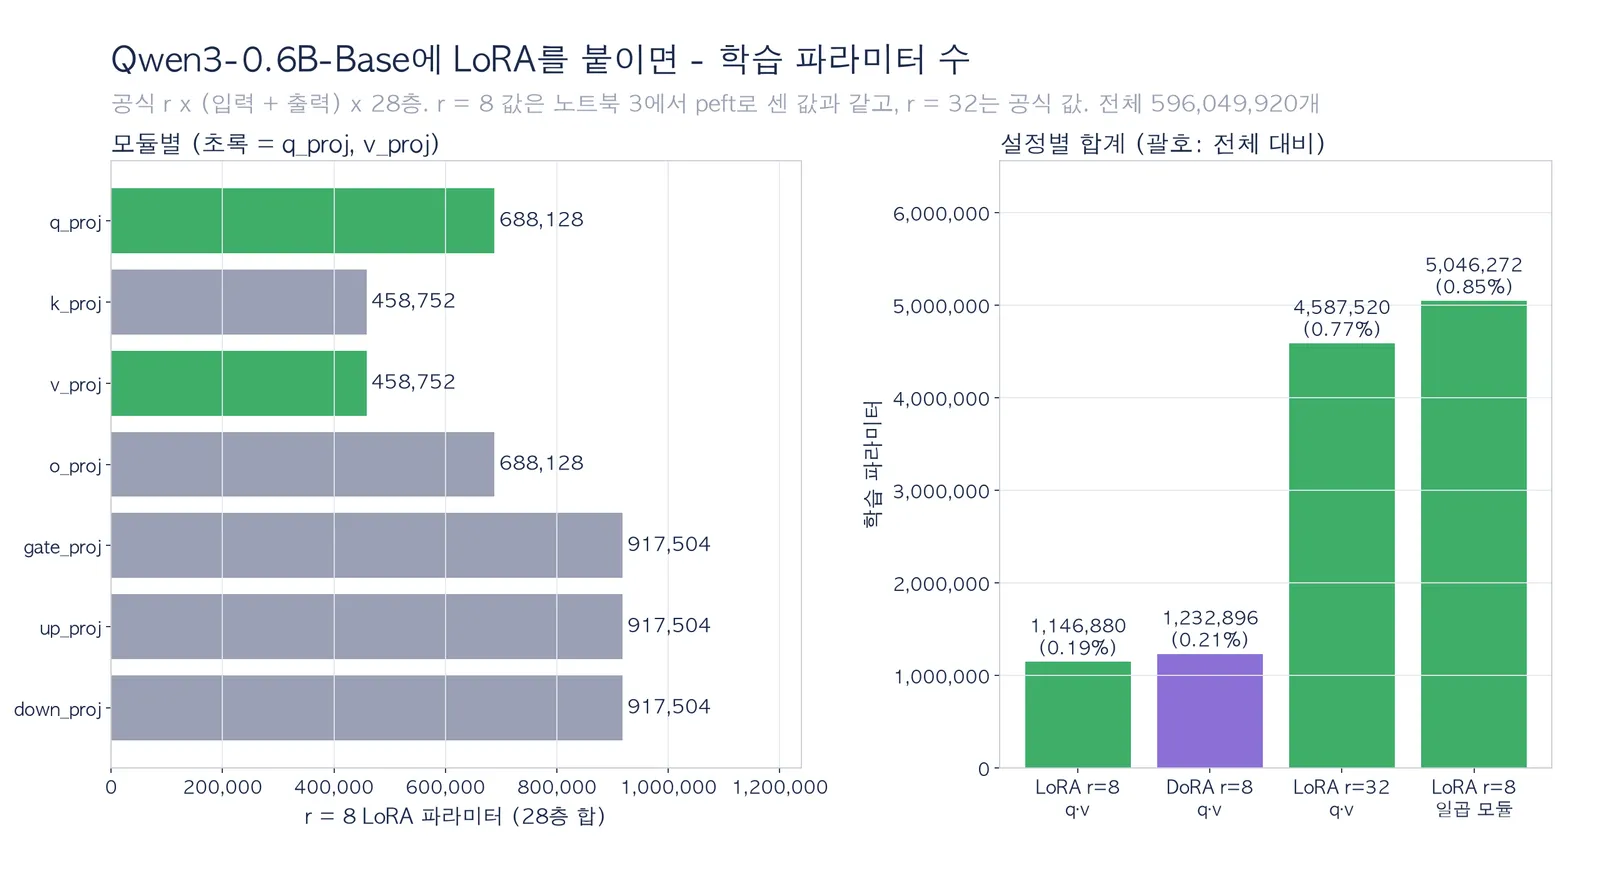
- 실습 노트북 3에서 Qwen3-0.6B-Base에 LoRA를 실제로 붙여 센 값이다. 공식으로 계산한 값과 한 개도 다르지 않다
| 설정 | 학습 파라미터 | 전체 596,049,920개 대비 |
|---|---|---|
| LoRA r = 8, q_proj와 v_proj | 1,146,880 | 0.192% |
| LoRA r = 8, 일곱 모듈 모두 | 5,046,272 | 0.847% |
| DoRA r = 8, q_proj와 v_proj | 1,232,896 | 0.207% |
- 계산을 따라가 보자. q_proj 24,576 + v_proj 16,384 = 한 층 40,960개, 28층이면 40,960 x 28 = 1,146,880개다. 일곱 모듈은 한 층 180,224개 x 28 = 5,046,272개다
- 3주차 KoELECTRA(12층, query와 value가 768 x 768)는 r = 4에서 어댑터 147,456개였다. 같은 r = 4라면 Qwen3-0.6B-Base의 q·v는 4 x (3,072 + 2,048) x 28 = 573,440개로 약 3.9배다
- 모델 전체는 5배 남짓 크지만 어댑터는 3.9배다. 어댑터 수는 모델 전체 크기가 아니라 붙인 층의 입출력 차원과 층 수로 정해지기 때문이다. 어느 쪽이든 전체의 1%가 안 된다
LoRA를 붙일 모듈과 랭크를 고른다. 실습 모델 Qwen3-0.6B-Base(28층) 기준으로 계산한다.
○ 예산을 랭크에 쓸까, 붙일 곳에 쓸까
- 비슷한 예산을 두 가지로 쓸 수 있다
- q_proj, v_proj에 r = 32: 32 x (3,072 + 2,048) x 28 = 4,587,520개
- 일곱 모듈 모두에 r = 8: 5,046,272개
- 어느 쪽이 나은지는 과제마다 다르고, 실험으로 정한다. 다만 근거가 되는 보고가 있다. QLoRA 논문은 LoRA의 하이퍼파라미터 중 어댑터를 모두 몇 개 쓰느냐가 가장 중요했고, 전체 미세조정 성능에 맞추려면 모든 선형 층에 LoRA를 붙여야 했다고 보고했다. LoRA 논문은 연구 범위를 어텐션 가중치로 한정했다(3주차). 두 보고의 실험 조건이 다르므로, 내 과제에서는 같은 예산의 두 설정을 비교표로 확인한다
- 3주차의 판단 순서는 그대로다. 예산을 먼저 숫자로 적고, r = 4(또는 8) 기준선을 만든 뒤, 부족하면 랭크나 붙일 곳을 늘린다
○ DoRA는 얼마나 더 붙나
- DoRA는 가중치를 크기와 방향으로 나눠, 방향은 LoRA로 고치고 크기는 따로 학습한다(3주차). 크기는 출력 차원마다 숫자 하나다
- q_proj, v_proj에 r = 8 DoRA를 붙이면 LoRA보다 (2048 + 1024) x 28 = 86,016개가 더 붙는다. 노트북 3의 실측(1,232,896 - 1,146,880 = 86,016)과 같다
- 학습 파라미터는 7% 남짓 늘지만, 학습 뒤 합칠 수 있으므로 추론 비용은 LoRA와 같다
□ 학습 메모리 - 3주차 규칙을 다시 적용하면
-
3주차 규칙: 학습하는 파라미터는 가중치 4 + 그래디언트 4 + Adam 기록 8 = 16바이트, 얼린 파라미터는 가중치만 4바이트(32비트)다. QLoRA는 얼린 가중치를 0.5바이트(4비트)로 올린다
-
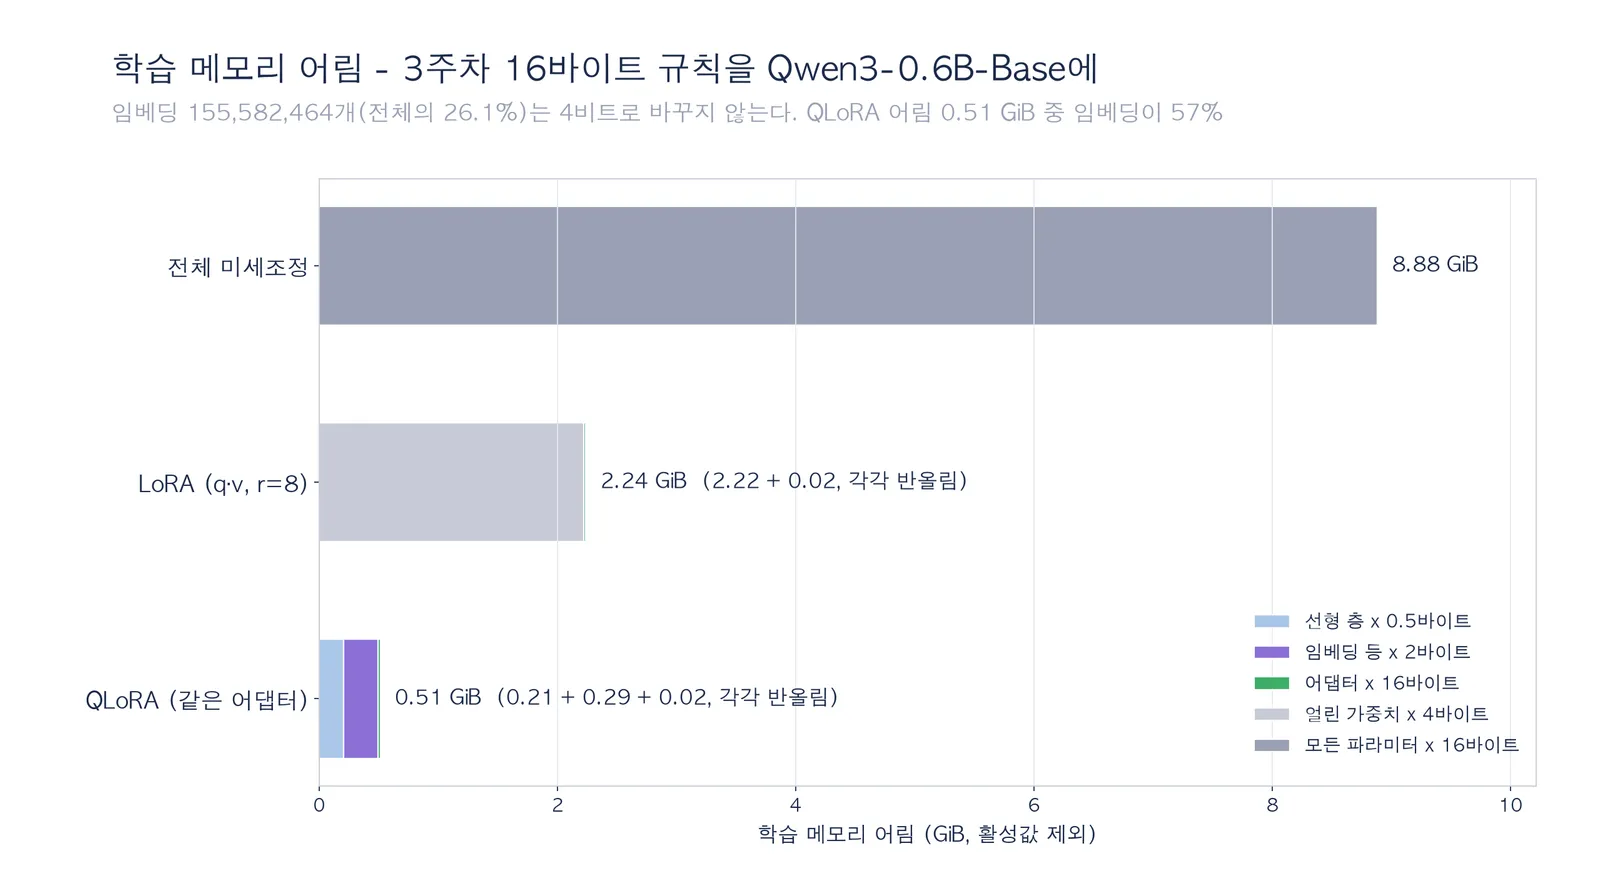
노트북 3-1의 어림이다(q·v r = 8 어댑터 기준)
| 방법 | 계산 | 어림 |
|---|---|---|
| 전체 미세조정 | 596,049,920개 x 16바이트 | 8.88 GiB |
| LoRA | 596,049,920개 x 4바이트 + 1,146,880개 x 16바이트 | 2.24 GiB |
| QLoRA | 선형 층 440,401,920개 x 0.5바이트 + 임베딩·정규화 층 155,648,000개(임베딩 155,582,464개 + 정규화 층 65,536개) x 2바이트 + 1,146,880개 x 16바이트 | 0.51 GiB |
- LoRA는 전체 미세조정의 약 4분의 1이다. 학습 파라미터는 0.19%인데 메모리는 4분의 1에 그치는 이유는 얼린 가중치(2.22 GiB)가 그대로 남기 때문이다. 3주차 막대그림의 “회색”이다
- QLoRA는 다시 그 4분의 1 아래로 내려간다. 다만 3주차 표처럼 8분의 1까지는 줄지 않았다. 아래에서 이유를 본다
○ 3주차 표와 무엇이 달라졌나 - 임베딩
- QLoRA가 4비트로 바꾸는 것은 선형 층이다. transformers 라이브러리의 4비트 변환도 nn.Linear만 바꾸고 임베딩은 그대로 둔다. 이 과목 노트북은 4비트 변환을 직접 돌리지 않으므로, 이 페이지의 QLoRA 어림은 이 동작을 가정한 계산이다
- Qwen3-0.6B-Base는 어휘가 151,936개라 임베딩이 151,936 x 1,024 = 155,582,464개, 전체의 26.1%다. 이 부분은 4비트가 되지 않는다
- 그래서 “모든 가중치 x 0.5바이트”로 어림하면 약 0.29 GiB지만, 임베딩을 16비트(2바이트)로 두면 약 0.51 GiB다. 남은 메모리의 절반 넘게가 임베딩이다
- 교훈: 3주차 표의 “가중치 x 0.5바이트”는 선형 층이 대부분인 모델에서 잘 맞는다. 어휘가 큰 작은 모델에서는 QLoRA의 이득이 표보다 작다. 어림할 때 무엇이 4비트가 되는지부터 확인한다
○ 7주차와 이어서 - 학습 메모리와 추론 메모리는 다르다
- 위 계산은 학습 중 메모리다. 미세조정한 모델을 서비스할 때는 7주차의 KV 캐시가 더해진다
- 같은 모델에서 32,768토큰 문맥 하나의 KV 캐시는 3.5 GiB(bf16)다. LoRA로 싸게 학습해도, 긴 문맥으로 서비스하면 추론 메모리가 학습 메모리를 넘을 수 있다. 예산은 학습과 추론을 따로 적는다
학습활동 - 기출 유형 자가 점검
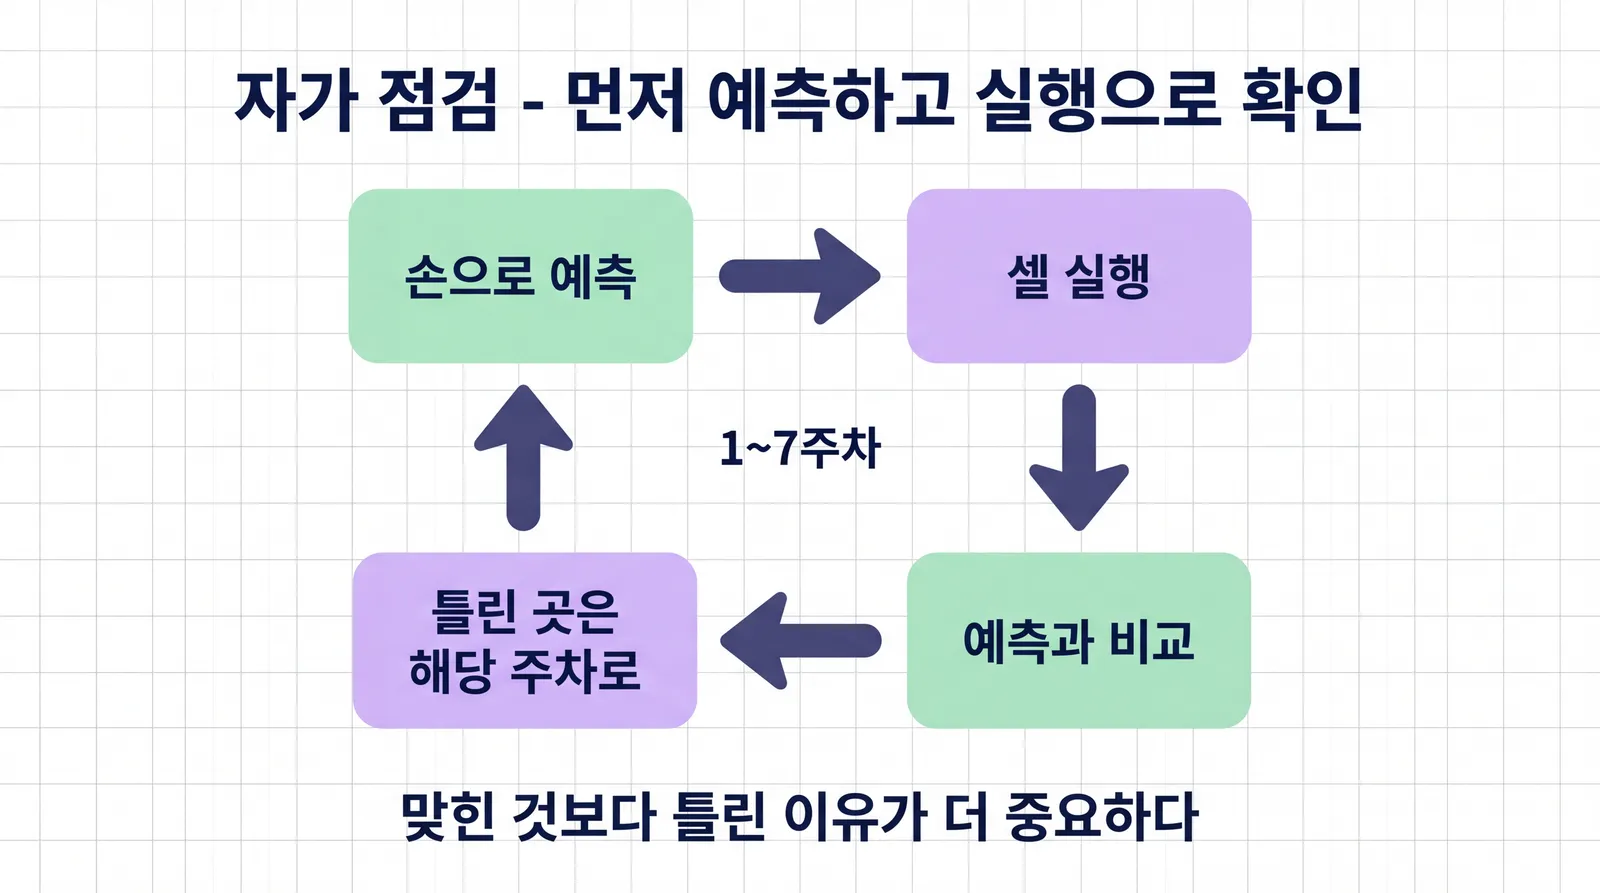
Section titled “학습활동 - 기출 유형 자가 점검”- 1~7주차 핵심 계산 일곱 문항을 먼저 손으로 예측하고 노트북을 실행해 확인한다. 노트북에는 바꿀 곳(TODO)이 없다
- 문항은 시험 유형을 연습하려고 만든 예시이며 실제 시험 문항이 아니다
| 문항 | 주차 | 손으로 할 것 |
|---|---|---|
| 1 어텐션 한 칸 | 1 | 점수, 소프트맥스, 가중합, n x n |
| 2 학습 루프 한 걸음 | 2 | 손실, 기울기, 한 걸음 뒤 값 |
| 3 LoRA 붙이기 (PEFT 심화) | 3 | r x (a + b), 28층 합, DoRA 크기 벡터, 메모리 어림 |
| 4 라벨 확률 | 4 | 로짓에서 소프트맥스, 확률 비 |
| 5 지표와 pass@k | 5 | 정밀도, 재현율, F1, 무편 추정량 |
| 6 코사인과 시각 토큰 | 6 | 코사인 유사도, logit_scale, 타일 수 |
| 7 KV 캐시와 RoPE | 7 | 토큰당 바이트, 주기, 위치 보간 |
- 틀린 문항이 있으면 그 주차의 강의 노트로 돌아간다. 맞힌 것보다 왜 틀렸는지가 시험 준비에 더 쓸모 있다
대면 (1시수)
Section titled “대면 (1시수)”- 중간고사는 이론과 실습 문제로 치르며 성적의 20%다
- 시험 범위, 시간, 장소, 허용 자료는 따로 공지한다. 이번 주 온라인 학습은 수업계획서대로 1~7주차 복습이다
□ 채점 기준 - 수업계획서의 성적 판정 기준
- 표현이 달라도 정답이다. 용어를 다르게 써도, 한글과 영문을 섞어 써도, 설명 경로가 달라도 개념을 옳게 짚었으면 정답이다
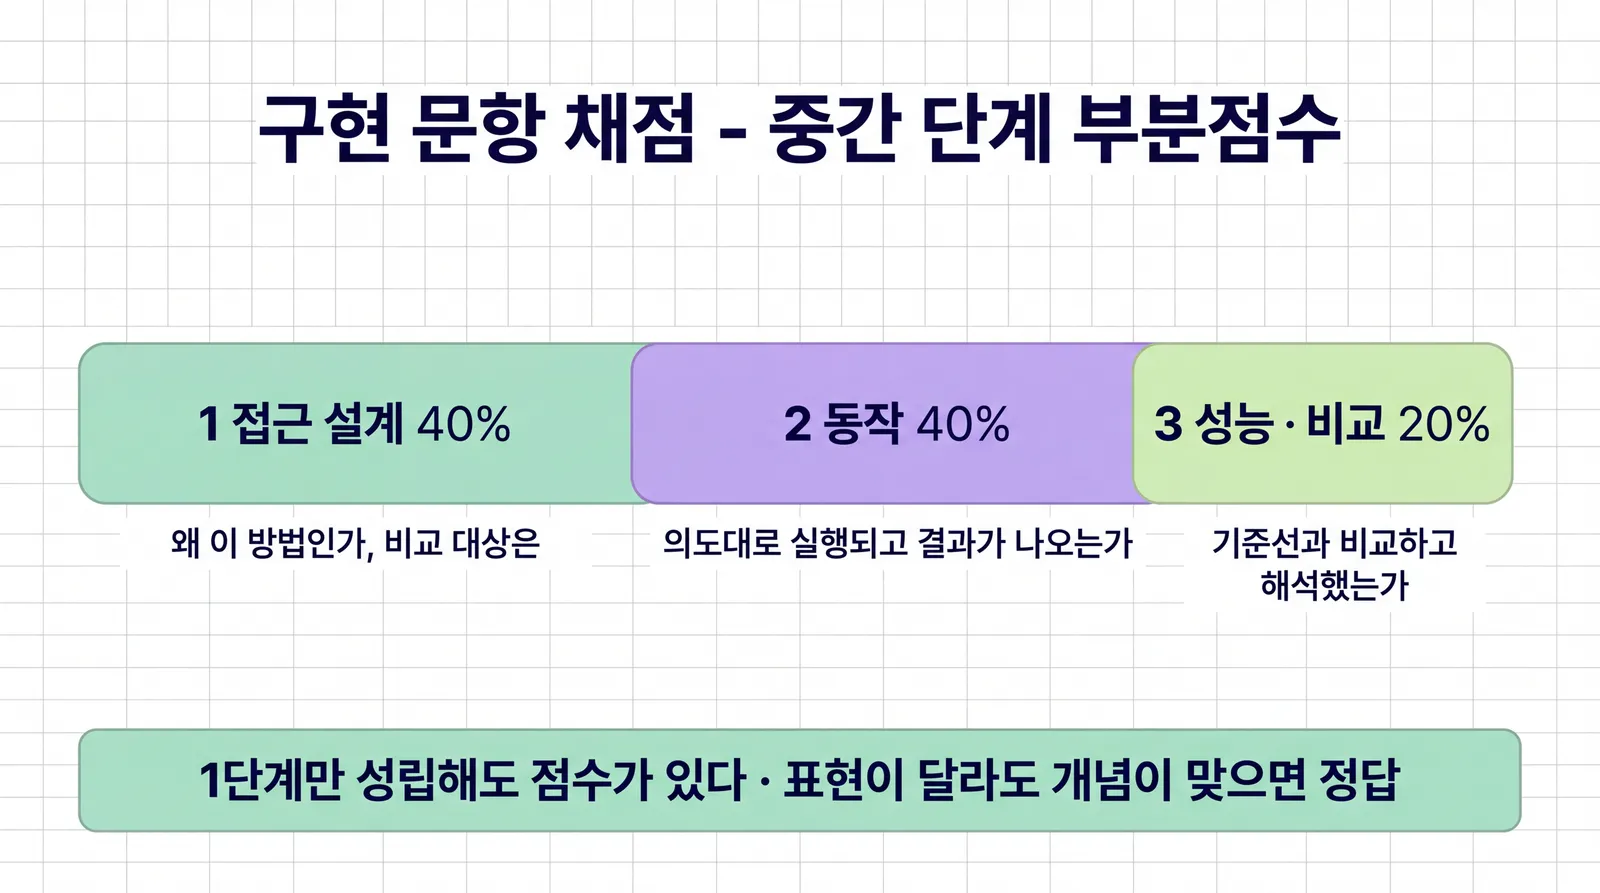
- 중간 단계 부분점수. 구현 문항은 세 단계로 나눠 본다. 1단계만 성립해도 점수가 나간다. 코드가 돌지 않았어도 무엇을 하려 했는지 서술하면 부분 점수를 받는다
□ 준비 점검표
- 7주차 대면의 개념 위계 표에서 각 줄의 핵심 질문에 세 문장으로 답할 수 있는가
- 1~7주차 “스스로 점검” 문항을 정답을 보지 않고 풀 수 있는가
- 이번 주 자가 점검 노트북의 일곱 문항을 예측으로 맞혔는가. 틀린 문항의 주차를 다시 읽었는가
- 숫자를 쓸 때 근거(어느 설정, 어느 실측)를 함께 쓰는 습관이 있는가. 5주차 Q4 근거 기준이다
[이론] 1~7주차 개념 위계를 스스로 그려 보고 빠진 마디를 확인한다
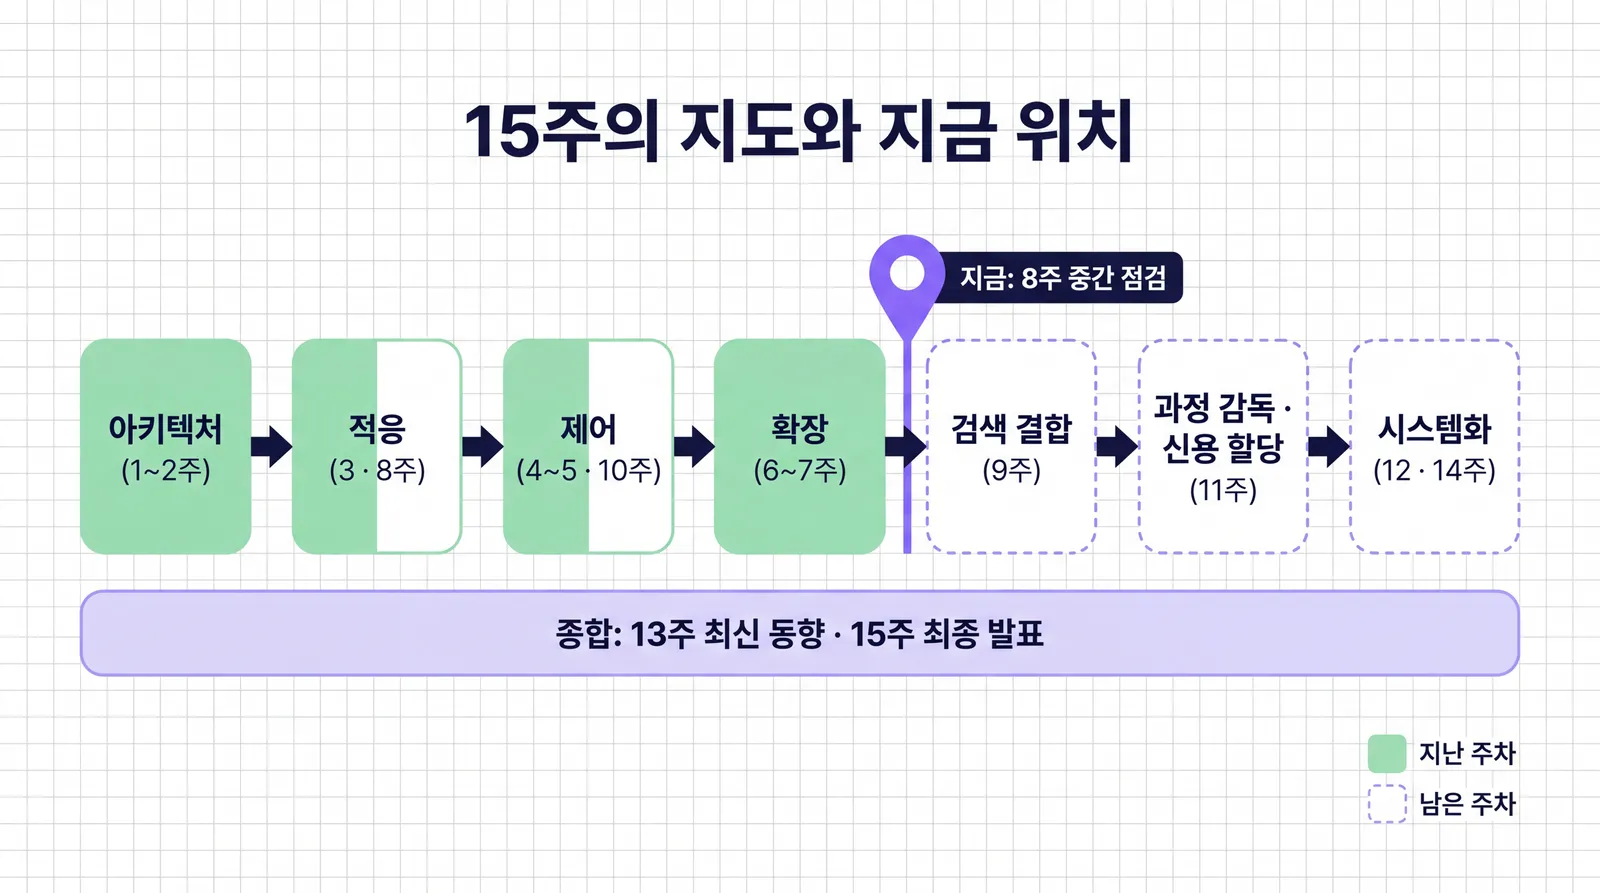
- 아키텍처, 적응, 제어, 확장의 네 마디에 주차와 핵심 개념을 붙인다(7주차 대면의 표)
- 마디 사이의 화살표에 “앞 마디의 무엇이 다음 마디의 재료인가”를 적는다. 예: 2주차의 학습 루프가 3주차 LoRA 학습에 그대로 쓰인다
- 세 문장으로 설명하지 못하는 마디를 표시하고, 그 주차의 강의 노트와 Q&A를 다시 본다
[구현] 기출 유형 중 구현 문항을 시간 제한 없이, 참고자료를 봐가며 먼저 풀어 보는 자가 점검
- 실습 노트북의 일곱 문항을 예측한 뒤 실행한다. 예측과 실행 결과가 다른 문항은 차이의 원인을 한 줄로 적는다
- 3번 문항은 PEFT 심화다. q·v와 일곱 모듈, LoRA와 DoRA의 학습 파라미터를 표로 정리한다
[실무] 팀 프로젝트 중간 점검 및 피드백. 캡스톤 연계 상태를 함께 확인해 같은 학기 두 과목의 산출이 서로를 갉아먹지 않는지 점검한다
- 팀 프로젝트 점검: 문제 정의 한 문장, 쓰는 공개 데이터와 출처, 1~7주차 중 어느 기법을 쓰는지, 지금 돌아가는 결과물, 다음 마디(검색 결합, 시스템화)에서 붙일 것
- 예산 점검: 이번 주 계산법으로 우리 팀 설정의 학습 메모리와 추론 메모리(KV 캐시)를 따로 적는다
- 캡스톤 연계 점검: 두 과목의 주제가 어떻게 이어지는가, 같은 결과물을 두 과목에 낼 때 각 과목이 요구하는 산출이 무엇인지 구분했는가, 두 과목의 마감이 겹치는 주를 미리 표시했는가
- 도내 기업 데이터는 쓰지 않는다. 기업이나 기관은 조건 상정으로만 등장한다
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. LoRA 학습 파라미터가 0.2%면 메모리도 0.2%로 드는가?
아니다. 얼린 가중치도 메모리에 올려야 한다. Qwen3-0.6B-Base에서 q·v r = 8 LoRA는 학습 파라미터가 전체의 0.19%지만, 얼린 가중치 596,049,920개 x 4바이트 = 약 2.22 GiB가 그대로 남아 어림 합계가 약 2.24 GiB다. 전체 미세조정(약 8.88 GiB)의 4분의 1 정도다. 줄어든 것은 그래디언트와 옵티마이저 기록이다.
Q2. QLoRA를 쓰면 메모리가 언제나 8분의 1이 되는가?
아니다. 4비트가 되는 것은 선형 층이다. 실습 모델은 임베딩이 전체의 26.1%라 그 부분은 4비트가 되지 않고, 임베딩을 16비트로 두면 QLoRA 어림의 절반 넘게를 임베딩이 차지한다. 어휘가 작고 선형 층이 대부분인 큰 모델일수록 3주차 표에 가까워진다.
Q3. 랭크를 2배로 올리면 학습 파라미터도 2배인가?
어댑터만 보면 정확히 2배다. r x (a + b)에서 r만 바뀌기 때문이다. 다만 3주차 실습처럼 분류 헤드를 함께 학습하면 헤드 몫은 그대로라서 전체 학습 파라미터는 2배가 되지 않는다. DoRA의 크기 벡터도 랭크와 상관없이 그대로다.
Q4. 모든 선형 층에 붙이는 것이 언제나 정답인가?
정답은 없다. QLoRA 논문은 모든 선형 층에 붙여야 전체 미세조정 성능에 맞았다고 보고했고, LoRA 논문은 어텐션 가중치만으로 연구 범위를 잡았다. 실험 조건이 다르다. 내 과제에서 같은 예산의 두 설정(랭크를 키우기 vs 붙일 곳을 늘리기)을 비교표로 확인하는 것이 근거 있는 선택이다.
Q5. 중간고사에서 용어를 교재와 다르게 쓰면 틀리는가?
틀리지 않는다. 미세조정, 파인튜닝, fine-tuning처럼 용어가 달라도, 한글과 영문을 섞어도, 설명 경로가 달라도 개념을 옳게 짚었으면 정답이다. 수업계획서의 성적 판정 기준이다.
Q6. 구현 문항에서 코드가 돌지 않으면 0점인가?
아니다. 접근 설계(40%), 동작(40%), 성능·비교(20%)로 나눠 보고, 1단계만 성립해도 점수가 있다. 무엇을 왜 하려 했는지, 무엇과 비교하려 했는지를 쓰면 부분 점수를 받는다.
스스로 점검
Section titled “스스로 점검”- 입력 1024, 출력 2048인 층에 r = 16 LoRA를 붙이면 몇 개인가?
- Qwen3-0.6B-Base의 q_proj와 v_proj 출력 차원이 다른 이유를 7주차 개념으로 설명하자.
- 같은 모델에서 q·v r = 8 LoRA의 학습 메모리 어림이 전체 미세조정의 약 4분의 1에 그치는 이유는?
- QLoRA 어림에서 임베딩을 4비트로 계산하면 안 되는 이유와, 그 차이가 큰 모델의 특징은?
- DoRA는 LoRA보다 무엇을 더 학습하고, 그 개수는 무엇으로 정해지는가?
- 1~7주차 개념 위계의 네 마디와 각 마디의 주차를 쓰자.
정답 보기
- 16 x (1024 + 2048) = 49,152개
- 쿼리 헤드는 16개, KV 헤드는 8개(GQA)이고 헤드 차원이 128이라 q_proj 출력은 16 x 128 = 2048, v_proj 출력은 8 x 128 = 1024다
- 얼린 가중치 596,049,920개 x 4바이트(약 2.22 GiB)가 그대로 남기 때문이다. 줄어든 것은 학습 파라미터의 그래디언트와 Adam 기록뿐이다
- 4비트 변환은 선형 층만 바꾸고 임베딩은 그대로 두기 때문이다. 어휘가 커서 임베딩 몫이 큰 모델(실습 모델은 26.1%)일수록 차이가 크다
- 가중치의 크기(출력 차원마다 숫자 하나)를 따로 학습한다. 개수는 붙인 층의 출력 차원 합 x 층 수다. q·v면 (2048 + 1024) x 28 = 86,016개
- 아키텍처(1
2주), 적응(3주, 8주 심화), 제어(45주), 확장(6~7주)
1~7주차 핵심 용어 다시 보기
Section titled “1~7주차 핵심 용어 다시 보기”| 주차 | 용어 | 한 줄 뜻 |
|---|---|---|
| 1 | 셀프 어텐션의 제곱 비용 | 모든 토큰이 모든 토큰을 보므로 점수표가 n x n |
| 1 | 상태공간모델 | 고정 크기 상태로 순서대로 읽어 길이에 정비례하는 구조 |
| 2 | 학습 루프 | 순전파, 손실, 역전파, 갱신을 되풀이하는 절차 |
| 2 | FlashAttention | 같은 어텐션을 메모리 왕복을 줄여 빠르게 계산하는 방법 |
| 3 | LoRA | 얼린 가중치 옆에 저랭크 행렬 B·A만 학습 |
| 3 | QLoRA | 얼린 가중치를 4비트로 올리고 LoRA 학습 |
| 4 | 문맥학습 | 가중치를 바꾸지 않고 문맥의 예시로 동작을 바꾸는 것 |
| 4 | Chain-of-Thought | 답 전에 단계별 풀이를 생성하게 하는 프롬프트 |
| 5 | false acceptance | 그럴듯한 오답을 판정자가 통과시키는 것 |
| 5 | pass@k | k번 시도 안에 한 번이라도 맞힐 확률 |
| 6 | 대조 학습 | 짝이 맞는 쌍은 가깝게, 나머지는 멀게 하는 학습 |
| 6 | 시각 토큰 | 사진이 언어모형 문맥에서 차지하는 토큰 |
| 7 | KV 캐시 | 앞 토큰의 Key와 Value를 저장한 추론용 메모. 길이에 정비례 |
| 7 | RoPE와 위치 보간 | 위치를 회전 각도로 넣고, 긴 위치를 학습 범위 안으로 줄이는 확장 |
| 7 | Lost in the Middle | 긴 입력의 가운데 정보를 덜 쓰는 현상 |
실습 노트북
Section titled “실습 노트북”
1~7주차 핵심 계산 일곱 문항을 먼저 손으로 예측하고 셀을 실행해 확인하는 자가 점검 노트북이다. 3번 문항은 PEFT 심화로, Qwen3-0.6B-Base의 설정으로 모델을 만들어 LoRA와 DoRA를 실제로 붙이고 학습 파라미터를 센다(가중치 파일은 내려받지 않는다). 바꿀 곳(TODO)은 없다. 작성 환경의 CPU에서 1회 실행해 처음부터 끝까지 약 25초 걸렸다(설정 파일 내려받는 시간 제외).