
6주차: 멀티모달 표현의 결합
멀티모달 표현의 결합
□ 이 주차가 놓이는 자리
- 5주차까지 모델은 글자(토큰)만 봤다. 질문도 답도 텍스트였다. 그런데 현장 데이터의 상당 부분은 글이 아니다. 사진, 관측 장비의 화면, 스캔한 기록지가 그렇다
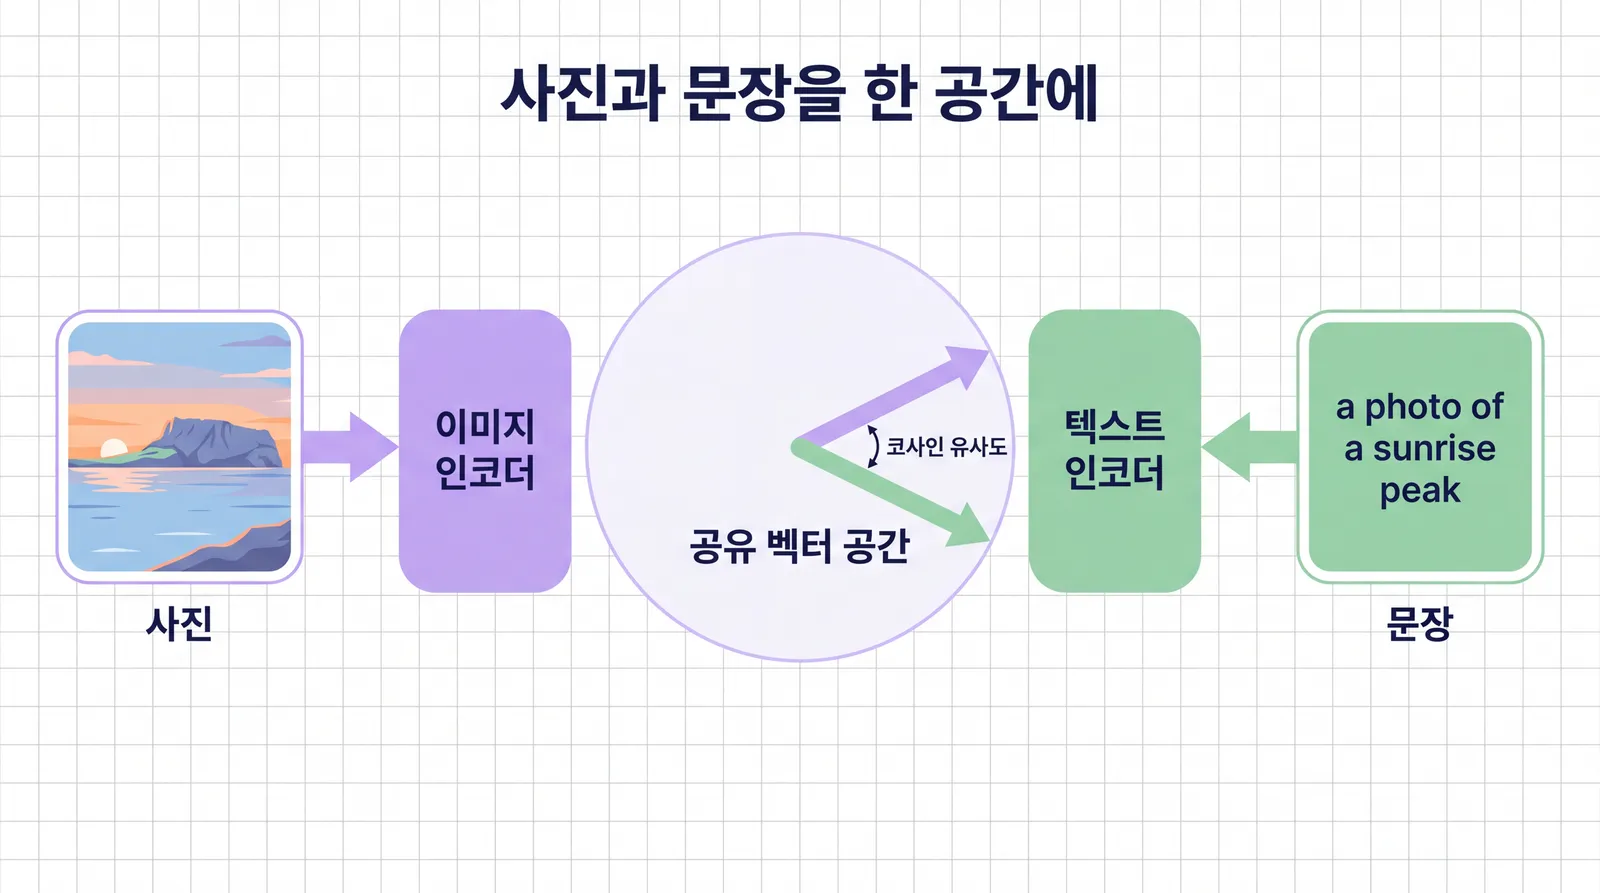
- 이번 주는 사진과 글을 같은 공간에서 다루는 모델을 본다. 핵심 질문은 둘이다
- 사진과 문장을 어떻게 하나의 벡터 공간에 놓는가 (정렬, alignment)
- 정렬된 모델에 사진을 넣고 질문하면 무엇이 가능해지고 무엇이 깨지는가
- 두 가지 구조를 나란히 돌려 본다
- 이중 인코더(dual encoder, CLIP): 사진과 문장을 각자 벡터로 만들어 비교만 한다. 빠르지만 문장을 생성하지는 못한다
- 인코더 + 언어모형(VLM, SmolVLM): 사진을 시각 토큰으로 바꿔 언어모형의 문맥에 붙이고 문장으로 답하게 한다. 유연하지만 사진이 문맥의 대부분을 차지한다
□ 이번 주가 답하는 질문
- 사진과 문장의 유사도는 어떻게 계산되고, 그 공간은 어떻게 학습되는가
- 사진과 글은 모델 안의 어디에서 만나는가 (CLIP, Flamingo, LLaVA)
- 같은 질문을 텍스트 전용 모델과 멀티모달 모델에 주면 답이 어떻게 다른가
- 사진 1장은 문맥에서 몇 토큰이 되고, 그 수는 무엇이 정하는가
- 라벨이나 질문이 한국어일 때 정렬이 어떻게 깨지는가
□ 읽기 안내 - 이 노트의 어디와 이어지나
| 읽기 | 이 노트에서 다루는 곳 |
|---|---|
| CLIP, Radford 외, 2021, arXiv:2103.00020 | 이중 인코더, 대조 학습, 제로샷 분류 |
| Flamingo, Alayrac 외, 2022, arXiv:2204.14198 | 사진과 글이 만나는 세 자리 (교차 어텐션) |
| LLaVA, Liu 외, 2023, arXiv:2304.08485 | 사진과 글이 만나는 세 자리 (투영해서 토큰으로) |
| (참고) SmolVLM, Marafioti 외, 2025, arXiv:2504.05299 | 실습 모델, 시각 토큰 수 |
□ 사진과 실측에 대하여
- 예제 사진은 위키미디어 공용에 올라 있는 제주 공개 사진 5장이다(우도 사진은 공공누리 제1유형). 저자와 라이선스는 이 문서 아래 [사진 출처] 표에 있다
- 본문의 숫자와 답은 이 저장소에서 실습 노트북을 그대로 실행한 값이다. 모델은 CLIP(openai/clip-vit-base-patch32), SmolVLM(HuggingFaceTB/SmolVLM-256M-Instruct), 텍스트 전용 모델(Qwen/Qwen3-0.6B-Base)이다. 답은 탐욕 디코딩이라 같은 환경에서는 같게 나오지만, 라이브러리 버전이 다르면 문구나 소수점이 조금 달라질 수 있다
- 도내 기업 데이터는 없다. 기업은 학습활동 [실무]에서 조건 상정으로만 등장한다
온라인 (2시수)
Section titled “온라인 (2시수)”강의: 사진과 문장을 한 공간에 놓는 방법들
Section titled “강의: 사진과 문장을 한 공간에 놓는 방법들”□ 읽기 준비 - 벡터, 내적, 코사인 유사도
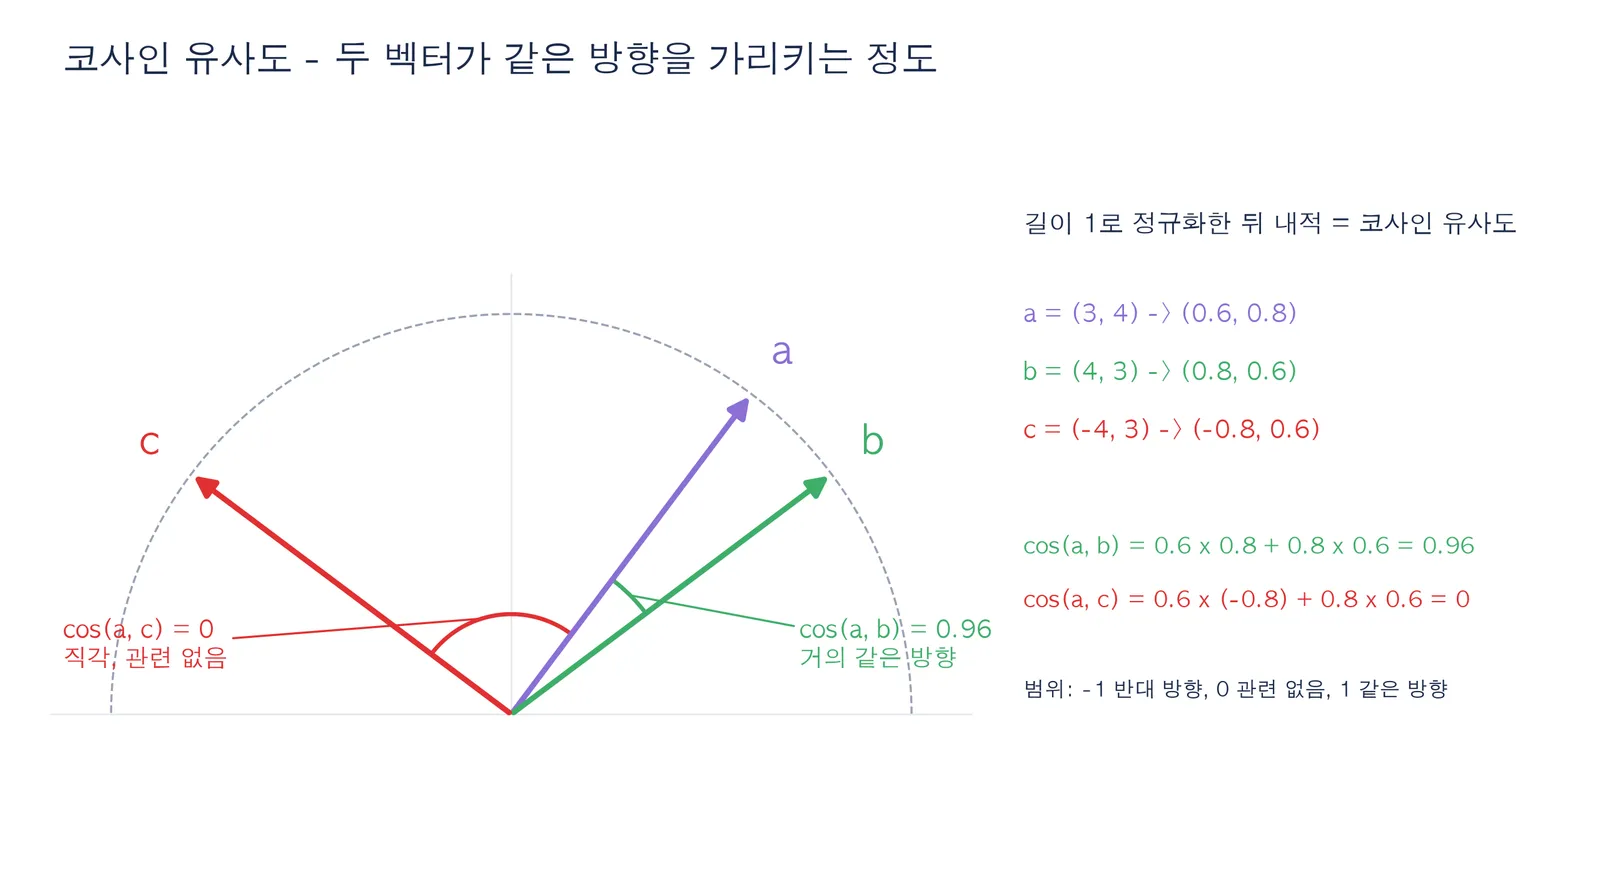
- 이번 주의 모든 계산은 두 벡터가 얼마나 같은 방향을 가리키는가로 귀결된다. 먼저 2차원 벡터로 감을 잡는다
- 벡터 a = (3, 4)의 길이는 √(3² + 4²) = 5다. 길이로 나누면 (0.6, 0.8)이 된다. 이것을 정규화라 한다. 방향은 그대로 두고 길이만 1로 맞추는 것이다
- 길이가 1인 두 벡터의 내적은 두 벡터 사이 각의 코사인과 같다. 이것이 코사인 유사도다
a = (3, 4)   -> 정규화 (0.6, 0.8)b = (4, 3)   -> 정규화 (0.8, 0.6)c = (-4, 3)  -> 정규화 (-0.8, 0.6)
cos(a, b) = 0.6 x 0.8 + 0.8 x 0.6 = 0.96 거의 같은 방향cos(a, c) = 0.6 x (-0.8) + 0.8 x 0.6 = 0 직각, 관련 없음- 코사인 유사도는 -1에서 1 사이다. 1에 가까울수록 같은 방향이다. CLIP은 이 계산을 512차원에서 한다. 차원만 많을 뿐 원리는 같다
□ 왜 “비교”와 “생성”이 갈리는가
- 사진을 아는 모델을 만드는 길은 크게 둘이다
- 비교형: 사진 벡터와 문장 벡터의 유사도를 계산한다. “이 사진은 이 문장과 얼마나 닮았나”를 재는 자
- 생성형: 사진을 언어모형에 넣어 문장을 이어 쓰게 한다. “이 사진에 대해 답하라”를 수행하는 자
- 두 구조는 쓰임이 다르고 깨지는 방식도 다르다. 이번 주는 둘 다 직접 돌려 본다. 아래는 비교형(CLIP)의 계산이 흘러가는 순서다
아래 단계 버튼을 눌러 흐름을 따라가 보세요. (모델은 CLIP ViT-B/32, 수치는 6주차 노트북 실측값)
□ 이중 인코더(CLIP) - 두 벡터의 코사인 유사도
- CLIP은 이미지 인코더와 텍스트 인코더 둘을 동시에 학습시켰다. 짝이 맞는 (사진, 문장) 쌍의 벡터는 가깝게, 짝이 아닌 쌍은 멀어지게 하는 것이 목표다
- 두 인코더의 내부는 전혀 다르다
- 이미지 인코더는 ViT-B/32다. 사진을 224x224로 맞춘 뒤 32x32 픽셀 조각(패치) 7x7 = 49개로 잘라, 조각 하나를 토큰처럼 읽는 트랜스포머다. 이름의 “/32”가 패치 크기다
- 텍스트 인코더는 텍스트 트랜스포머다. 한 문장에 토큰을 77개까지 받는다
- 두 인코더 끝에 투영 층을 하나씩 두어 내보내는 벡터를 같은 512차원으로 맞춘다. 두 투영 층이 같은 공간에 벡터를 놓도록 함께 학습된다
- 비교는 앞에서 본 그대로다. 두 벡터를 길이 1로 정규화한 뒤 내적하면 코사인 유사도가 나온다
○ CLIP은 이 공간을 어떻게 배웠나 - 대조 학습
- 학습 데이터는 인터넷에서 모은 4억 쌍의 (사진, 문장)이다. 쌍을 모을 때 쓴 검색어 50만 개는 영어 위키백과에 100번 이상 나오는 단어 등에서 만들었다. 그래서 이 공간의 문장 쪽은 영어 중심이다. 뒤에서 한국어 라벨이 무너지는 이유가 여기서 나온다
- 한 번의 학습 단계는 이렇게 돌아간다
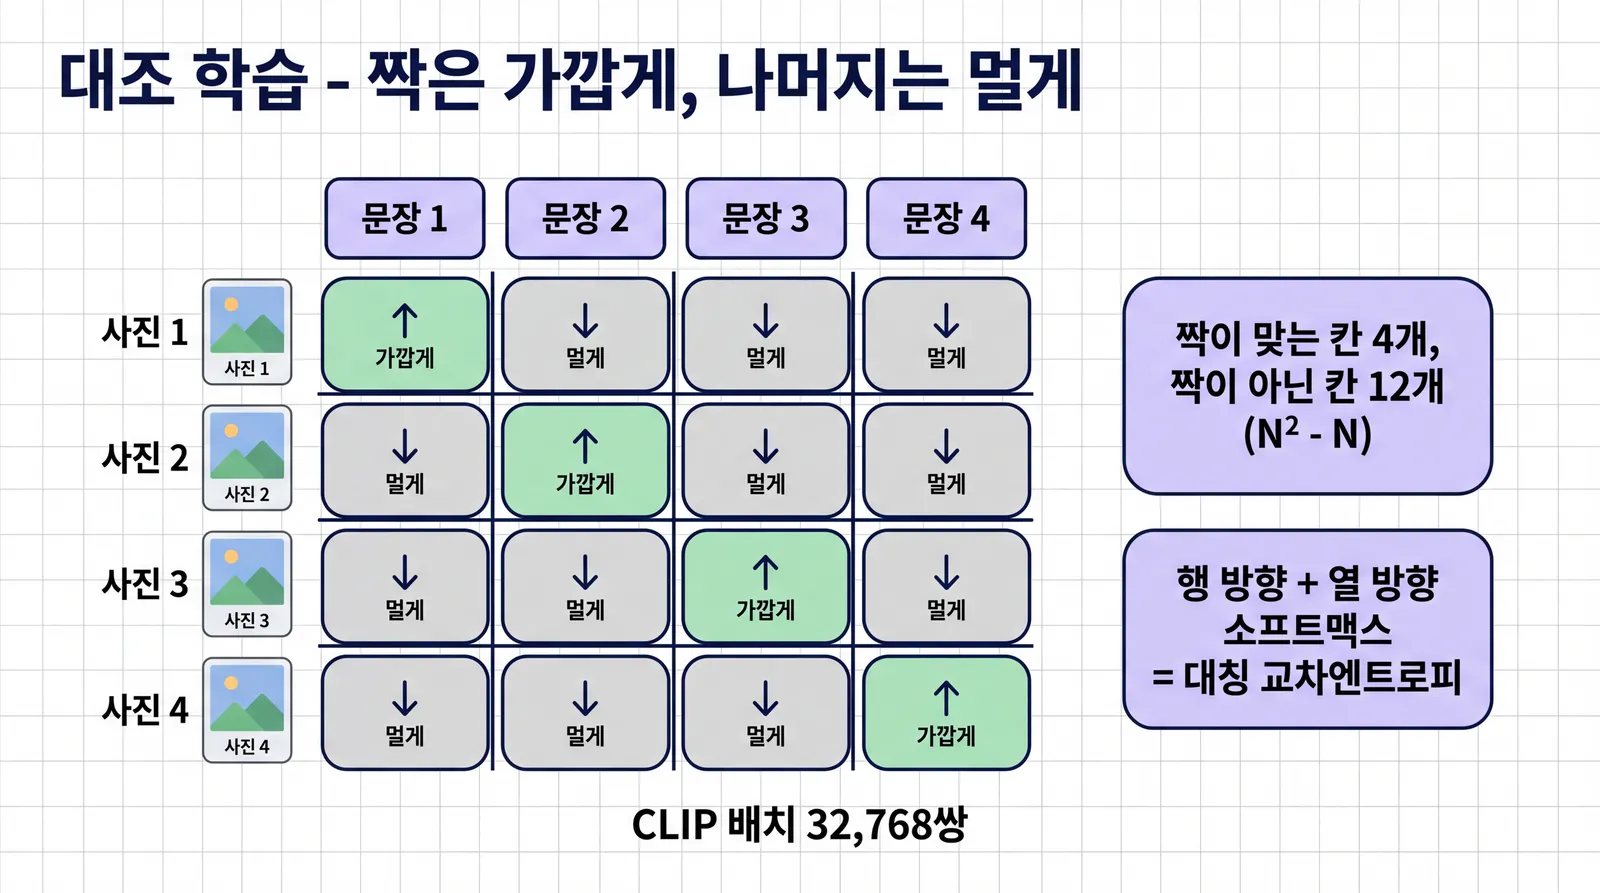
- 배치에서 (사진, 문장) 쌍 N개를 꺼낸다. 사진 N장과 문장 N개가 된다
- 사진 N장 x 문장 N개의 코사인 유사도 표(N x N)를 만든다
- 대각선 N칸이 짝이 맞는 쌍, 나머지 N² - N칸이 짝이 아닌 쌍이다
- 각 행(사진 하나)에서 “N개 문장 중 짝을 고르는” 분류 문제를 풀고, 각 열(문장 하나)에서도 같은 문제를 푼다. 두 방향의 교차엔트로피를 평균한다. 이것을 대칭 교차엔트로피라 한다
- CLIP의 배치는 32,768쌍이었다. 사진 한 장이 한 단계에서 짝이 아닌 문장 32,767개와 비교되는 셈이다. 비교 대상이 많을수록 “비슷하지만 틀린” 문장과 구별하는 힘이 커진다
- 유사도를 소프트맥스에 넣기 전에 곱하는 수가 logit_scale이다. 온도의 역수에 해당하는 배율로 학습되며, 논문은 이 배율이 100을 넘지 않도록 잘라 두었다(학습이 불안정해지는 것을 막으려고). 실습 모델의 값이 정확히 100.0인 것은 학습 중에 이 상한에 닿았기 때문으로 읽을 수 있다
○ 제로샷 분류 - 분류기를 학습하지 않고 고르기
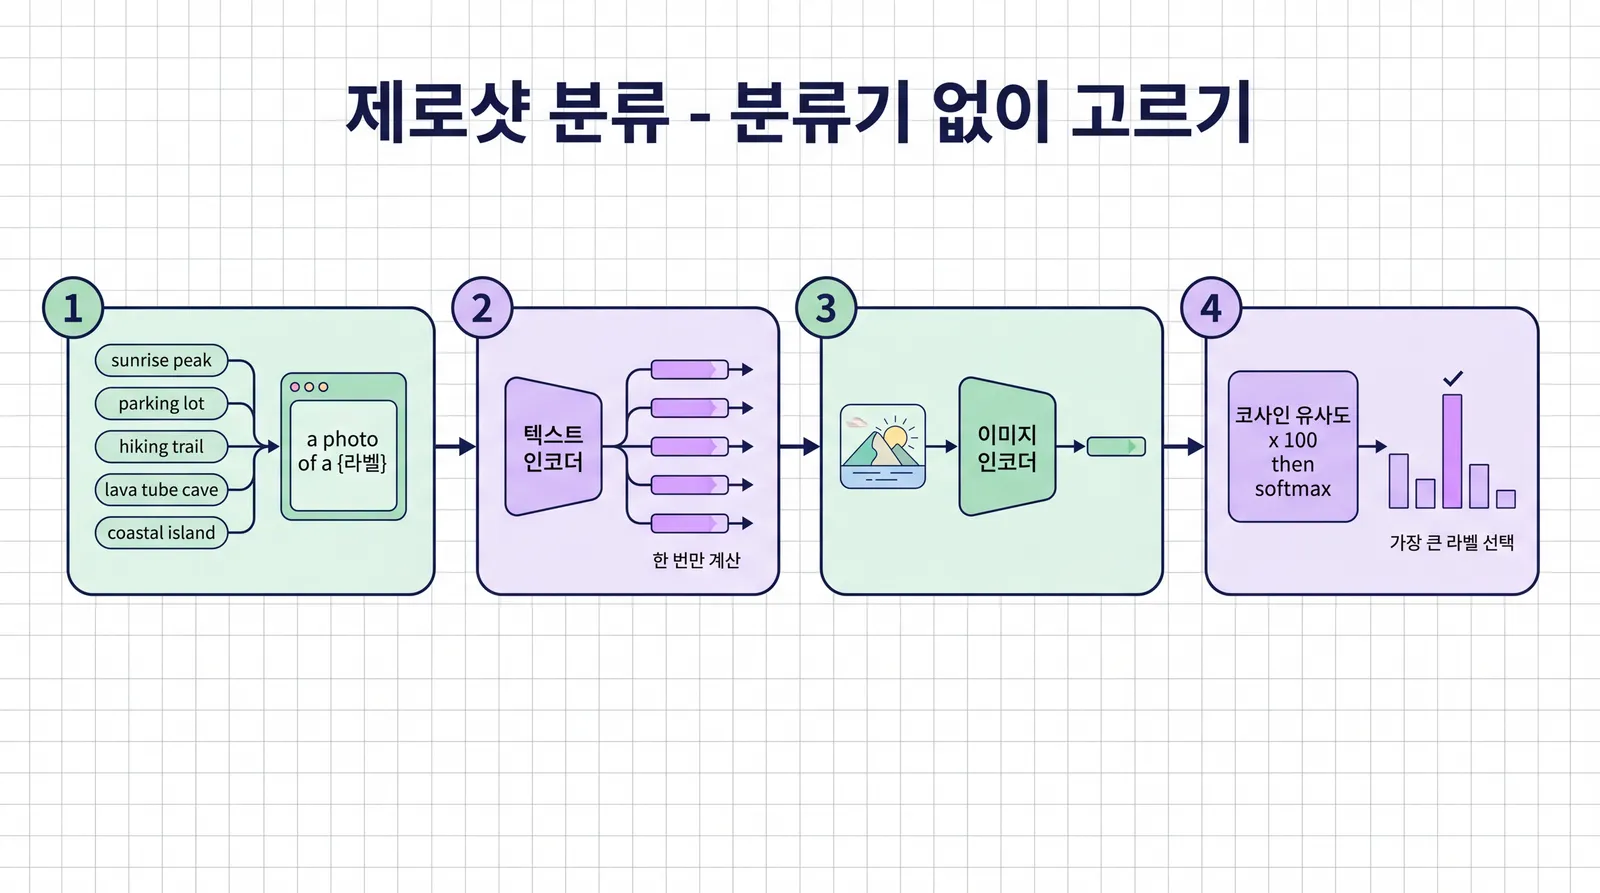
- CLIP은 “분류기 머리”를 따로 학습하지 않는다. 후보 라벨을 문장으로 바꿔 텍스트 인코더에 넣고, 사진 벡터와 가장 비슷한 문장을 고른다. 학습 때 본 적 없는 라벨로도 바로 쓸 수 있어서 제로샷 분류라 한다
- 절차는 네 단계다
- 라벨을 문장 틀에 끼운다. 예:
a photo of a {라벨} - 문장들을 텍스트 인코더로 벡터로 만든다. 라벨이 바뀌지 않으면 한 번만 계산해 두면 된다
- 사진을 이미지 인코더로 벡터로 만든다
- 코사인 유사도에 logit_scale(100)을 곱하고 소프트맥스를 씌워 확률로 바꾼다
- 라벨을 문장 틀에 끼운다. 예:
- 문장 틀이 왜 필요한가. 학습 데이터에서 사진에 붙은 글은 단어 하나보다 문장인 경우가 많다. 논문은
A photo of a {label}.이라는 틀만으로 ImageNet 정확도가 1.3% 올랐고, 서로 다른 틀 80개로 만든 텍스트 벡터를 평균(앙상블)하면 3.5%가 더 올라 합쳐서 5% 가까이 좋아졌다고 보고했다. 라벨 설계가 4주차 프롬프트 설계의 멀티모달판이다
- logit_scale 100이 하는 일을 실측으로 보자. 성산 일출봉 사진에 짧은 영어 라벨 다섯 개를 줬다
a photo of a sunrise peak cos 0.266 -> logit 26.6 -> 확률 0.307a photo of a coastal island cos 0.274 -> logit 27.4 -> 확률 0.683(나머지 세 라벨은 cos 0.18~0.23이라 확률 0.01 미만)- 코사인 차이는 0.008뿐인데 로짓 차이는 0.8이 되고, 확률로는 약 2.2배(e^0.8) 차이가 난다. 코사인이 거의 같아도 소프트맥스 뒤에는 한쪽으로 크게 기운다. 이 사진은 해안 섬 쪽으로 틀렸다. 바다와 봉우리가 함께 찍힌 사진이라 두 라벨이 모두 그럴듯하다
○ 제로샷 실측 - 라벨의 언어가 결과를 바꾼다
- 제주 사진 5장(성산 일출봉, 성산 주차장, 영실 등산로, 만장굴, 우도 해안)에 라벨 조합 네 가지로 제로샷 분류를 돌렸다. 아래에서 라벨 조합을 바꿔 가며 보라. 행은 사진, 열은 후보 라벨이다
라벨 조합을 바꿔가며 히트맵을 보세요. 행: 사진, 열: 후보 라벨. 가장 진한 칸이 모델이 고른 라벨이고, 대각선이 진하면 정답을 골라낸 것이다. 테두리 초록은 정답, 빨강은 오답. (모델: CLIP ViT-B/32, 제주 공개 사진 5장 실측)
| 라벨 조합 | 정답 | 무슨 일이 있었나 |
|---|---|---|
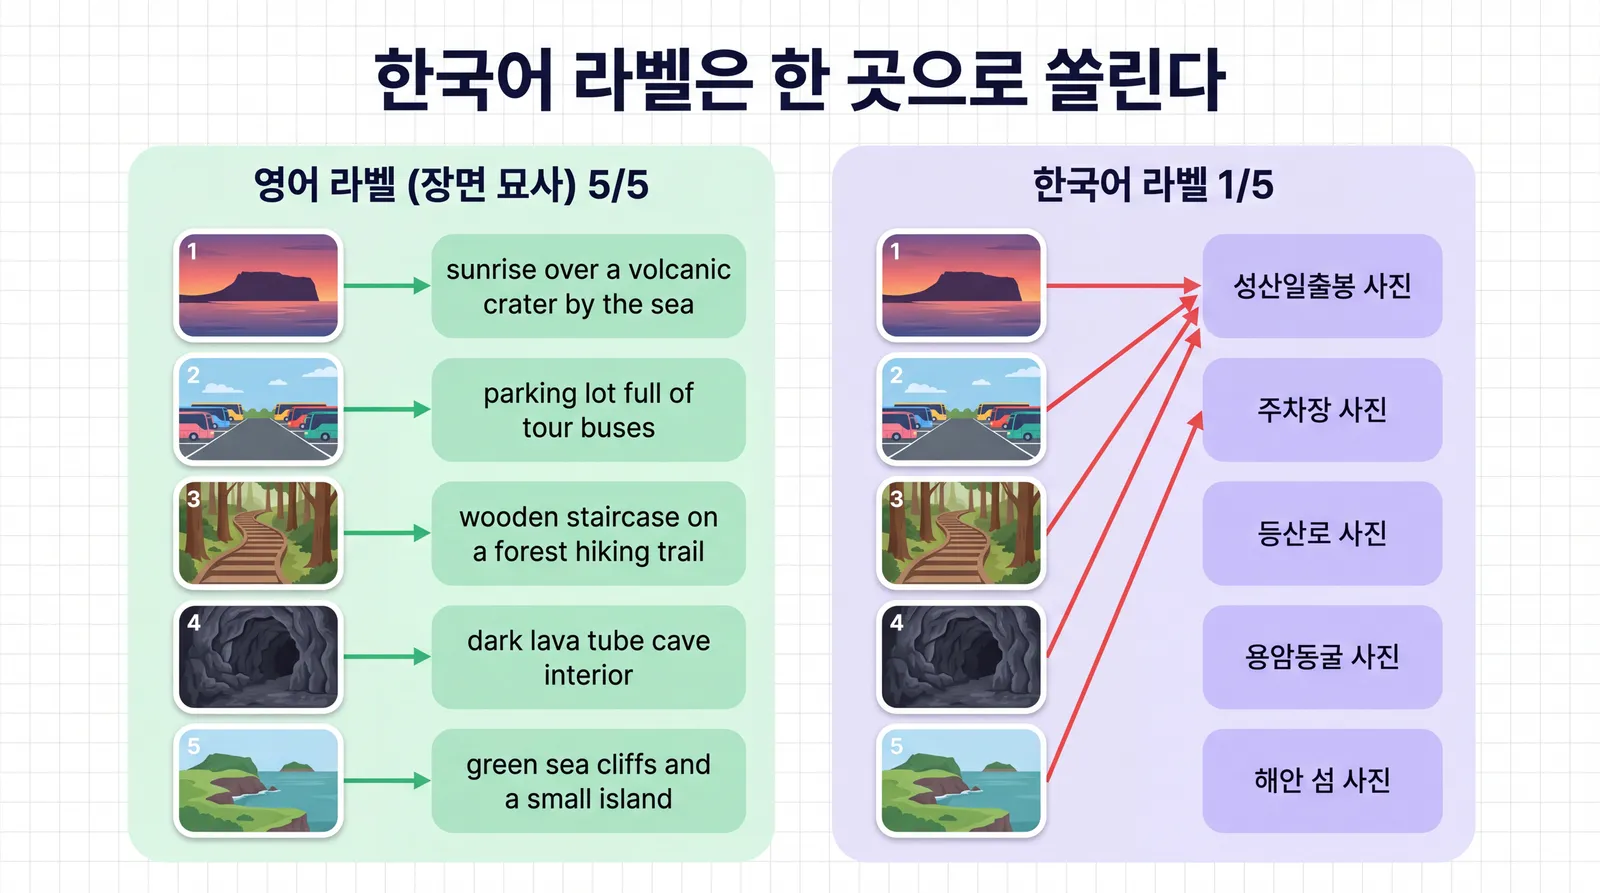
영어 짧은 라벨 (a photo of a sunrise peak 등) | 4/5 | 성산 일출봉만 해안 섬으로 틀림 (0.266 대 0.274) |
영어 장면 묘사 (a photo of a dark lava tube cave interior 등) | 5/5 | 정답 칸과 다른 칸의 차이도 평균적으로 가장 크다 |
한국어 (성산일출봉 사진 등) | 1/5 | 사진 4장이 모두 첫 라벨 “성산일출봉 사진”으로 쏠림. 값의 폭도 0.19~0.24로 좁다 |
한국어 + 영어 괄호 (주차장 (parking lot) photo 등) | 4/5 | 틀린 사진까지 영어 짧은 라벨과 같다 |
- 한국어 라벨의 1/5는 “한 장은 맞혔다”가 아니다. 다섯 한국어 라벨의 벡터가 서로 거의 구별되지 않아서, 사진마다 다섯 값의 차이가 0.015
0.031뿐이다(영어 짧은 라벨은 0.0770.132). 네 사진에서는 첫 라벨 “성산일출봉 사진”이 근소하게 앞섰지만, 우도는 “주차장 사진”(0.215)이 “성산일출봉 사진”(0.210)보다 높았다. 첫 사진만 정답 라벨과 일치하므로 1/5이며, 모든 사진이 같은 라벨을 고른 것은 아니다 - 한국어에 영어를 괄호로 붙이면 4/5로 돌아오고, 틀리는 사진까지 영어 라벨과 똑같다. 결과를 움직인 것은 영어 조각이다
○ 한국어 라벨은 왜 무너지는가 - 토큰과 데이터
- 먼저 토큰을 본다. CLIP의 토크나이저는 바이트 단위 BPE라서 어휘에 한글 글자가 거의 없다. 한글 한 글자는 UTF-8로 3바이트이고, 보통 1~2개 조각으로 잘린다
'성' -> 조각 2개'성산일출봉 사진' -> 조각 12개'a photo of a sunrise peak' -> 조각 6개-
시작·끝 특수 토큰 2개를 뺀 수다. 노트북 1-5는 특수 토큰을 포함해 14개, 8개로 출력한다
-
조각이 많아도 토큰 자체는 만들어진다. 그러니 원인이 “토큰화 실패”는 아니다. 다만 CLIP은 한 문장에 77토큰까지만 받으므로, 긴 한국어 문장은 같은 뜻의 영어보다 이 한도에 훨씬 빨리 닿는다
-
핵심 원인은 학습 데이터다. 앞에서 본 대로 4억 쌍은 영어 검색어로 모았다. 한국어 조각들이 사진 내용과 짝지어져 학습된 일이 드물었으니, 한국어 라벨들의 벡터는 뜻이 달라도 서로 비슷한 곳에 몰려 있다. 사진 벡터와의 유사도가 라벨마다 거의 같게 나오고, 그 결과가 “한 라벨로 쏠림”이다
-
운영 교훈은 이렇다. 제로샷 성능은 모델 크기만으로 정해지지 않는다. 라벨의 언어와 학습 데이터의 겹침이 함께 정한다. 한국어 서비스라도 CLIP 계열에 넣는 라벨은 영어로 쓰거나 영어를 병기하는 것이 안전하다. 한국어를 제대로 쓰려면 한국어가 들어간 데이터로 학습된 모델을 골라야 한다
□ 정렬이 깨질 때 나타나는 오류 양상
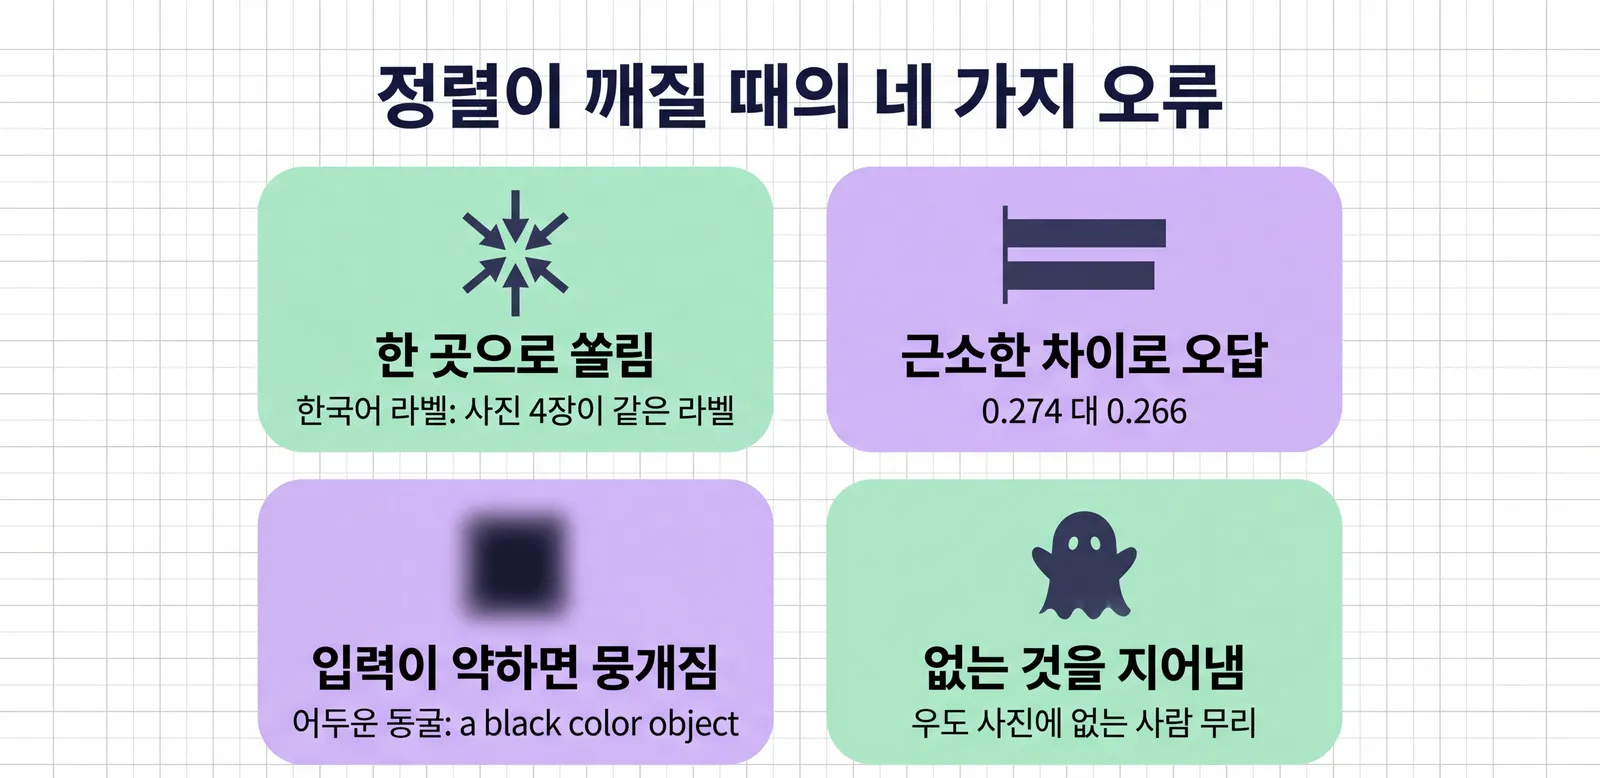
- 수업계획서의 [이론] 과제는 “정렬이 깨질 때 나타나는 오류 양상”이다. 이번 주 실측에서 나온 것을 네 가지로 묶는다
| 양상 | 무엇이 보이나 | 이번 주 실측 |
|---|---|---|
| 한 곳으로 쏠림 | 사진이 달라도 같은 답 | 한국어 라벨: 사진 4장이 “성산일출봉 사진” |
| 근소한 차이로 오답 | 비슷한 두 개념 중 틀린 쪽 | 성산 일출봉: sunrise peak 0.266, coastal island 0.274 |
| 입력이 약할 때 뭉개짐 | 세부가 없는 답 | 만장굴(어두운 용암 벽면): “a black color object” |
| 없는 것을 지어냄 | 사진에 없는 대상이 답에 등장 | 우도 해안 사진에 “a group of people” (사진에서 사람 무리는 보이지 않는다) |
- 넷 모두 모델은 “모르겠다” 없이 답을 낸다. CLIP은 차이가 0.001이어도 가장 큰 값을 고르고, VLM은 사진이 약해도 문장을 만든다. 5주차에서 본 대로 그럴듯함과 정확함은 다르다. 멀티모달이라고 이 구조가 사라지지 않는다
□ 사진과 글이 만나는 세 자리 - CLIP, Flamingo, LLaVA
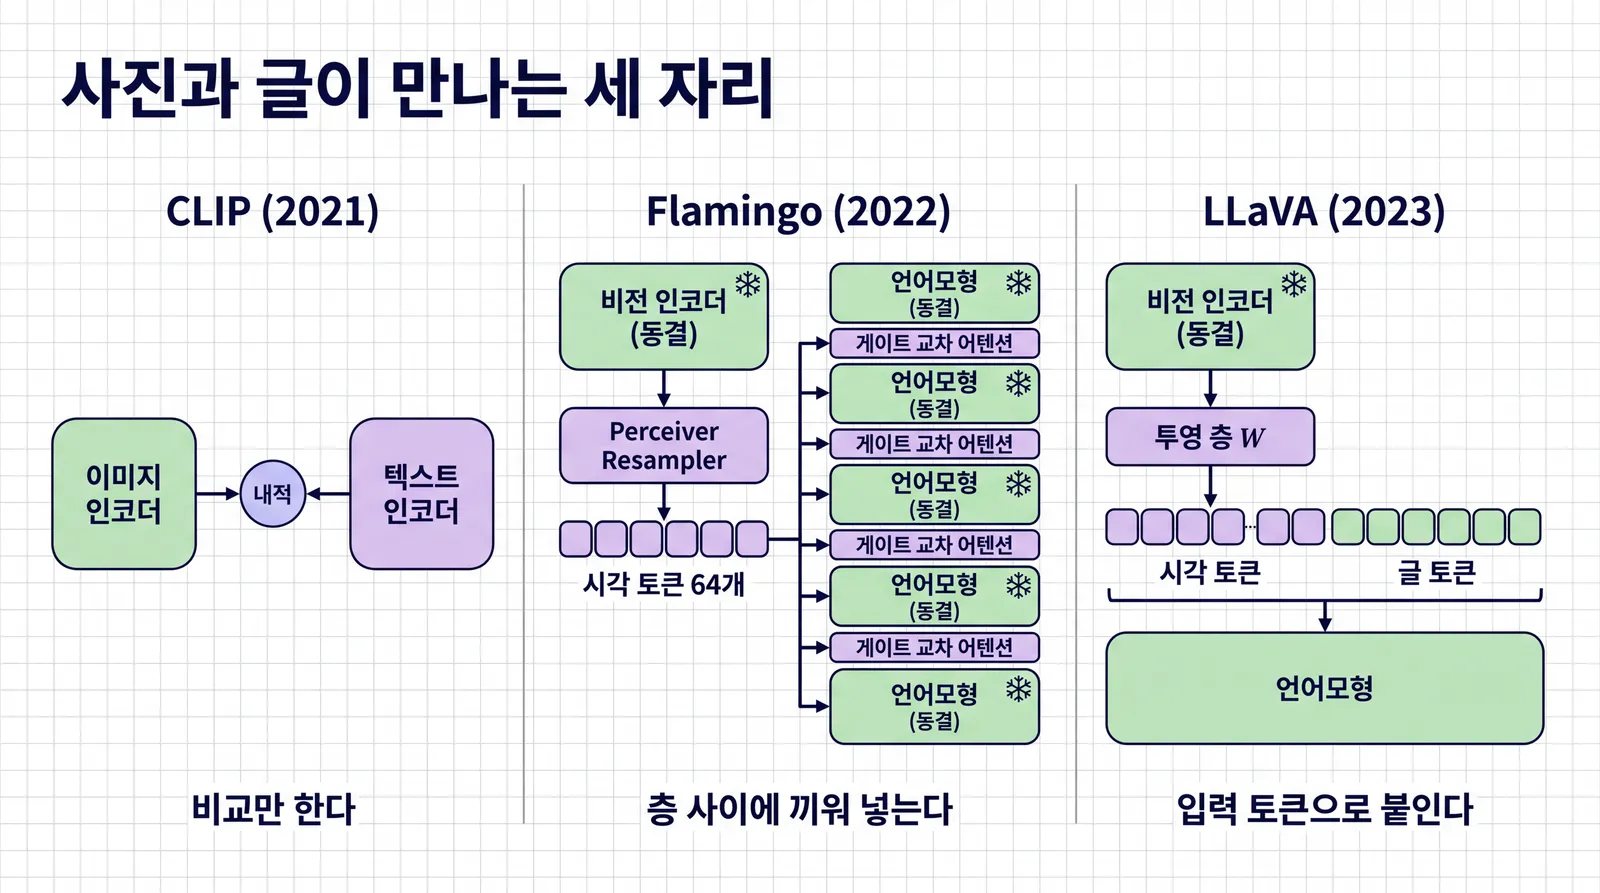
- 읽기 자료의 세 논문은 사진과 글이 모델 안의 어디에서 만나는가가 다르다. CLIP에는 언어모형이 없고 두 인코더가 마지막 내적에서만 만난다. 질문에 문장으로 답하려면 사진을 언어모형에 연결해야 하고, Flamingo와 LLaVA가 그 두 가지 방식을 대표한다
| CLIP (2021) | Flamingo (2022) | LLaVA (2023) | |
|---|---|---|---|
| 사진과 글이 만나는 곳 | 마지막 벡터의 내적 | 언어모형 층 사이에 끼운 교차 어텐션 층 | 언어모형의 입력 토큰 자리 |
| 사진이 들어가는 모양 | 벡터 1개 | Perceiver Resampler가 만든 시각 토큰 64개 | 격자 특징을 투영한 시각 토큰 여러 개 |
| 기존 모델 | 두 인코더를 처음부터 함께 학습 | 비전 인코더와 언어모형은 동결, 사이에 새 층만 학습 | 비전 인코더(CLIP ViT-L/14)는 동결, 투영 층과 언어모형을 학습 |
| 할 수 있는 일 | 비교, 검색, 제로샷 분류 | 사진과 글이 섞인 문맥으로 몇 개 예시만 보고 답하기 | 사진을 보고 지시에 따라 대화하기 |
- Flamingo는 이미 학습된 비전 인코더와 큰 언어모형을 얼려 두고, 그 사이에 새 층을 끼운다
- Perceiver Resampler: 사진 크기와 상관없이 시각 토큰 64개로 요약한다
- 언어모형의 층 사이에 새 교차 어텐션 층(GATED XATTN-DENSE)을 넣는다. 글 토큰이 이 층에서 시각 토큰을 참고한다
- 새 층의 출력에는 tanh(α)를 곱하고 α를 0에서 시작한다. 그래서 학습 초기에는 새 층이 아무 영향을 주지 않고 원래 언어모형과 똑같이 동작한다. 기존 언어 능력을 해치지 않으려는 장치다
- 사진과 글이 섞인 웹 문서로 학습해, 예시 몇 개를 문맥에 넣으면 새 과제를 푸는 소수 예시(few-shot) 능력을 보였다. 4주차 문맥학습의 멀티모달판이다
- LLaVA는 더 단순하다
- CLIP의 비전 인코더(ViT-L/14)가 만든 격자 특징에 학습되는 투영 행렬 W(선형 층)를 곱해 언어모형의 단어 임베딩과 같은 공간으로 옮긴다. 이것이 시각 토큰이다
- 시각 토큰을 글 토큰 앞에 붙여 언어모형(Vicuna)에 넣으면, 언어모형은 이를 “사진에 대한 단어들”처럼 읽고 답을 이어 쓴다
- 학습은 두 단계다. 1단계는 CC3M에서 거른 59.5만 쌍으로 W만 학습해 사진 특징을 단어 공간에 맞춘다. 2단계는 15.8만 개의 지시 따르기 데이터로 W와 언어모형을 함께 미세조정한다. 비전 인코더는 끝까지 얼려 둔다
- 이번 주 실습의 SmolVLM은 LLaVA 쪽 방식이다. 시각 특징을 줄이고 투영해 언어모형 입력 토큰 자리에 넣는다. 그래서 “사진 1장이 몇 토큰인가”가 곧 비용 문제가 된다
□ SmolVLM - 사진을 토큰으로 바꿔 답하게 하기
- SmolVLM-256M-Instruct는 파라미터 2억 5,648만 개의 경량 VLM이다. 모델 내부 구조는 이번 주 범위 밖이므로, 시각 토큰 수를 계산하는 데 필요한 설정만 본다
- 비전 인코더: SigLIP 계열, 16픽셀 패치, 입력 512x512
- 픽셀 셔플 배율 4 (scale_factor 4)
- SigLIP은 CLIP의 친척이다. 배치 전체에 소프트맥스를 씌우는 대신, 표의 각 칸을 “짝인가 아닌가”의 시그모이드로 따로 판정해 학습한다(Zhai 외, 2023, arXiv:2303.15343)
- 답의 형태는 채팅 템플릿으로 만든다. 사진 자리에 표시자를 둔 대화 형식 프롬프트를 조립하고, 프로세서가 그 표시자를 시각 토큰들로 바꾼다. 4주차의 프롬프트 조립이 그대로 이어진다
○ 시각 토큰 832개는 어떻게 나오나
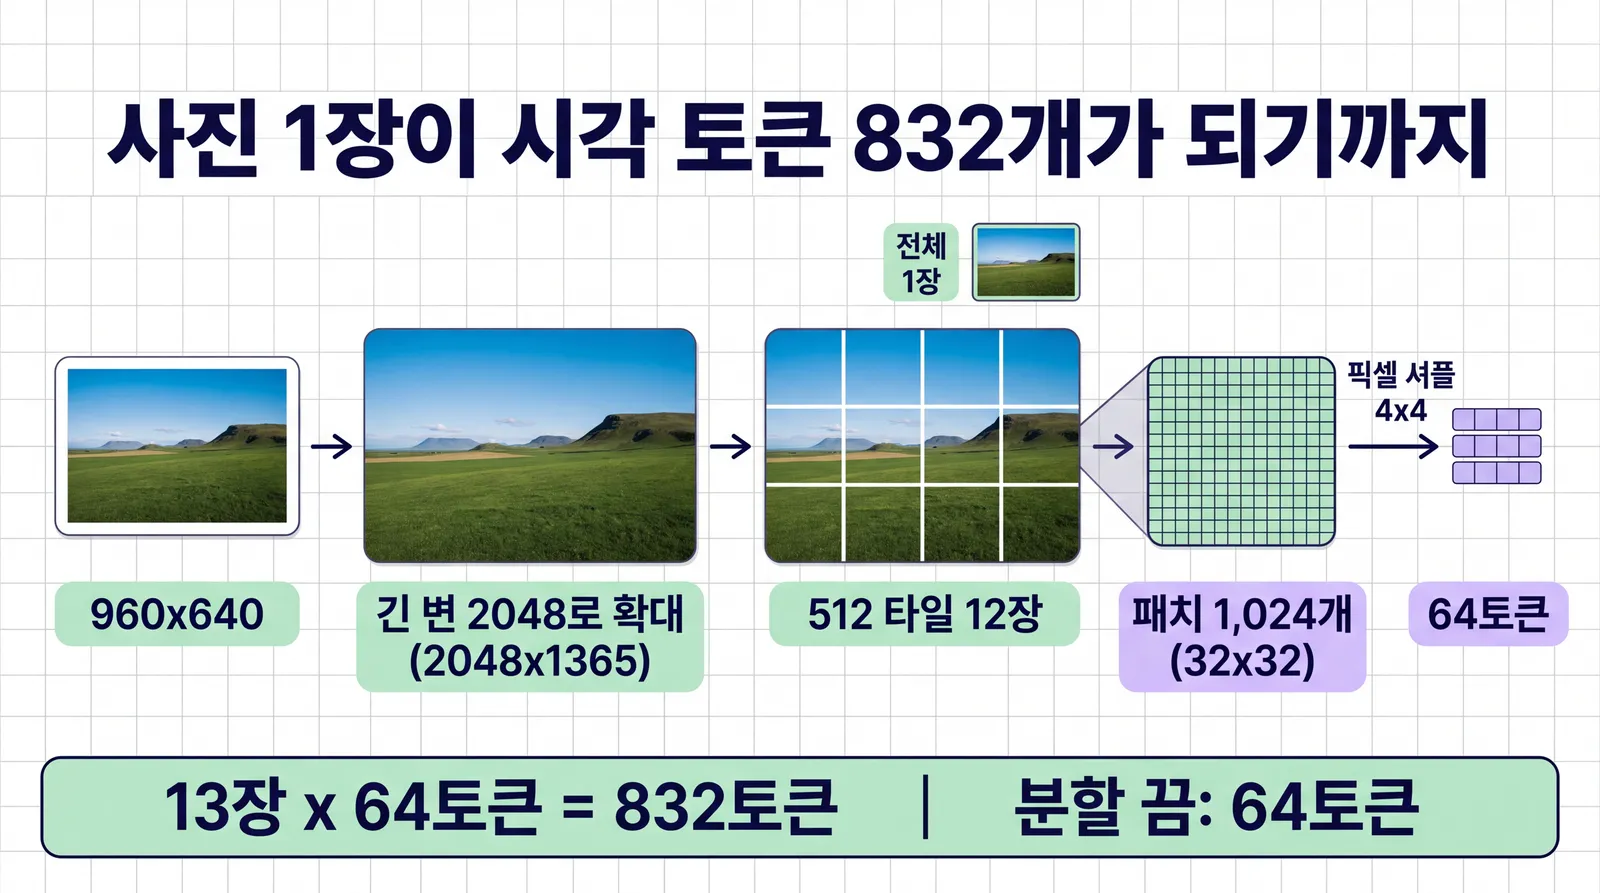
- 사진 1장이 문맥에서 몇 토큰이 되는지는 프로세서의 타일 분할 설정이 정한다. 분할을 켜면(모델 기본값) 이렇게 계산된다
- 사진의 긴 변을 2048픽셀로 키운다. 960x640 사진은 2048x1365가 된다
- 각 변을 512의 배수로 올려 맞춘다. 세로 1365는 1536이 된다
- 512x512 타일로 자른다. 가로 4칸 x 세로 3칸 = 12장. 여기에 전체 사진을 512로 줄인 1장을 더한다
- 타일 1장은 16픽셀 패치 32x32 = 1,024개로 읽힌다. 픽셀 셔플이 이웃한 4x4 = 16개를 하나로 묶어 64토큰이 된다
- 13장 x 64 = 832토큰
- 분할을 끄면 전체 사진 1장만 넣으므로 64토큰이다
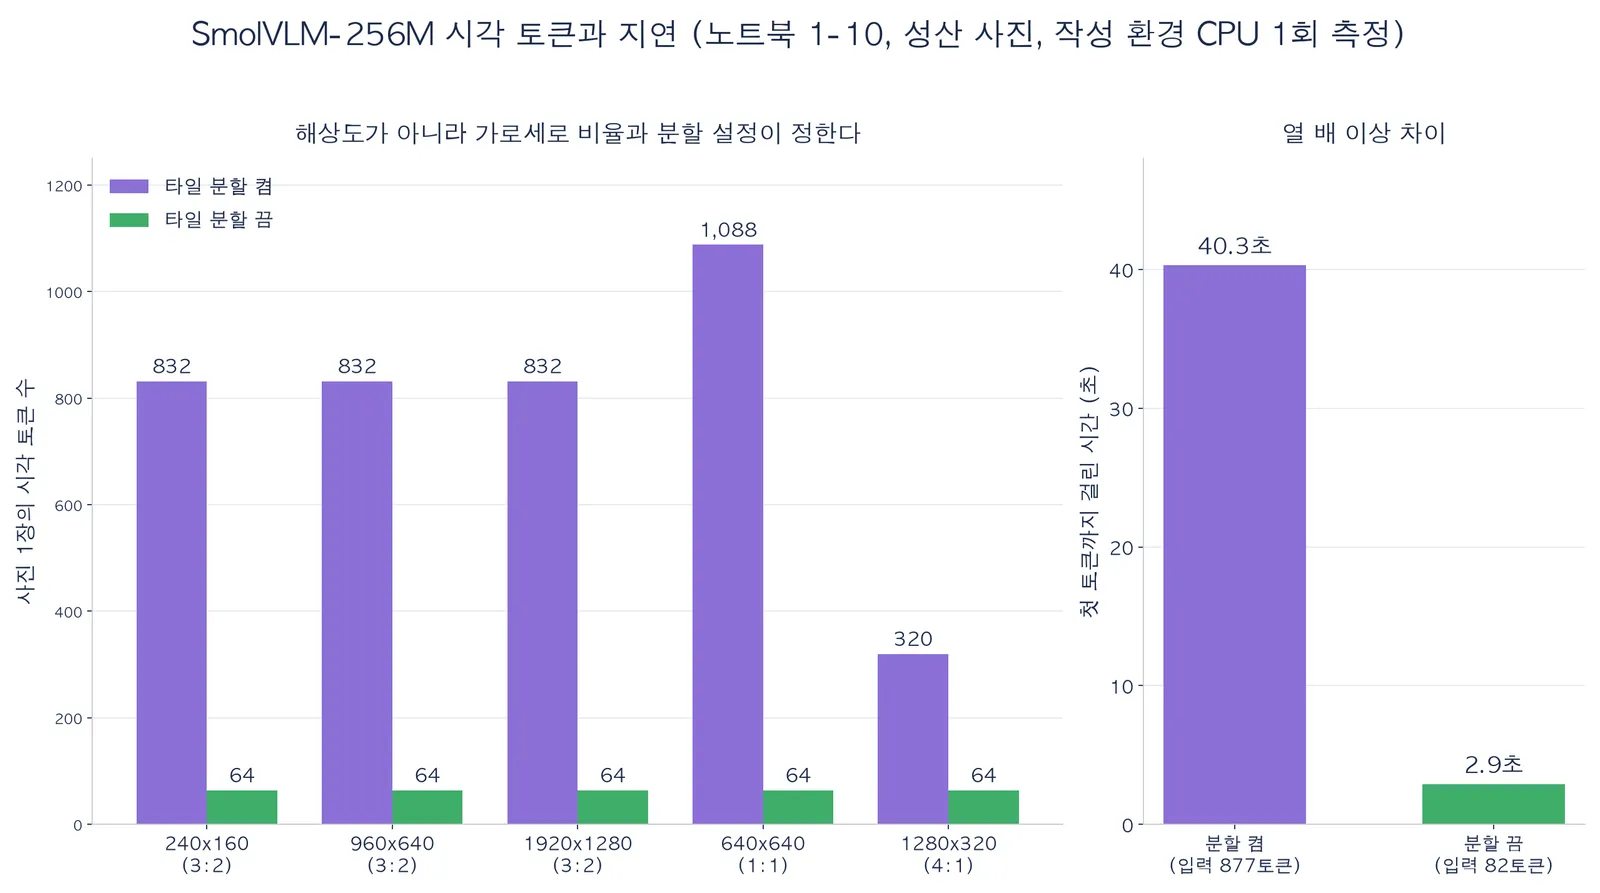
- 여기서 중요한 사실이 나온다. 이 모델에서 시각 토큰 수는 해상도가 아니라 가로세로 비율이 정한다. 긴 변을 항상 2048로 맞추기 때문이다. 노트북 1-10의 실측이다
| 사진 크기 | 분할 켬 | 분할 끔 |
|---|---|---|
| 240x160 (3:2) | 832 | 64 |
| 960x640 (3:2) | 832 | 64 |
| 1920x1280 (3:2) | 832 | 64 |
| 640x640 (1:1) | 1,088 (타일 16 + 1) | 64 |
| 1280x320 (4:1) | 320 (타일 4 + 1) | 64 |
- 작은 사진을 넣어도 토큰이 줄지 않는다. 오히려 240x160 사진은 2048까지 키워지므로 없는 세부를 늘려 읽는 셈이다. 비용을 줄이는 손잡이는 해상도가 아니라 분할 설정이다
- 비용 차이도 쟀다. 성산 사진 1장에 1-10의 질문을 넣고 첫 토큰이 나오기까지 걸린 시간이다(작성 환경의 CPU, 1회 측정. 다시 재면 분할 켬이 38.2초로 나오는 등 몇 초씩 달라진다)
| 설정 | 입력 토큰 | 첫 토큰까지 |
|---|---|---|
| 분할 켬 | 877 | 40.3초 |
| 분할 끔 | 82 | 2.9초 |
- 열 배 이상 차이 난다. 비전 인코더가 512 타일 13장을 읽고, 언어모형이 877토큰의 문맥을 처리하는 비용이다. 그래서 실습 노트북은 분할을 끄고 답을 생성한다. 분할을 켜면 세부를 더 보지만, CPU에서는 답 하나에 수십 초가 걸린다
□ 실측 대조 - 텍스트 전용 모델과 멀티모달 모델
○ 사진이 없으면 지어낸다
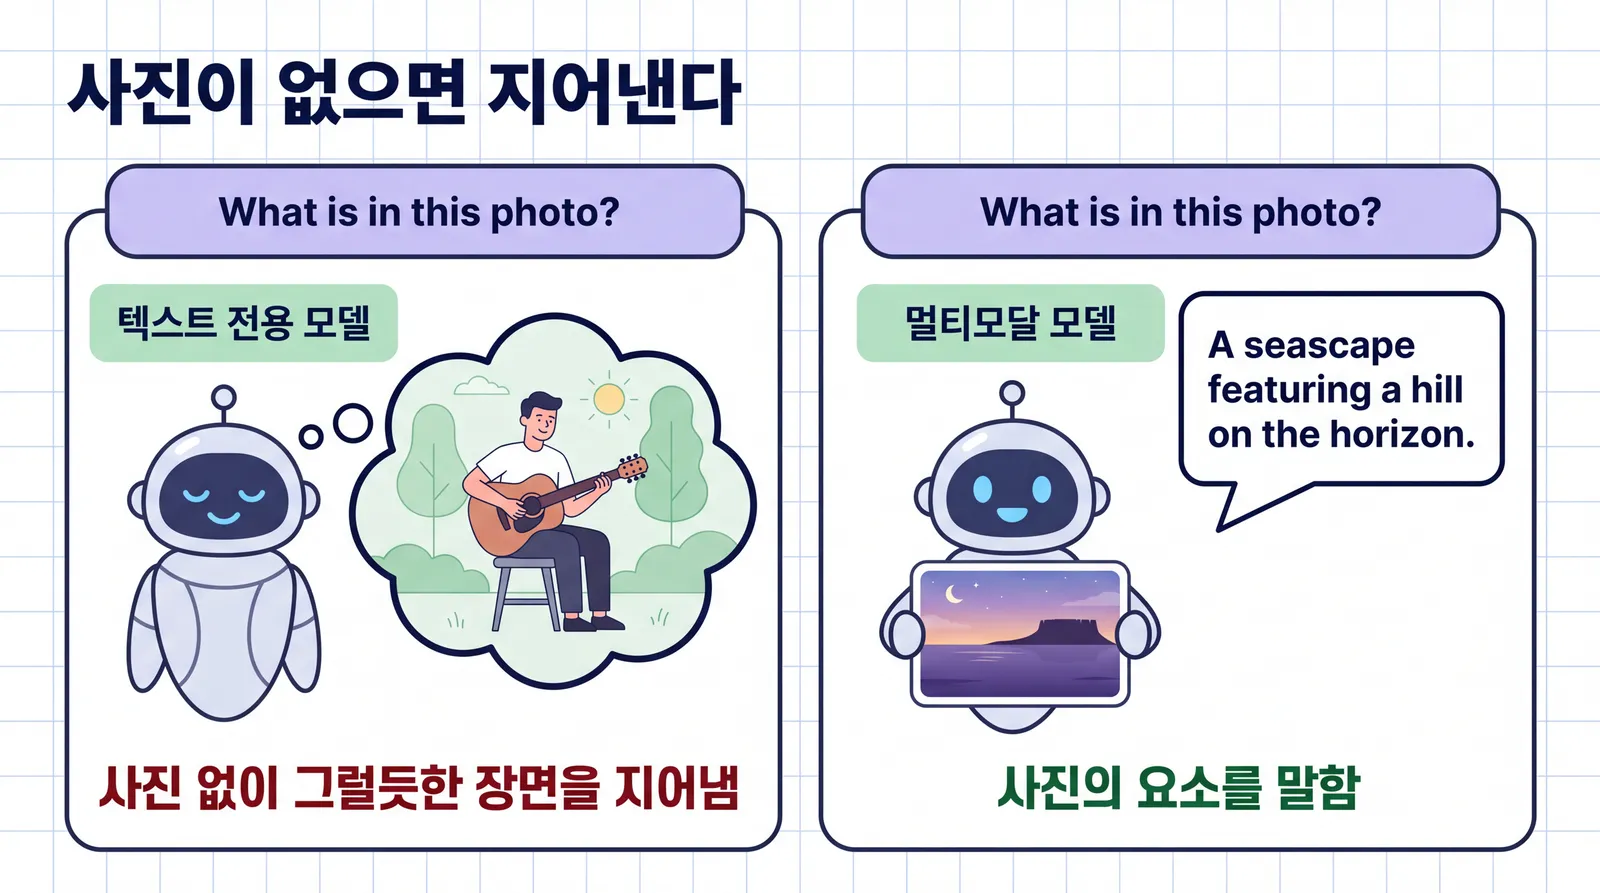
- 온라인 학습활동의 실험이다. 사진을 받을 수 없는 텍스트 전용 모델(Qwen3-0.6B-Base)과 SmolVLM(성산 일출봉 사진)에 같은 질문을 줬다. 텍스트 전용 모델의 프롬프트는
Question: ...\nAnswer:다
| 질문 | 텍스트 전용 (사진 없음) | SmolVLM (성산 사진) |
|---|---|---|
| Describe this image in one sentence. | “The image depicts a serene landscape with lush greenery, a tranquil river, and a group of people engaged in a peaceful activity, likely fishing …” | “In this image we can see a hill. At the bottom of the image there is water. At the top of the image there is sky.” |
| What is in this photo? | “The answer is a man in a white shirt and a man in a black shirt. The man in the white shirt is a man who is playing a guitar. …” | “A seascape featuring a hill on the horizon.” |
| 사진 속에 나무가 몇 그루인가? | “사진 속에 나무가 몇 그루인가에 대한 답은 상황에 따라 달라질 수 있습니다. 일반적으로 나무의 수는 100~” | “Yes, it is a beautiful sunset. …” (개수에 답하지 않음) |
- 텍스트 전용 모델의 답은 문장이 자연스럽고 형식도 갖췄다. 그러나 사진을 본 적이 없으므로 강, 낚시하는 사람들, 기타 치는 남자는 전부 지어낸 것이다. 5주차의 false acceptance와 같은 뿌리다. 다음 토큰 확률 기계는 “그럴듯한 것”을 낼 뿐 “참인 것”을 보장하지 않는다
- SmolVLM의 답은 사진의 실제 요소(언덕, 물, 하늘)를 말한다. 사진이 문맥에 들어 있으니 지어낼 여지가 구조적으로 줄어든다. 다만 한국어 질문에는 개수를 답하지 못했다. 이 문제는 뒤에서 본다
○ 사진을 바꾸면 답이 따라 움직인다
- SmolVLM에 같은 질문(“Describe this image in one sentence.”)을 주고 사진만 다섯 장으로 바꿨다(분할 끔)
| 사진 | 답 (실측) | 사진과 대조 |
|---|---|---|
| 성산 일출봉 | ”… a hill. At the bottom of the image there is water. At the top of the image there is sky.” | 맞다 |
| 성산 주차장 | ”… a few vehicles on the road. In the background there is a mountain and the sky is clear.” | 맞다 (버스와 승용차, 뒤의 봉우리) |
| 영실 등산로 | ”… a bridge, trees, mountains and the sky.” | 대체로 맞다 (다리가 아니라 나무 계단길) |
| 만장굴 | ”… a black color object.” | 뭉개짐 (용암 벽면 근접 사진) |
| 우도 해안 | ”… a group of people, there are some trees, there is a water body, there is a hill, there is a clear sky …” | 사람 무리는 사진에서 보이지 않는다 |
- 질문은 고정이고 사진만 바꿨는데 답이 사진을 따라 바뀐다. 답이 사진에 근거(grounded)한다는 것의 실측 형태다. 학습활동 [구현]이 이 실험의 연습판이다
- 그러나 근거가 있다는 것과 답이 맞다는 것은 다르다. 만장굴에서는 뭉개졌고, 우도에서는 없는 사람들을 지어냈다. VLM의 답도 사진이라는 문맥 위에서 나온 다음 토큰 확률이다
○ 한국어 질문은 어떻게 깨지는가
- 같은 다섯 장에 한국어 질문 “이 이미지를 한 문장으로 묘사하라.”를 넣었다(분할 끔)
| 사진 | 답 (실측) |
|---|---|
| 성산 일출봉 | “The sunset over a body of water.” |
| 성산 주차장 | “The 2019-2020 season.” |
| 영실 등산로 | “The path is very wide and is made of wooden planks.” |
| 만장굴 | “The top of a car door.” |
| 우도 해안 | “The water is a beautiful blue.” |
- 관찰 세 가지다
- 답이 영어로 나온다. 질문의 언어가 답의 언어를 정하지 못한다
- 답이 사진에서 멀어진다. 같은 만장굴 사진에 영어로 물으면 “black color object”로 뭉개질 뿐이지만, 한국어로 물으면 “자동차 문”이 된다. 주차장은 “2019-2020 시즌”이라는 엉뚱한 답이 나왔다
- 두 번째 질문 “여기가 어디인가? 주된 피사체가 무엇인가?”를 성산 사진에 넣으면 “어디에서 이미지를 이벤트로보기를 해”처럼 깨진 한글이 나온다
- 원인은 CLIP과 같은 방향이다. 256M 모델의 지시 학습 데이터는 영어 위주라, 한국어 지시 뒤에 올 다음 토큰의 확률이 무너진다. 모델 크기만의 문제가 아니라 데이터 분포의 문제다. 5주차의 “지표가 놓치는 것”처럼, 영어로 잰 성능은 한국어 사용 환경의 성능을 말해 주지 않는다
□ 이미지가 문맥을 잠식한다 - 7주차로 가는 다리
- 분할을 켜면 입력 877토큰(1-10 질문 기준. 1-6은 질문이 짧아 874토큰) 중 성산 사진이 832토큰이고, 나머지 45토큰이 타일 위치 표시와 질문, 템플릿이다. 입력의 95%가 사진이다
- 사진을 여러 장 넣으면 문맥 창이 금방 찬다
- 문맥이 길수록 처리 시간과 비용이 늘어난다(앞의 약 40초 대 약 3초)
- 문맥 창이 작은 모델일수록 사진 몇 장으로 한도에 닿는다
- 7주차(장문맥)에서 긴 문맥의 효율과 “중간에 있는 정보를 놓치는” 문제를 본다. 이미지는 그 문제가 가장 먼저 나타나는 곳이다. 학습활동 [실무]의 지연·비용 보고가 이 관찰을 근거로 한다
- 텍스트 전용 모델(Qwen3-0.6B-Base 같은 작은 모델)과 멀티모달 모델(SmolVLM)에 같은 질문을 준다. 질문은 사진을 보고 답해야 하는 것이어야 한다(예: “이 사진에는 무엇이 있나요?”, “사진 속 하늘 상태는 어떤가?”)
- 두 모델의 답을 나란히 놓고 답이 사진을 따라 바뀌는지를 기록한다. 텍스트 전용 모델의 답은 사진 없이도 얼마든지 나오므로, “그럴듯하지만 근거가 없다”가 실측으로 드러나는지 확인한다
- 한국어 질문과 영어 질문을 각각 넣어 답의 언어와 질이 어떻게 달라지는지도 함께 기록한다
- 실습 노트북 1-7 ~ 1-9가 이 활동의 연습판이다
대면 (1시수)
Section titled “대면 (1시수)”경량 멀티모달 모델 동작 분석 - 두 구조의 깨지는 지점을 직접 읽는다
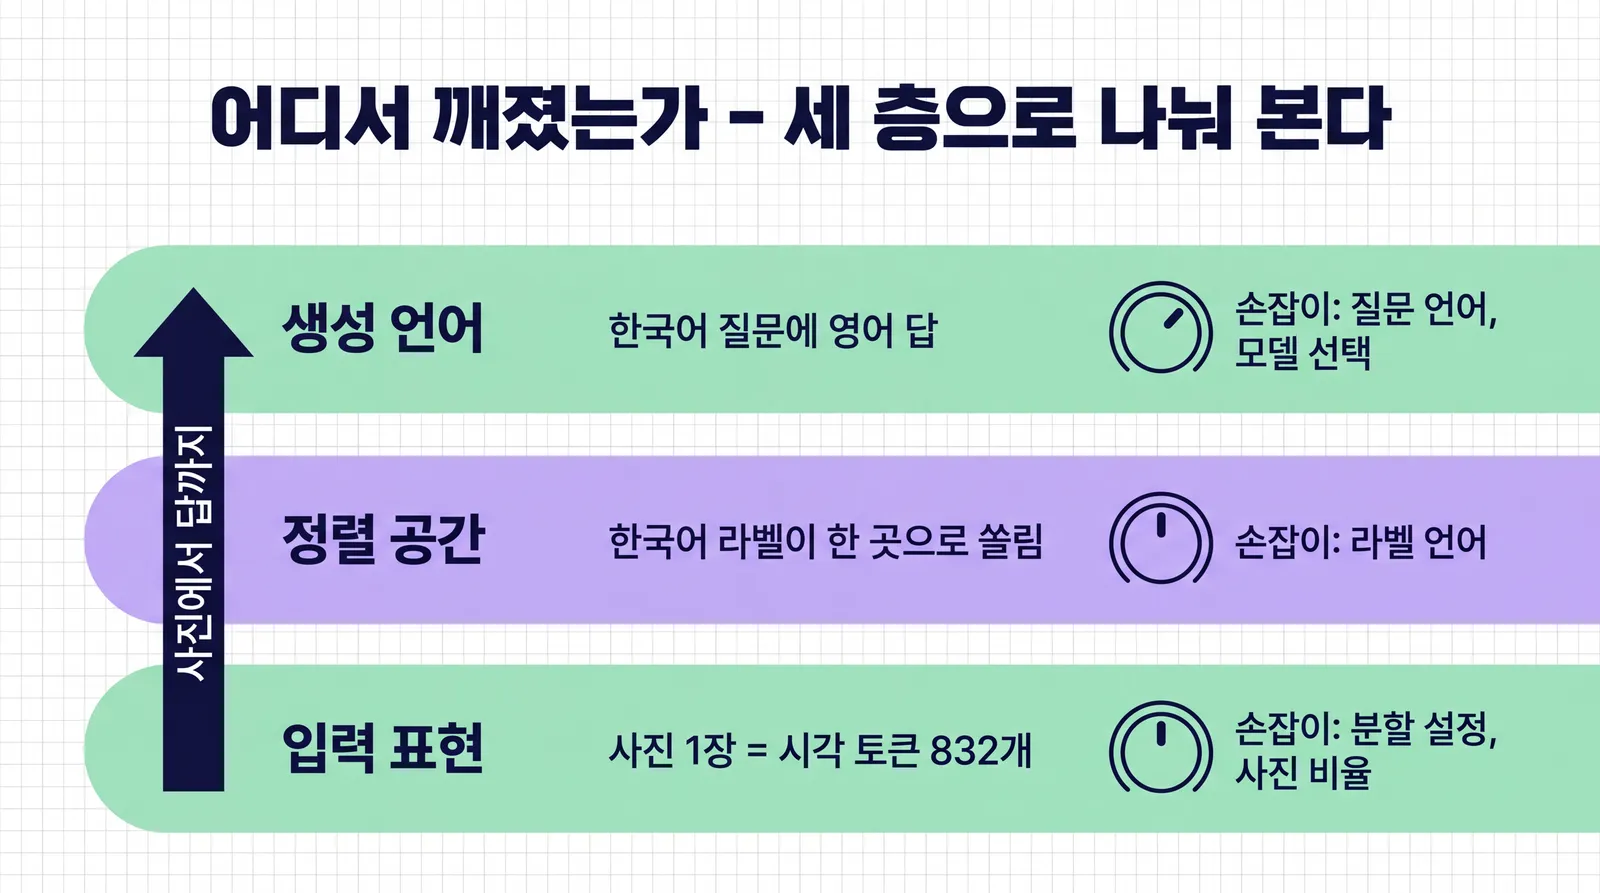
Section titled “경량 멀티모달 모델 동작 분석 - 두 구조의 깨지는 지점을 직접 읽는다”□ 분석 관점 - 어디가 깨졌는가를 세 층으로 나눠 본다
- 온라인의 실측 결과를 대면에서 세 층으로 분해한다
| 층 | 보는 것 | 실측 예 |
|---|---|---|
| 입력 표현 | 사진이 몇 개의 시각 토큰이 되는가, 무엇이 그 수를 정하는가 | 3:2 사진은 크기와 상관없이 832토큰(분할 켬), 64토큰(분할 끔) |
| 정렬 공간 | 라벨 언어와 제로샷 정확도의 관계 | 영어 장면 라벨 5/5, 한국어 1/5 (한 라벨로 쏠림) |
| 생성 언어 | 질문 언어와 답의 언어·질의 관계 | 한국어 질문 -> 영어 답, 사진에서 먼 답, 깨진 한글 |
- 세 층 모두 “모델이 나쁘다”가 아니라 **“어느 층에서 어떻게 깨지는가”**를 찾는 것이다. 깨진 층을 못 박아야 고칠 방법이 정해진다. 입력 표현이 문제면 분할 설정이나 사진 비율을, 정렬 공간이 문제면 라벨 언어를, 생성 언어가 문제면 질문 언어나 모델 선택을 바꾼다
○ 층별 분석 연습 - 실측 기록을 근거로 쓰는 훈련
- 분석 기록의 형식은 5주차 Q4 근거 기준을 이어받는다. 예시는 이렇다
관찰: 한국어 라벨로 제로샷 분류했더니 5장 중 1장만 맞았다. 사진 4장이 모두 "성산일출봉 사진"을 골랐다.근거: CLIP ViT-B/32, 제주 공개 사진 5장, 라벨 "OO 사진" 형식 5개, 노트북 1-4 실측 (유사도 행렬과 사진별 선택 라벨)해석: 토큰은 만들어진다('성' 한 글자가 BPE 조각 2개). 그러나 학습 데이터를 영어 검색어로 모아 한국어 조각이 사진 방향과 짝지어진 적이 드물다. -> 모델 결함이 아니라 정렬 공간의 언어 편향다음: 라벨을 영어 장면 묘사로 바꿔 같은 실험을 다시 돌린다 (실측 5/5). 한국어 + 영어 괄호 형식은 4/5로, 틀리는 사진까지 영어 짧은 라벨과 같다.- 관찰 - 근거 - 해석 - 다음의 네 칸을 비우지 않는다. 이 형식이 과제 2 보고의 뼈대다
□ 두 구조의 선택 기준 - 비교형과 생성형은 언제 갈리는가
| 기준 | 이중 인코더 (CLIP) | 인코더 + 언어모형 (VLM) |
|---|---|---|
| 답의 형태 | 라벨이나 순위 (비교) | 자유 서술 (생성) |
| 속도 | 문장 후보를 미리 인코딩해 두면 매우 빠르다 | 사진마다 인코딩과 생성 시간이 든다 |
| 문맥 비용 | 사진 1장당 벡터 1개 | 사진 1장당 64~1,088토큰 (분할 설정과 비율에 따라) |
| 실패 모양 | 정렬이 안 된 라벨에서 한 곳으로 쏠림, 근소한 차이의 오답 | 그럴듯한 오답, 없는 것 지어내기, 깨진 언어 |
| 잘 맞는 일 | 검색, 필터링, 자동 분류 | 질의응답, 설명 생성, 안내 |
- 같은 입력(사진 + 질문)이라도 요구가 “분류”면 CLIP 쪽이 싸고 빠르다. 요구가 “설명”이면 VLM이 필요하다. 구조 선택은 성능 이전에 과제의 답 형태가 정한다
○ 모달리티가 늘어나는 방향 - 수업계획서의 경량 모델들
- 수업계획서는 대면 분석 대상으로 SmolVLM2와 Qwen 2.5 Omni 등을 예로 든다. 이번 주 실습은 CPU에서 가장 가볍게 도는 SmolVLM-256M으로 분석하고, 두 모델은 입력 모달리티가 어떻게 늘어나는지의 예로 본다
- SmolVLM2: SmolVLM의 후속으로, 사진에 더해 동영상을 받는다. 동영상은 여러 장의 사진(프레임)이므로 시각 토큰 문제가 프레임 수만큼 커진다
- Qwen2.5-Omni (arXiv:2503.20215): 텍스트, 사진, 음성, 동영상을 받아 텍스트와 음성으로 답하는 모델이다. 모달리티가 늘수록 “어느 층에서 깨지는가”의 층도 늘어난다
○ 대면 실습 - 노트북의 숫자를 손으로 검산
- 노트북의 CLIP 유사도에서 두 곳을 손으로 계산한다
- 성산 일출봉 행, 영어 짧은 라벨(노트북 1-3 출력): cos 0.266(sunrise peak)과 0.274(coastal island). logit_scale 100을 곱하면 로짓 차이는 얼마이고, 두 라벨의 확률 비는 대략 얼마인가 (e^0.8)
- 한국어 라벨 행렬(노트북 1-4 히트맵): 사진 다섯 장의 행마다 가장 큰 값이 어느 열에 있는가. 1/5라는 숫자가 “한 장은 맞혔다”로 읽히면 안 되는 이유를 말로 설명한다
- SmolVLM의 시각 토큰 수를 손으로 계산한다
- 640x640 사진: 긴 변 2048로 키우면 2048x2048, 512 타일로 몇 장인가, 전체 사진 1장을 더하면 모두 몇 토큰인가 (노트북 1-10과 대조)
- 1280x320 사진은 어떤가. 같은 픽셀 수라도 비율이 토큰을 정한다는 것을 확인한다
[이론] 서로 다른 모달리티를 하나의 표현 공간에 정렬하는 원리를 정리한다. 두 인코더의 출력을 같은 차원으로 투영하고 정규화해 내적하는 것, 짝이 맞는 쌍은 가깝게 하고 배치 안의 나머지는 멀게 하는 대조 학습, 그리고 정렬이 깨질 때 나타나는 오류 양상(한 곳으로 쏠림, 근소한 차이의 오답, 뭉개짐, 지어내기)을 실측 표와 함께 쓴다
[구현] 노트북의 QA 예제를 받아 실행하고 입력 이미지를 바꿔(노트북의 TODO 한 곳) 답이 어떻게 달라지는지 확인한다. 답이 사진 내용을 따라 바뀌는지, 사진이 약할 때(어두운 사진 등) 답이 어떻게 무너지는지, 사진에 없는 것을 지어내지는 않는지를 기록한다
[실무] 과제 2 - 제공된 QA 골격에 모달리티 하나를 연결한다. 해양·환경 관측 기록을 다루는 도내 기업의 조건을 상정해(기업 데이터는 사용하지 않음) 모달리티 추가가 지연·비용에 미치는 영향을 함께 보고한다(3단계 부분점수 적용)
- 연결할 모달리티의 예: 관측 장비 사진, 기록 원문 스캔본, 관측 지점 지도
- 보고에 들어갈 항목: 시각 토큰 수(비율과 분할 설정별), 첫 토큰까지 시간, 문맥 창 점유율, 그리고 “이미지가 문맥을 잠식”하는 지점
- 해상도를 바꾸는 것만으로는 토큰이 줄지 않을 수 있다(이번 주 실측). 무엇이 토큰 수를 정하는지를 먼저 확인하고 비용을 설계한다
- 기업 데이터는 가져오지 않는다. 조건 상정이며 실제 데이터 확보는 범위 밖이다
□ 과제 2 따라 하기 체크리스트
- 골격은 실습 노트북 2절의 TODO 셀이다. 고칠 곳은
MY_IMAGE한 줄이고, 셀 끝의 [비용] 출력이 보고 표의 숫자다 - 1단계, 조건 적기: “관측 사진을 받는 CPU 서버 1대, 전용 GPU 없음, 사진 1장당 첫 응답 5초 이내”처럼 상정한 기업의 조건을 첫 줄에 쓴다 (예시 조건이며, 각자 정한다)
- 2단계, 모달리티 고르기: 관측 장비 사진, 기록 원문 스캔본, 관측 지점 지도 중 하나를 고르고, 그것을 대신할 공개 사진 1장을 준비한다
- 위키미디어 공용이나 공공누리처럼 라이선스가 확인되는 곳에서 고르고, 제목·저자·출처 주소·라이선스를 보고에 적는다
- 사람 얼굴이나 개인정보가 보이는 사진은 쓰지 않는다. 이 저장소는 공개다
- 알맞은 사진을 찾지 못하면 노트북의 제주 사진 5장 중 하나로 대신한다. 이 과제의 핵심은 비용을 재고 해석하는 방법이다
- 3단계, 골격에 연결: 고른 사진을 jpg, png, webp 파일로 Colab 왼쪽 파일 창의
week06-imgs/폴더에 올리고,MY_IMAGE를 파일 이름(확장자 제외)으로 바꿔 2절 셀을 실행한다- 지도(svg)나 스캔본(pdf)은 노트북이 읽지 못한다. 위키미디어 공용 파일 페이지의 다른 해상도 링크에서 png나 jpg로 받아 올린다. 공공누리 자료처럼 pdf로만 받을 수 있으면 해당 쪽을 화면 캡처해 png로 올린다
- 4단계, 숫자 옮기기: [비용] 출력의 세 줄을 아래 표에 옮긴다. 분할 켬의 첫 토큰 시간은 셀에서 재지 않으므로(CPU에서 수십 초) 노트북 1-10의 값을 참고값으로 쓰고, 고른 사진의 입력 토큰 수가 1-10과 다르면 그 차이를 함께 적는다
- 5단계, 잠식 지점 해석: 시각 토큰이 문맥 창의 몇 %인지에서 “사진 몇 장이면 문맥 창이 차는가”를 계산하고, 1단계 조건 안에서 분할 설정을 무엇으로 할지 근거를 쓴다
- 6단계, 보고 형식: 대면 시간의 관찰 - 근거 - 해석 - 다음 네 칸으로 쓴다
- 채점은 “가장 빠른 설정”이 아니라 조건과 선택 근거가 숫자로 연결되는가를 본다. 3단계 부분점수는 수업계획서의 중간 단계 부분점수 표를 따른다
| 입력 | 입력 토큰 | 시각 토큰 | 문맥 창 대비 시각 토큰 | 첫 토큰까지 |
|---|---|---|---|---|
| 질문만 (사진 없음) | 0 | 0% | ||
| 사진 + 질문 (분할 끔) | ||||
| 사진 + 질문 (분할 켬) | 1-10 참고값 |
- 제출: 실습 노트북과 함께
assignments/week-06/<학번>/에 올린다. 표와 보고는 노트북 4절의 답 칸에 글로 적어도 된다
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. 멀티모달 모델은 텍스트 전용 모델보다 “똑똑한” 것 아닌가?
능력의 종류가 다르지 우열이 아니다. 사진을 보고 답하는 일은 텍스트 전용 모델이 구조적으로 못 한다(문맥에 사진이 없으니 지어낼 뿐이다). 반대로 순수 텍스트 과제에서는 멀티모달 모델이 이미지에 쓴 용량만큼 손해 볼 수 있다. 과제의 입력과 답 형태가 구조를 정한다.
Q2. CLIP이 한국어 라벨을 틀리는 것은 한국어를 “몰라서” 아닌가?
부분적으로만 맞다. 한국어 라벨도 토큰으로 만들어진다(‘성’ 한 글자가 BPE 조각 2개). 문제는 그 조각들이 사진 내용과 짝지어져 학습된 일이 드물다는 것이다. 4억 쌍을 영어 검색어로 모았으므로 공간의 문장 쪽이 영어 중심이다. 그래서 다섯 한국어 라벨의 벡터가 서로 거의 구별되지 않고, 어느 사진이든 같은 라벨이 근소하게 앞서 한 라벨로 쏠린다. 지식의 문제가 아니라 학습 데이터 분포의 문제다.
Q3. VLM의 답이 그럴듯하면 사진을 잘 본 것 아닌가?
아니다. VLM의 답도 다음 토큰 확률이 낸다. 사진이 문맥에 들어가므로 지어낼 여지가 줄 뿐이다. 실측에서 우도 해안 사진에 보이지 않는 “사람 무리”가 답에 들어갔고, 한국어로 물으면 만장굴 사진이 “자동차 문”이 됐다. 그럴듯함과 정확함은 다르다. 답의 요소를 사진과 하나씩 대조해야 한다.
Q4. 사진을 작게 넣으면 시각 토큰이 줄어 싸지지 않나?
이번 주 모델에서는 아니다. SmolVLM의 프로세서는 사진의 긴 변을 2048로 맞춘 뒤 512 타일로 자르므로, 3:2 비율이면 240x160이든 1920x1280이든 832토큰이다. 토큰 수를 정하는 것은 가로세로 비율과 타일 분할 설정이다. 분할을 끄면 64토큰으로 줄고 첫 토큰까지 시간이 약 40초에서 약 3초로 줄었다(작성 환경 CPU, 1회 측정). 다른 모델은 규칙이 다르므로, 비용을 설계하기 전에 그 모델의 프로세서가 사진을 어떻게 자르는지부터 확인한다.
Q5. 제로샷 분류에서 라벨을 잘 쓰면 성능이 크게 오르지 않나?
오른다. 같은 모델, 같은 사진에서 라벨만 바꿔 한국어 1/5, 영어 짧은 라벨 4/5, 영어 장면 묘사 5/5가 나왔다. CLIP 논문도 A photo of a {label}. 틀과 80개 틀의 앙상블로 ImageNet 정확도를 5% 가까이 올렸다고 보고했다. 라벨 설계는 프롬프트 설계(4주차)의 멀티모달판이다.
Q6. Flamingo와 LLaVA는 무엇이 가장 다른가?
사진이 언어모형에 들어가는 자리가 다르다. Flamingo는 언어모형을 얼려 두고 층 사이에 새 교차 어텐션 층을 끼워, 글 토큰이 그 층에서 시각 토큰 64개를 참고하게 한다. LLaVA는 시각 특징을 투영 층으로 단어 임베딩 공간에 옮겨 입력 토큰 자리에 붙인다. LLaVA 방식은 단순하지만 시각 토큰이 문맥 길이를 그대로 차지한다. 이번 주 SmolVLM이 이쪽이다.
Q7. 두 인코더가 “같은 공간에 있다”는 것은 무슨 뜻인가?
두 인코더의 내부 구조가 같다는 뜻이 아니다. 각 인코더 끝의 투영 층이 벡터를 같은 512차원으로 내보내고, 짝이 맞는 쌍의 벡터가 가까워지도록 두 투영 층이 함께 학습되었다는 뜻이다. 두 인코더는 각자 따로 계산하고, 정규화 뒤의 내적(코사인 유사도)에서만 만난다.
Q8. 작은 VLM(256M)을 쓰는 것은 의미가 없지 않나?
의미가 있다. CPU에서 돌고, 구조(사진이 문맥에 어떻게 들어가는가)는 큰 VLM과 같은 원리로 관찰된다. 언어 능력과 세부 인지는 큰 모델보다 약하지만(한국어 질문 실패, 어두운 사진의 뭉개짐), 관찰 도구로는 오히려 좋다. 깨지는 지점이 선명하게 드러난다.
Q9. 멀티모달 데이터는 어디서 구하나?
이 과목에서는 위키미디어 공용과 공공누리의 개방 이미지를 쓴다(이 문서 아래 사진 출처 표). 도내 기업의 데이터는 쓰지 않는다. 기업은 조건 상정으로만 등장한다. 모델과 사진은 노트북이 실행 시점에 내려받는다.
스스로 점검
Section titled “스스로 점검”- 벡터 (6, 8)을 정규화하면? 이 벡터와 (0.8, 0.6)의 코사인 유사도는?
- 배치에 (사진, 문장) 쌍이 4개 있다. 대조 학습의 유사도 표에서 짝이 맞는 칸과 짝이 아닌 칸은 각각 몇 개인가?
- 두 라벨의 코사인이 0.266과 0.274다. logit_scale 100이면 로짓 차이는? 두 라벨의 확률 비는 대략 얼마인가?
- 한국어 라벨의 정답 1/5가 “한 장은 맞혔다”가 아닌 이유는?
- 텍스트 전용 모델에게 사진을 물으면 어떤 성격의 답이 나오는가? 5주차의 어떤 개념과 같은 뿌리인가?
- Flamingo가 새 교차 어텐션 층의 출력에 tanh(α)를 곱하고 α를 0에서 시작하는 이유는?
- SmolVLM에서 640x640 사진은 분할을 켜면 시각 토큰이 몇 개인가? 계산 과정을 쓰자.
- 과제 2에서 이미지 모달리티를 추가하면 지연·비용이 늘어나는 지점 세 가지를 쓰자.
정답 보기
- 길이 10이므로 (0.6, 0.8). 코사인 = 0.6 x 0.8 + 0.8 x 0.6 = 0.96
- 짝이 맞는 칸 4개(대각선), 짝이 아닌 칸 4² - 4 = 12개
- 로짓 26.6과 27.4, 차이 0.8. 확률 비는 e^0.8, 약 2.2배. 실측 확률은 0.307과 0.683이었다
- 사진 5장 중 4장이 모두 첫 라벨 “성산일출봉 사진”을 골랐다. 사진과 상관없이 거의 같은 라벨을 고르는 상태에서, 첫 사진이 우연히 그 라벨의 정답이었을 뿐이다
- 사진을 본 적이 없으므로 언어적으로 그럴듯한 장면을 지어낸다(“강가에서 낚시하는 사람들”, “기타 치는 흰 셔츠 남자”). 5주차 false acceptance와 같은 뿌리다. 다음 토큰 확률은 참을 보장하지 않는다
- 학습 초기에 새 층의 영향을 0으로 두어, 얼려 둔 언어모형이 원래와 똑같이 동작하게 하려는 것이다. 새 층이 학습되면서 α가 커지면 시각 정보가 조금씩 섞인다. 기존 언어 능력을 해치지 않는 장치다
- 긴 변 2048로 키우면 2048x2048, 512 타일 4 x 4 = 16장, 전체 사진 1장을 더해 17장. 17 x 64 = 1,088토큰
- (1) 시각 토큰이 늘어 문맥 창 점유율 상승, (2) 비전 인코더가 타일 여러 장을 읽는 시간, (3) 긴 문맥 때문에 첫 토큰까지와 생성 시간 증가. 사진 장수와 비율, 분할 설정에 따라 달라진다
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 한 줄 뜻 |
|---|---|
| 모달리티 | 데이터의 종류(텍스트, 이미지, 음성 등). 이번 주는 텍스트와 이미지 |
| 멀티모달 모델 | 둘 이상의 모달리티를 함께 다루는 모델 |
| 정규화 | 벡터를 길이로 나눠 길이 1로 맞추는 것. 방향만 남는다 |
| 코사인 유사도 | 정규화된 두 벡터의 내적. 같은 방향일수록 1에 가깝다 |
| 이중 인코더 (dual encoder) | 이미지와 텍스트를 각자 다른 인코더로 인코딩해 벡터끼리 비교하는 구조(CLIP) |
| 투영 층 | 인코더의 출력을 공유 공간의 차원으로 옮기는 층 |
| 대조 학습 | 짝이 맞는 쌍은 가깝게, 배치 안의 나머지 쌍은 멀게 하는 학습 |
| 대칭 교차엔트로피 | 사진 -> 문장 방향과 문장 -> 사진 방향의 분류 손실을 함께 쓰는 것 |
| logit_scale | 유사도에 곱하는 학습된 배율(온도의 역수). CLIP은 100을 상한으로 두었다 |
| 제로샷 분류 | 분류기 학습 없이 후보 문장과의 유사도로 고르는 방법 |
| 정렬 (alignment) | 서로 다른 모달리티의 벡터를 비교 가능한 하나의 공간에 놓는 것 |
| ViT-B/32 | 사진을 32x32 패치로 잘라 토큰처럼 읽는 이미지 트랜스포머 (224 입력이면 패치 49개) |
| SigLIP | 표의 각 칸을 시그모이드로 따로 판정해 학습하는 CLIP 계열 모델. SmolVLM의 비전 인코더 계열 |
| VLM | 사진을 언어모형 문맥에 넣어 문장으로 답하는 모델 |
| Perceiver Resampler | Flamingo에서 사진 특징을 시각 토큰 64개로 요약하는 모듈 |
| 게이트 교차 어텐션 | Flamingo가 언어모형 층 사이에 끼운 층. tanh(α) 게이트로 0에서 시작한다 |
| 시각 토큰 | 사진이 언어모형 문맥에서 차지하는 토큰 |
| 타일 분할 | 사진을 여러 조각으로 나눠 각각 시각 토큰으로 만드는 처리. 토큰 수를 크게 바꾼다 |
| 픽셀 셔플 | 이웃한 패치 특징 여러 개를 하나로 묶어 토큰 수를 줄이는 처리 |
| 채팅 템플릿 | 대화 형식을 프롬프트로 조립하는 절차. 사진 자리는 표시자로 둔다 |
| 근거 (grounding) | 답이 입력(사진)의 내용에 붙어 있는 것. 사진을 바꾸면 답이 따라 바뀐다 |
| 문맥 잠식 | 사진이 문맥 창의 대부분을 차지하는 것. 7주차로 이어진다 |
| 언어 편향 | 정렬 공간과 생성 능력이 학습 데이터의 언어(영어)에 붙는 것 |
노트북이 실행 시점에 위키미디어 공용에서 내려받는 제주 사진 5장이다. 과제 보고에 인용할 때 아래 표를 그대로 쓴다.
| 사진 | 원본 제목 (위키미디어 공용) | 저자 | 라이선스 |
|---|---|---|---|
| 성산 일출봉 | Sunrise with Seongsan Ilchulbong | Sukkim1996 | CC BY-SA 4.0 |
| 성산 주차장 | Sunrise peak carpark - panoramio | gary4now | CC BY 3.0 |
| 영실 등산로 | Wooden staircase along Yeongsil Trail with the mountains of Hallasan Park Jeju Island South Korea | Basile Morin | CC BY-SA 4.0 |
| 만장굴 | Lava Manjanggul Cave | Solène Huille | CC BY-SA 4.0 |
| 우도 해안 | Udo, Jeju Province, South Korea 02 | 제주영상문화산업진흥원 (공공누리 제1유형) | KOGL Type 1 |
- CC BY(-SA)는 저작자 표시가 조건이다. KOGL Type 1은 출처 표시가 조건이다
- 위키미디어 공용 파일 페이지에서 원본과 라이선스 전문을 확인할 수 있다
실습 노트북
Section titled “실습 노트북”
제주 공개 사진 5장을 위키미디어 공용에서 내려받는다. 먼저 CLIP 제로샷으로 유사도 히트맵을 그려 라벨 언어(영어/한국어/섞기)가 결과를 어떻게 바꾸는지 본다. 그다음 SmolVLM에 질문을 주고 사진만 바꿔 답이 사진을 따라 움직이는지, 한국어 질문이 어떻게 깨지는지 확인한다. 같은 질문을 텍스트 전용 모델에도 주어 비교하고, 사진 1장이 몇 토큰이 되는지와 그 수를 정하는 것이 무엇인지 잰다. 바꿀 곳은 사진 한 장이다. 작성 환경의 CPU에서 1회 실행해 처음부터 끝까지 약 2분 30초 걸렸다(모델 내려받는 시간 제외). Colab 무료 CPU에서는 이보다 더 걸릴 수 있다.