
2주차: 구현 기반 - 학습 루프와 텐서 연산
구현 기반 - 학습 루프와 텐서 연산
□ 이 주차가 놓이는 자리
- 1주차에서 “토큰이 늘면 비용이 제곱으로 늘어난다”를 배웠다. 이번 주부터는 직접 손으로 돌려 보는 단계다
- 이번 주에 만드는 학습 루프(모델을 가르치는 반복 절차)는 3주차 PEFT, 이후 프롬프트·RAG·정렬 실습까지 전부 이 코드를 재사용한다. 여기서 한 번 끝까지 돌려 보지 않으면 이후 주차가 성립하지 않는다
- 목표는 하나다. 전원이 학습 루프를 끝까지 돌려 손실(틀린 정도)이 낮아지는 것을 확인하는 것
- 이번 주를 한 장면으로 요약하면 “골짜기 바닥을 향해 한 걸음씩 내려가기”다. 손실이라는 언덕에서, 기울기가 알려 주는 내리막 방향으로, 학습률만큼 걷는다
□ 읽기 안내 - 이 노트의 어디와 이어지나
| 읽기 | 이 노트에서 다루는 곳 | 먼저 확인할 질문 |
|---|---|---|
| PyTorch Tensors | 텐서의 shape와 행렬 연산 | 숫자가 몇 개의 축과 칸에 담기는가 |
| PyTorch Automatic Differentiation | 계산 그래프와 backward() | 순전파 기록이 어느 기울기로 되돌아오는가 |
| PyTorch Optimizing Model Parameters | 손실·역전파·갱신의 학습 루프 | 손실 계산과 가중치 변경은 어떤 순서로 연결되는가 |
| FlashAttention, Dao 외, 2022, v2 | SRAM·HBM, 타일링과 재계산 | 같은 어텐션 수식의 메모리 이동을 어떻게 줄이는가 |
| DeepSeek-V4.1-Flash 기술 보고서, 2026, v1 | CSA2·계층형 인덱서·FP4·CED·제한 재생 | 저장량·조회량·재계산량 중 무엇을 바꾸는가 |
| 같은 모델의 고정판 config.json | 40개 층 배치와 SWA 창 크기 | 보고서의 설명과 실제 설정 값이 어떻게 연결되는가 |
- 기본 읽기는 텐서·자동미분·학습 루프. 최신 모델 사례는 비용 구조 비교를 위한 대면 확장 읽기이며 해당 대형 모델을 실행하는 실습이 아닌 자료
온라인 (2시수)
Section titled “온라인 (2시수)”강의: 텐서 연산과 자동미분, 사전학습 모델 로딩
Section titled “강의: 텐서 연산과 자동미분, 사전학습 모델 로딩”□ 텐서 - 숫자를 담는 상자
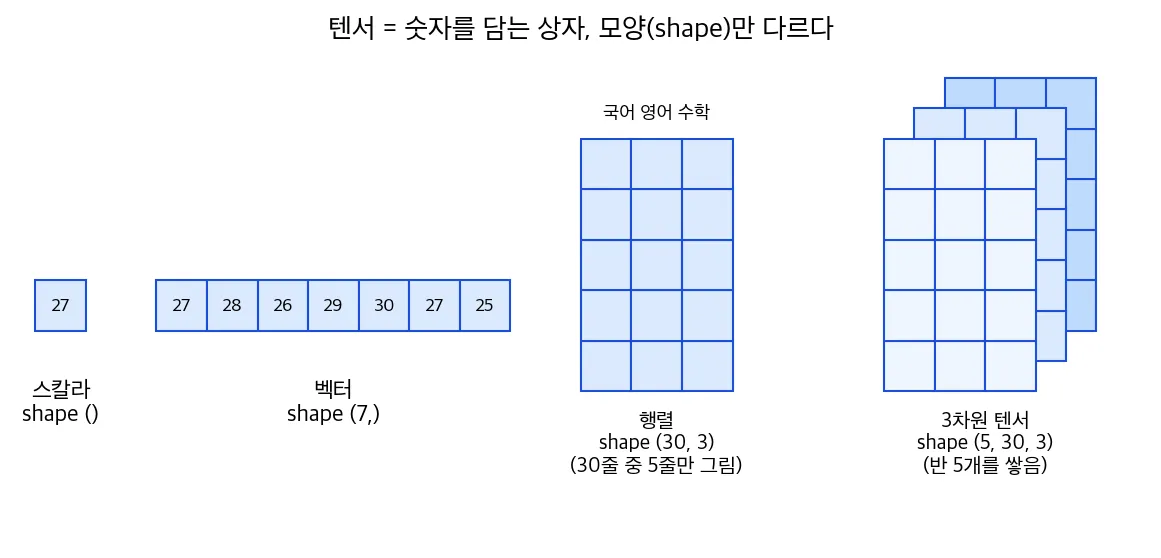
- 텐서(tensor)는 겁낼 것 없이 숫자를 담는 상자다. 상자의 모양에 따라 이름만 달라진다
- 스칼라: 숫자 하나 (예: 오늘 기온 27)
- 벡터: 숫자를 일렬로 놓은 것 (예: 일주일치 기온 7개)
- 행렬: 숫자를 바둑판처럼 놓은 것 (예: 반 학생 30명의 국어·영어·수학 점수, 30줄 x 3칸)
- 그 이상: 행렬을 여러 장 쌓은 것 (예: 우리 학년 5개 반 전부의 점수)
- NLP에서 텐서가 하는 일: 토큰 번호를 숫자 묶음으로 바꿔 담고(임베딩), 행렬 곱셈으로 표현을 섞고, 마지막에 확률로 낸다. 모델의 가중치(모델이 기억하는 값)도 전부 텐서다. “모델이 크다”는 말은 곧 “텐서가 크다”는 말이다
- GPU가 잘하는 일이 바로 이 텐서 연산을 수천 개씩 동시에 하는 것이다. 같은 계산을 엄청나게 많이, 동시에 - 이것이 AI에 GPU가 필요한 이유다
○ shape - 상자의 크기표
- 텐서마다 shape라는 크기표가 붙는다. 괄호 안의 숫자 개수가 차원 수, 각 숫자가 그 방향의 칸 수다
- 스칼라는
(), 일주일 기온은(7,), 30명의 세 과목 점수는(30, 3), 5개 반 전체는(5, 30, 3)이다. 읽는 순서는 “반 5개 → 학생 30명 → 과목 3개”처럼 바깥 상자부터 안쪽으로다 - 칸의 총 개수는 shape의 숫자를 모두 곱한 값이다.
(5, 30, 3)이면 5 x 30 x 3 = 450칸이다. 1주차의 메모리 계산(칸 수 x 4바이트)과 같은 원리다 - NLP에서 자주 보는 모양은
(배치, 토큰 수, 숫자 묶음 크기)다. 문장 8개를 한 번에 넣고, 문장마다 토큰 128개, 토큰마다 숫자 768개로 표현하면(8, 128, 768)이다
○ 행렬 곱셈 손으로 한 번
- 모델 안에서 가장 많이 일어나는 계산이 행렬 곱셈이다. 2 x 2로 한 번만 손으로 해 보면 겁낼 이유가 사라진다
[[1, 2], [3, 4]]와[[5, 6], [7, 8]]을 곱한다. 규칙은 “왼쪽 행렬의 가로줄과 오른쪽 행렬의 세로줄을 짝지어 곱해서 더한다”이다- 왼쪽 첫째 줄 [1, 2]와 오른쪽 첫째 세로줄 [5, 7]: 1 x 5 + 2 x 7 = 19
- 왼쪽 첫째 줄 [1, 2]와 오른쪽 둘째 세로줄 [6, 8]: 1 x 6 + 2 x 8 = 22
- 왼쪽 둘째 줄 [3, 4]와 [5, 7]: 3 x 5 + 4 x 7 = 43, [3, 4]와 [6, 8]: 3 x 6 + 4 x 8 = 50
- 결과는
[[19, 22], [43, 50]]이다. 1주차 어텐션의 “내적”이 바로 이 “짝지어 곱해 더하기” 한 번이다
○ shape가 안 맞으면 생기는 일
- 행렬 곱셈에는 조건이 하나 있다. 왼쪽의 가로 칸 수와 오른쪽의 세로 칸 수가 같아야 짝을 지을 수 있다.
(2, 3)곱하기(3, 2)는 되지만(2, 3)곱하기(2, 3)은 안 된다 - 조건이 깨지면 코드는 멈추고 오류를 낸다. 실습에서 가장 흔한 오류가 이것이다
import torcha = torch.ones(2, 3)b = torch.ones(2, 3)a @ b # 오류a @ b.T # b를 뒤집어 (3, 2)로 만들면 성공, 결과 shape는 (2, 2)- 첫 번째 곱셈을 실행하면 오류 메시지의 마지막 줄에
mat1 and mat2 shapes cannot be multiplied (2x3 and 2x3)가 찍힌다. “두 행렬의 모양이 2x3과 2x3이라 곱할 수 없다”는 뜻이다. 괄호 안 숫자만 읽으면 무엇이 안 맞는지 바로 보인다 .T는 행렬의 가로와 세로를 뒤집는다.(2, 3)이(3, 2)가 되어 짝이 맞고, 결과는(2, 2)다
□ 자동미분 - 어디서 틀렸는지 거꾸로 따라가기
- 모델을 가르치려면 “얼마나, 어느 쪽으로 틀렸는지”를 알아야 한다. 그 답이 그래디언트(기울기) 다
- 비유: 시험에서 감점됐을 때 “어느 문제의 어느 풀이 단계에서 점수가 깎였나”를 거꾸로 추적하는 것과 같다. 총점(손실)만 봐서는 고칠 곳을 모른다. 단계별 감점(각 가중치의 그래디언트)을 알아야 고친다
- 원리는 하나다.
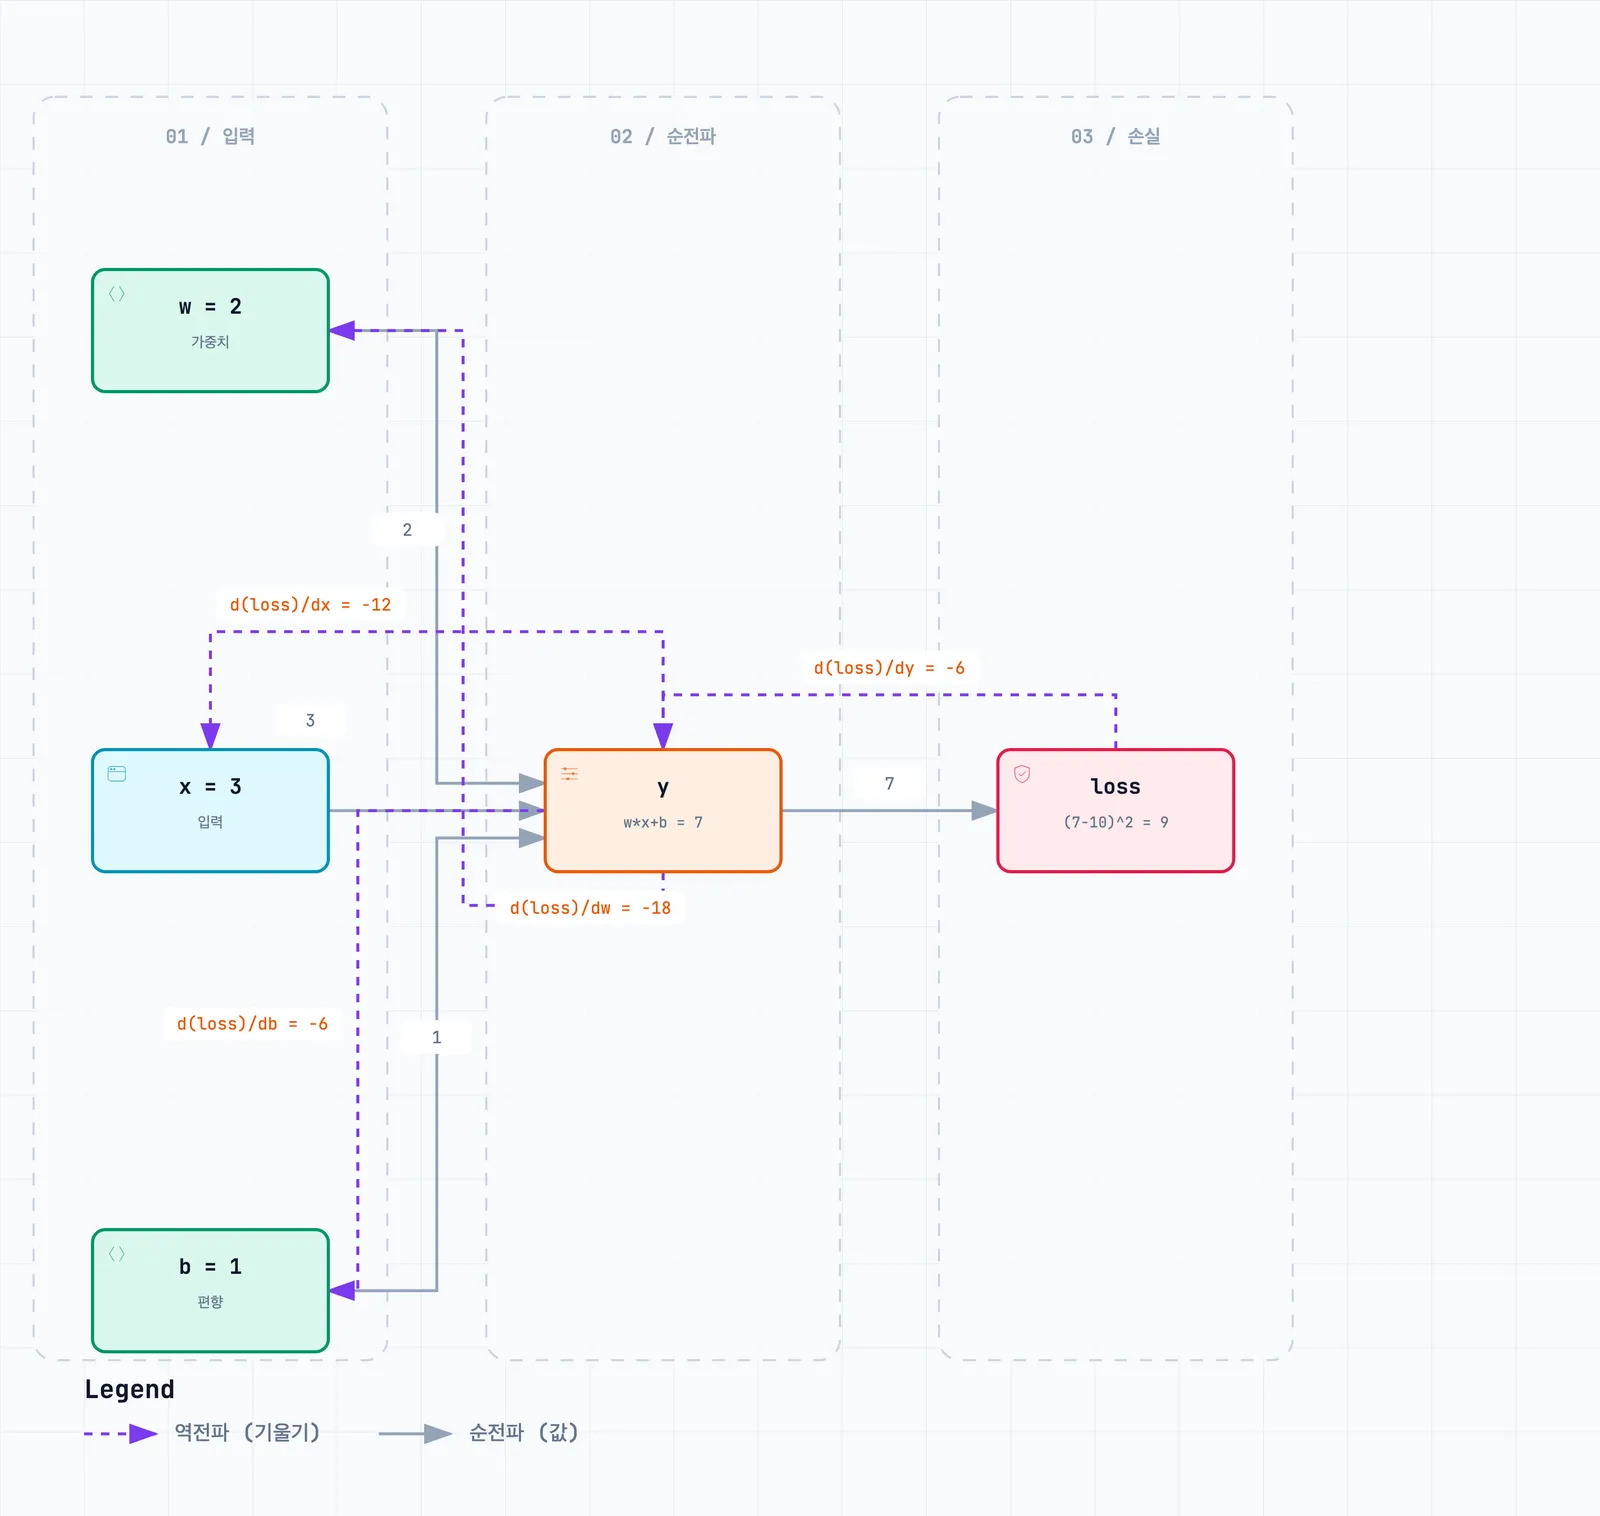
requires_grad=True로 표시한 텐서에 연산을 걸면, 프레임워크가 연산 기록(계산 그래프) 을 메모해 둔다.loss.backward()를 부르면 그 메모를 거슬러 올라가며 각 텐서의 감점표(그래디언트)가 채워진다 - 실습 노트북 1-1의 실측값으로 확인한다.
loss = (w*x + b - 10)^2이고w=2, x=3, b=1일 때:
| 항목 | 값 | 뜻 |
|---|---|---|
| loss | 9.0000 | (2 x 3 + 1 - 10)^2 = (-3)^2 |
| d(loss)/dw | -18.0000 | w를 조금 키우면 loss가 그 18배만큼 줄어드는 방향 |
| d(loss)/dx | -12.0000 | x에 대한 기울기 |
| d(loss)/db | -6.0000 | b에 대한 기울기 |
- 손으로도 확인해 본다.
w*x+b = 7이고loss = (7-10)^2 = 9. 미분의 연쇄법칙(겉미분 x 속미분)으로d(loss)/dw = 2*(7-10)*x = -18. 코드 출력과 정확히 일치한다. 자동미분은 마법이 아니라 연쇄법칙을 기계가 대신 적용해 주는 것이다
□ 기울기로 한 걸음씩 - 경사하강법을 손으로
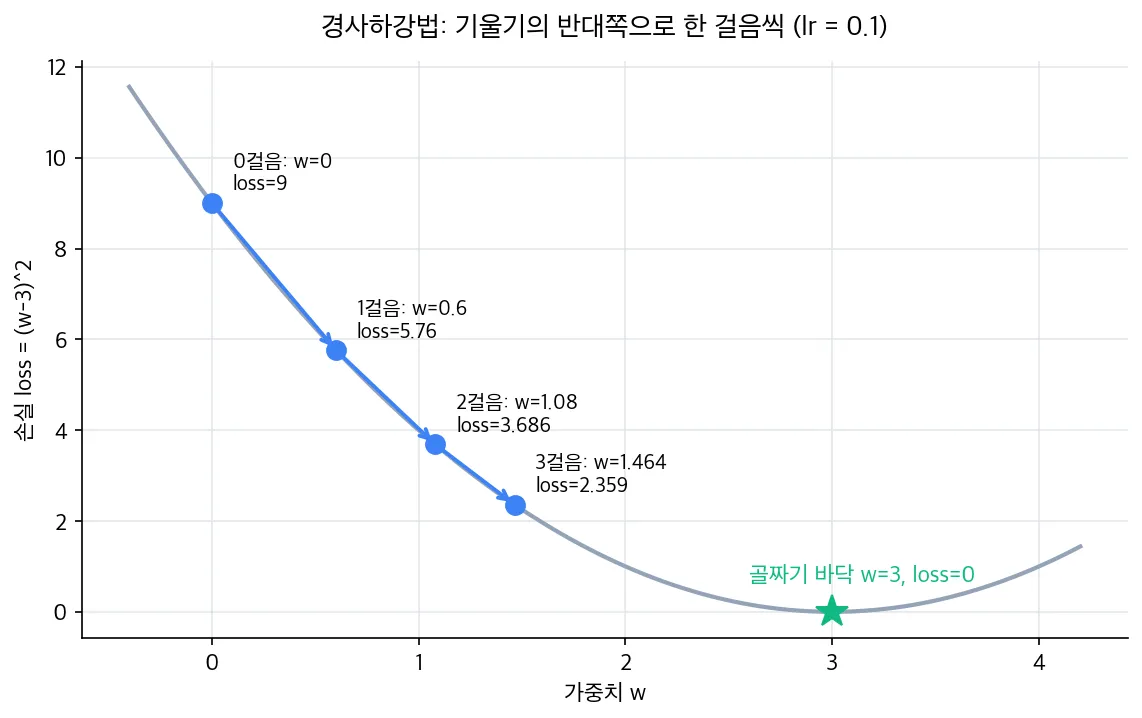
- 그래디언트를 구했으면 이제 고친다. 짙은 안개 속 언덕에서 골짜기 바닥으로 내려가는 사람을 떠올리자. 멀리는 안 보이지만 발밑의 경사는 느낄 수 있다. 내리막 쪽으로 한 걸음 옮기고, 다시 경사를 느끼고, 또 한 걸음. 이것이 경사하강법(gradient descent)이다
- 가장 단순한 예로 따라가 본다. 손실이
loss = (w - 3)^2인 문제다. 정답은 w = 3이고 그때 손실은 0이다. 시작은 w = 0, 한 걸음 크기인 학습률은 lr = 0.1이다 - 기울기는
d(loss)/dw = 2 x (w - 3)이다. 갱신 규칙은새 w = w - lr x 기울기다
| 걸음 | w | loss = (w-3)^2 | 기울기 2(w-3) | 다음 w 계산 |
|---|---|---|---|---|
| 0 | 0 | 9 | -6 | 0 - 0.1 x (-6) = 0.6 |
| 1 | 0.6 | 5.76 | -4.8 | 0.6 - 0.1 x (-4.8) = 1.08 |
| 2 | 1.08 | 3.6864 | -3.84 | 1.08 - 0.1 x (-3.84) = 1.464 |
| 3 | 1.464 | 2.359296 | -3.072 | (다음 걸음으로) |
- 표를 읽는 요령이 두 가지다. 첫째, 기울기가 음수면 w를 키우는 쪽이 내리막이다. 갱신식의 빼기가 음수를 만나 더하기가 된다. 둘째, 바닥에 가까워질수록 기울기가 작아져서 걸음도 저절로 작아진다 (-6 → -4.8 → -3.84)
○ 학습률 - 걸음이 너무 작거나 너무 크면
- 같은 문제를 학습률만 바꿔 20걸음씩 돌렸다 (강의용 스크립트 실행값)
| 학습률 lr | 5걸음 뒤 loss | 20걸음 뒤 loss | 한 줄 해석 |
|---|---|---|---|
| 0.01 | 7.3537 | 4.0113 | 너무 조심스러워서 20걸음에도 멀었다 |
| 0.1 | 0.9664 | 0.0012 | 꾸준히 바닥에 다가간다 |
| 0.5 | 0 | 0 | 첫 걸음에 정확히 바닥. 이 문제에서만 우연히 딱 맞는 크기 |
| 1.05 | 23.3437 | 407.3333 | 너무 커서 바닥을 넘어 반대편으로 튀고, 점점 더 멀어진다 (발산) |
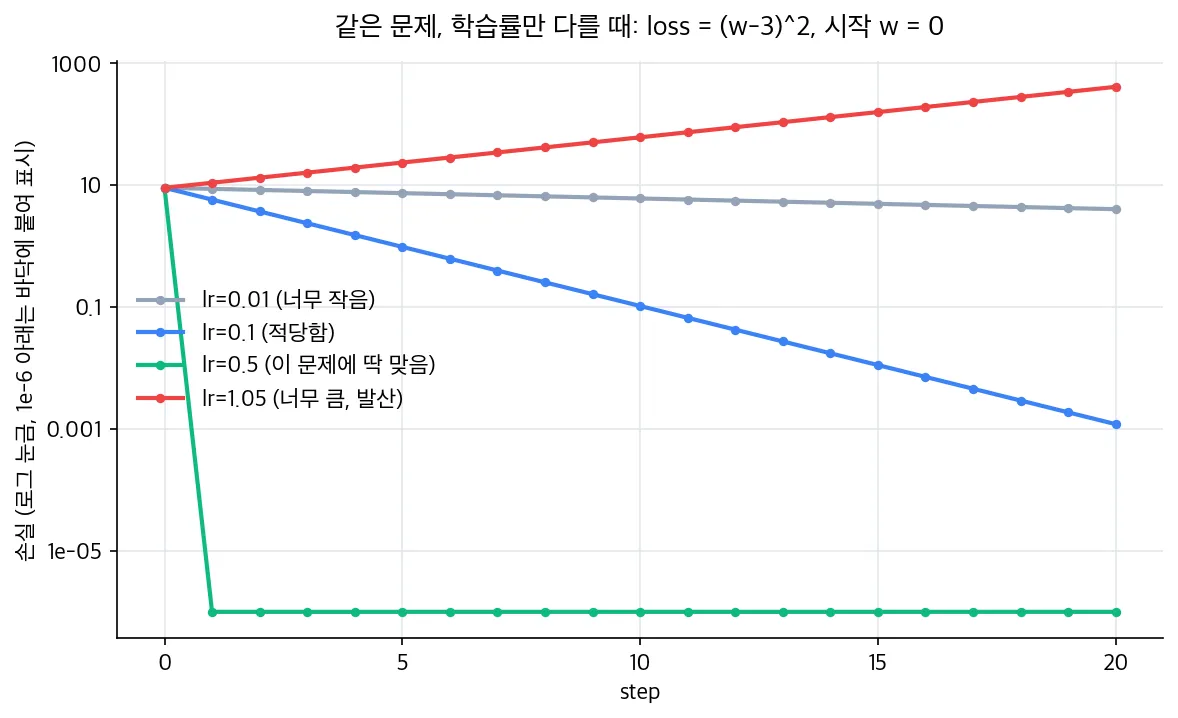
- 실제 모델에서는 “딱 맞는 크기”를 미리 알 수 없다. 그래서 작게 시작해 손실 곡선을 보며 조정한다. 손실이 줄지 않고 오히려 커지면 학습률부터 의심하는 습관을 들인다
□ 학습 루프 - 네 단계의 반복
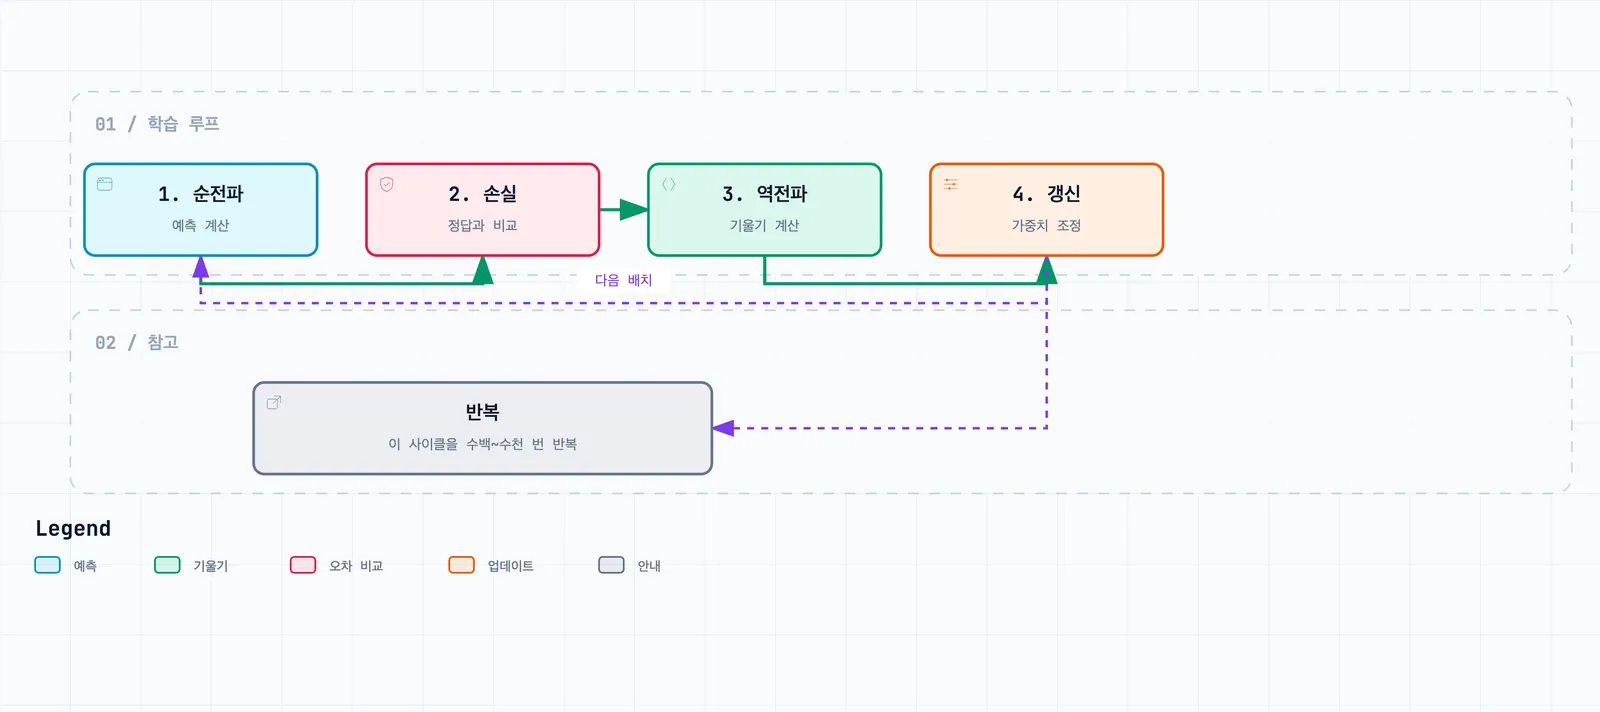
- 모델을 가르치는 일은 다음 네 단계를 수백, 수천 번 반복하는 것이다
- 순전파: 입력을 넣어 예측을 계산한다 (문제를 푼다)
- 손실: 예측과 정답의 차이를 숫자 하나로 만든다 (채점한다)
- 역전파:
loss.backward()로 각 가중치의 그래디언트를 구한다 (감점 원인을 추적한다) - 갱신:
w -= lr * w.grad로 그래디언트 반대 방향으로 한 걸음 이동한다 (틀린 쪽의 반대로 고친다).lr(학습률)은 한 걸음의 크기다
- 실습 노트북 1-2의 실측값. 정답이
y = 3x + 1인 데이터를 맞추는 선형 모델이다. 처음에는 w=0.5, b=0으로 엉터리지만, 반복할수록 정답에 다가간다:
| step | loss |
|---|---|
| 0 | 60.375000 |
| 40 | 0.002392 |
| 80 | 0.001861 |
| 120 | 0.001464 |
| 160 | 0.001152 |
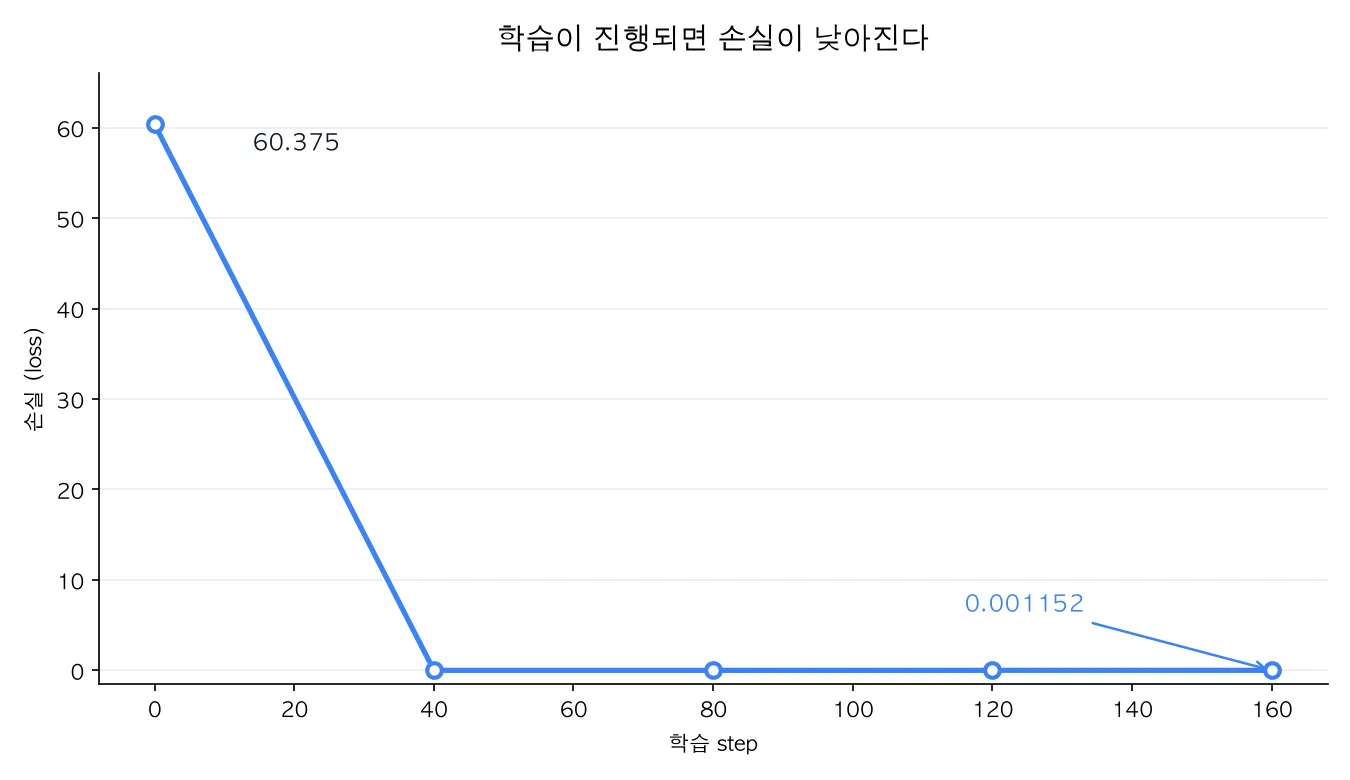
- 200 step 후
w = 3.025, b = 0.926. 정답(w=3, b=1)에 거의 도달했다. 손실이 낮아지는 것 = 모델이 데이터에 맞춰지고 있다는 증거다. 이 그림 한 장이 “학습된다”는 말의 전부다 - 손실 함수(채점 기준)를 바꾸면 같은 데이터에서도 감소 곡선이 달라진다. 평균제곱오차(MSE)는 큰 오차를 세게 혼내고(제곱이라), 평균절대오차(MAE)는 오차 크기만큼만 혼낸다. 이것이 이번 주 노트북의 TODO 한 지점이다
○ MSE와 MAE를 숫자 3개로 비교
- 예측이 [2, 5, 9], 정답이 [3, 5, 5]라고 하자. 오차(예측 - 정답)는 [-1, 0, 4]다
- MSE: 오차를 제곱해 평균. (1 + 0 + 16) / 3 = 5.667
- MAE: 오차의 절댓값을 평균. (1 + 0 + 4) / 3 = 1.667
- MSE에서는 오차 4 하나가 합계 17 중 16을 차지한다. 크게 틀린 하나가 점수를 좌우한다. MAE에서는 5 중 4다. 이상하게 튀는 데이터(이상치)가 섞여 있으면 MSE는 그쪽에 끌려가고, MAE는 덜 흔들린다
○ 채점 기준만 바꿔 학습해 보면
- 정답이 y = 3x + 1인 입력 20개로, 시작점(w=0.5, b=0)과 학습률(0.05)을 같게 두고 손실 함수만 바꿔 200 step 돌렸다 (강의용 스크립트 실행값. 노트북과 데이터가 달라 숫자는 다르다)
| 손실 함수 | step 0 | step 50 | step 200 | step 200의 w, b |
|---|---|---|---|---|
| MSE | 10.2105 | 0.0000 | 0.0000 | 3.000, 1.000 |
| MAE | 2.7263 | 0.2425 | 0.0150 | 3.005, 0.985 |
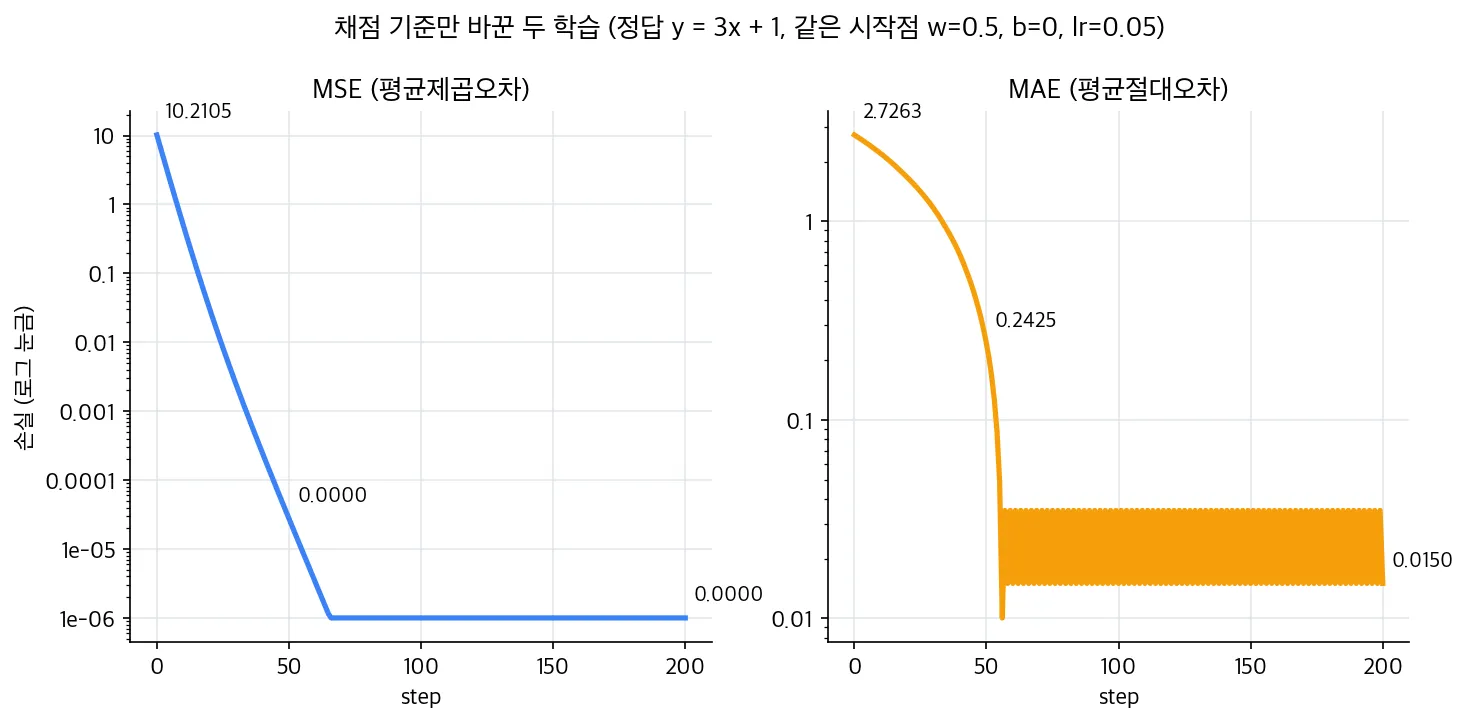
- 두 손실은 점수의 단위가 달라서 숫자 크기를 직접 비교하면 안 된다. 비교할 것은 곡선의 모양과 최종 w, b다
- 이 데이터에는 이상치가 없어서 MSE가 더 빨리, 더 정확히 도착했다. MAE는 오차 하나당 기울기가 크기와 상관없이 +1 또는 -1이라, 바닥 근처에서도 걸음이 줄지 않고 왔다 갔다 한다. 실제로 한 step 뒤에는 b가 0.985에서 1.035로 넘어가 손실이 0.035로 다시 커진다. 노트북 TODO에서 이 차이를 직접 보게 된다
○ 배치, 에폭, step - 반복을 세는 세 단위
- 데이터가 많으면 한 번에 다 넣지 않고 조금씩 나눠 넣는다. 반 전체 쪽지시험을 떠올리자
- 배치(batch): 한 번에 채점하는 답안지 묶음. 32장씩 채점하면 배치 크기 32
- step: 배치 하나를 채점하고 고치는 한 번. 학습 루프 네 단계가 한 바퀴 도는 단위다
- 에폭(epoch): 모든 답안지를 한 번씩 다 본 것
- 계산 예: 답안지(데이터) 2,400장을 배치 16으로 나누면 한 에폭은 2,400 / 16 = 150 step이다. 3주차 실습이 NSMC 2,400건으로 에폭 1회를 도는데, 이때 몇 step인지는 배치 크기에 달려 있다
□ 사전학습 모델 로딩 - 경력직 데려오기
- 우리는 가중치를 처음부터 만들지 않는다. 이미 엄청난 분량의 글을 읽고 학습된 모델을 그대로 가져와 그 위에서 작업한다. 새 직원을 뽑아 1부터 가르치는 대신, 경력직을 데려오는 것과 같다
- 로딩은 두 조각이다. 토크나이저(글자를 잘라 숫자로 바꾸는 번역기)와 모델(그 숫자를 받아 계산하는 본체)
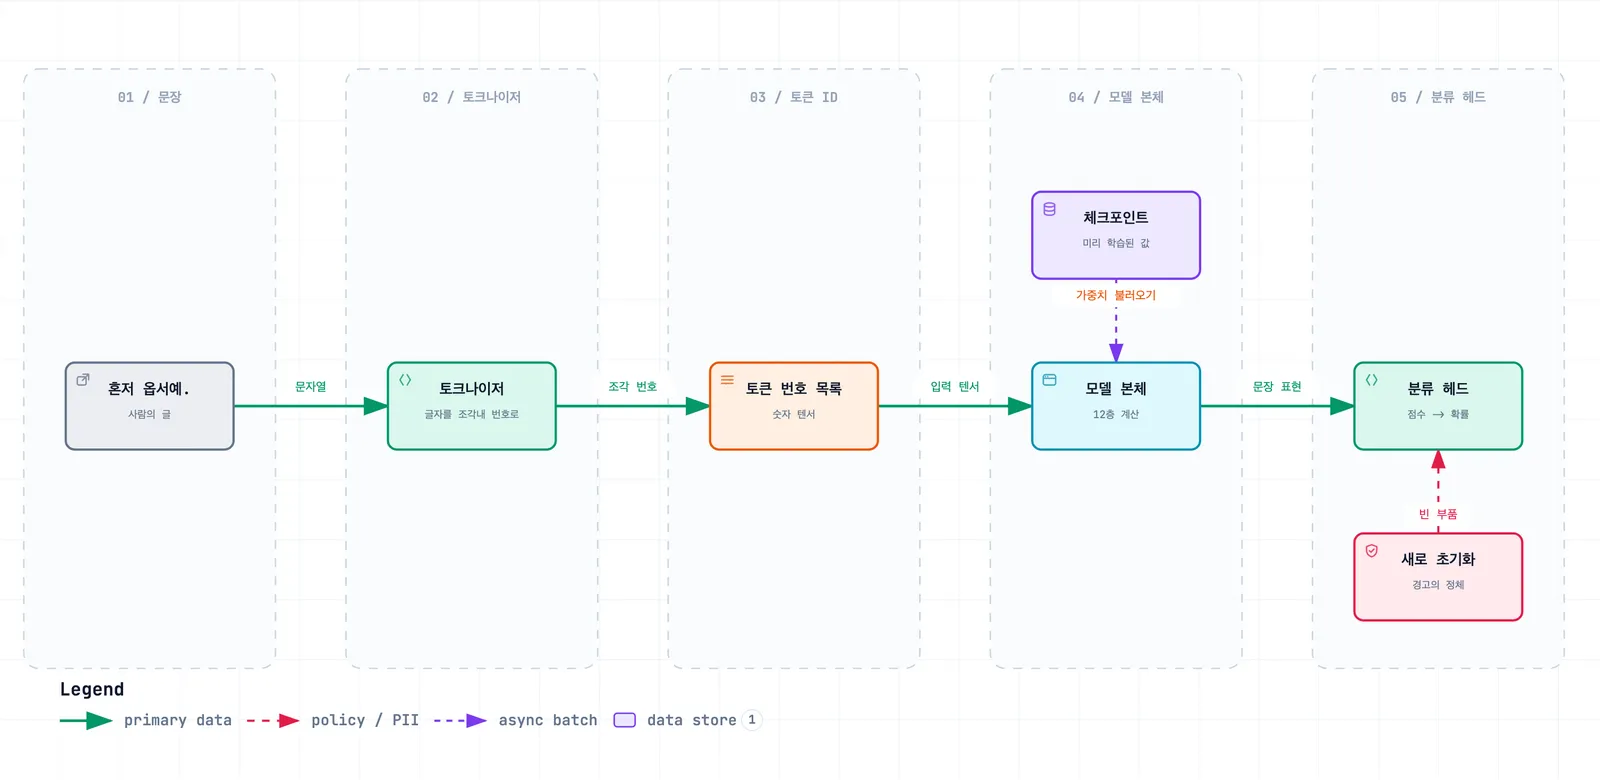
- 문장 하나가 판정되기까지를 순서대로 따라가 본다
- 1단계, 문장: “혼저 옵서예.” 같은 사람의 글이 들어온다
- 2단계, 토크나이저: 글을 조각내고 조각마다 사전에 적힌 번호를 붙인다. 1주차에서 말한 토큰이 여기서 만들어진다
- 3단계, 토큰 번호 목록: 번호들이 텐서로 묶인다. 문장이 여러 개면 shape는
(문장 수, 토큰 수)다 - 4단계, 모델 본체: 체크포인트(미리 학습해 저장해 둔 가중치 파일)에서 불러온 값으로 계산해 문장의 의미를 숫자 묶음으로 만든다
- 5단계, 분류 헤드: 그 숫자 묶음을 “긍정/부정” 같은 판정 점수로 바꾸고, softmax로 확률을 낸다
- 토크나이저와 모델은 반드시 짝을 맞춰 불러온다. 다른 모델의 토크나이저를 쓰면 번호표가 달라서, 모델은 엉뚱한 단어로 읽는다. 오류 없이 돌아가지만 결과가 엉망이 되는, 가장 찾기 어려운 실수다
- 실습에서 쓰는 한국어 모델(KoELECTRA base)의 전체 파라미터 수는 112,922,882개(약 1.1억) 다. 이 숫자를 기억해 둔다. 3주차에서 LoRA가 학습 파라미터를 얼마나 줄이는지 이 수가 기준선이 된다
- 분류 과제용으로 불러오면 분류 헤드(마지막 판정 부품) 가중치가 체크포인트에 없어서 새로 초기화된다는 경고가 뜬다. 고장이 아니라 “이 부품은 직접 데이터로 새로 길들여야 한다”는 안내다
- 튜토리얼 코드(실습 노트북)를 한국어 데이터로 바꿔 실행하고, 막힌 지점을 튜터에게 질의한다
- 질의할 때는 오류 메시지의 마지막 줄을 함께 제시한다. 긴 오류문의 첫 줄이 아니라 마지막 줄에 진짜 원인이 적혀 있다
대면 (1시수)
Section titled “대면 (1시수)”어텐션 커널 최적화(FlashAttention 계열)의 아이디어 개관
Section titled “어텐션 커널 최적화(FlashAttention 계열)의 아이디어 개관”□ 왜 커널(계산 부품) 이야기를 하는가
- 1주차에서 어텐션은 제곱으로 늘어난다고 배웠다. 그런데 실제 GPU에서 돌려 보면, 수식상의 계산량보다 데이터를 이리저리 옮기는 일이 더 큰 병목인 경우가 많다
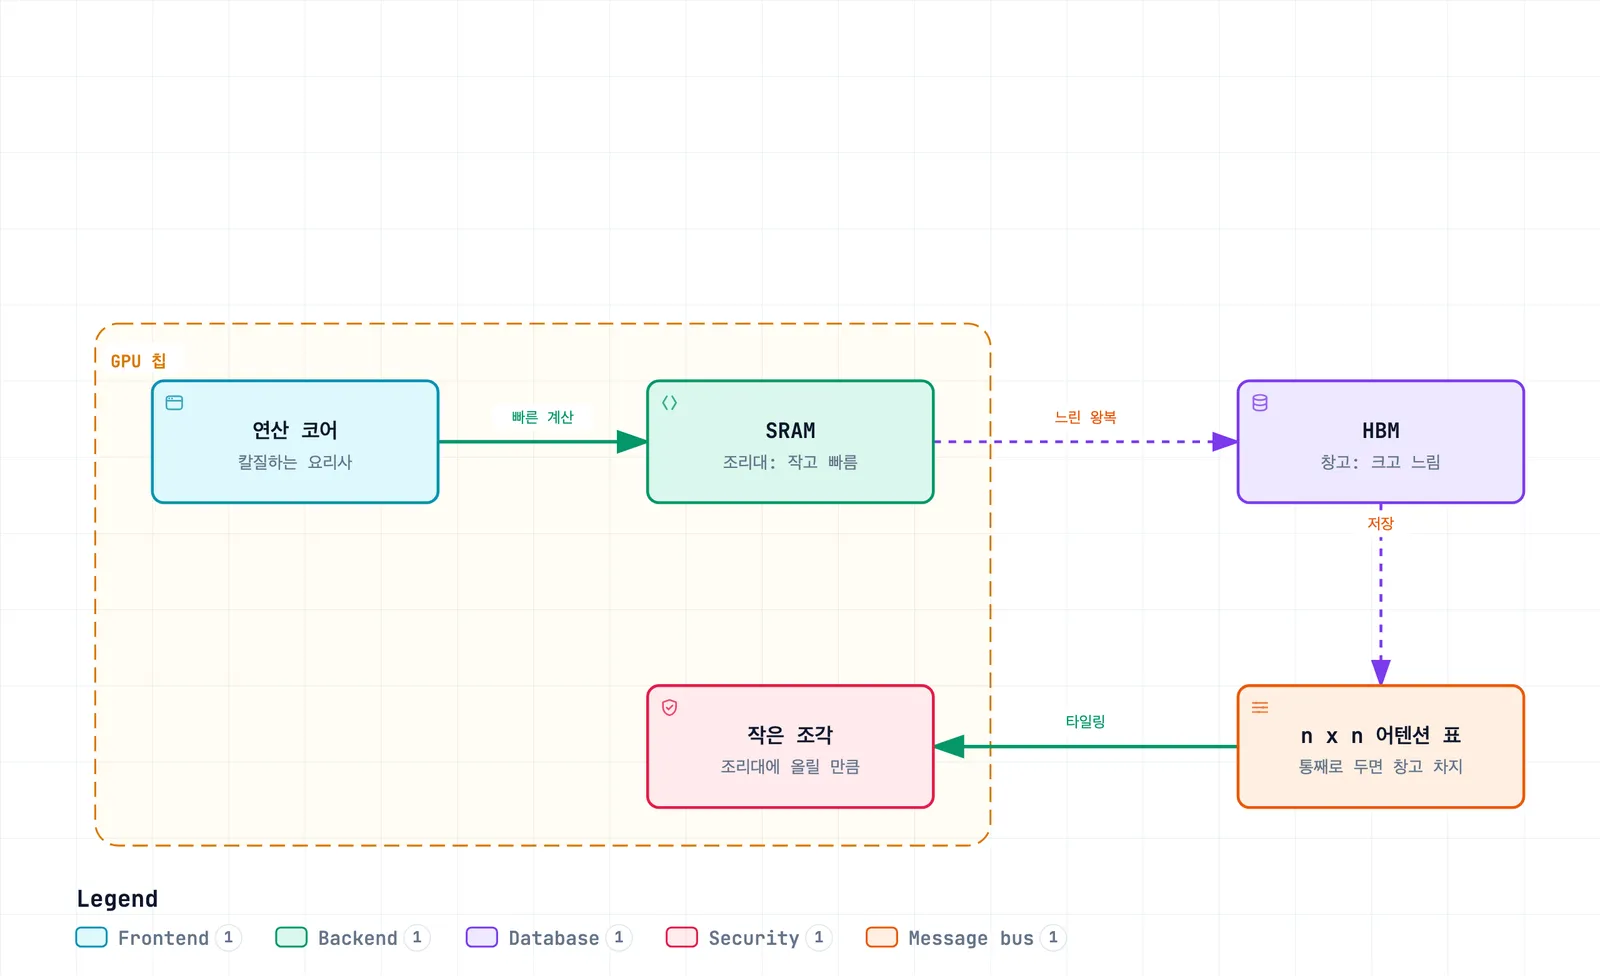
- 비유: 요리사가 칼질(연산)을 아무리 빨리 해도, 재료를 먼 창고(느리고 큰 메모리, HBM)에서 조리대(빠르고 작은 메모리, SRAM)로 오가는 시간이 더 걸리면 전체 요리는 늦어진다
- FlashAttention(arXiv:2205.14135, NeurIPS 2022)은 바로 이 왕복을 줄인다. 어텐션의 수식은 그대로 두고(근사가 아니라 정확한 어텐션) 계산 순서를 GPU 메모리 구조에 맞게 재배열한다
□ 핵심 아이디어 두 가지
- 타일링(tiling): 재료를 한꺼번에 다 꺼내지 않고 한 번에 쓸 만큼만 조리대에 올린다. 어텐션도 Q, K, V를 작은 조각으로 나눠 칩 안의 빠른 메모리에서 처리하니 창고 왕복이 줄어든다
- 재계산(recomputation): 요리 중간 재료를 전부 창고에 보관해 두지 않고, 필요할 때 다시 만든다. 어텐션도 거대한 중간 행렬(n x n)을 저장해 두지 않고 역전파 때 재계산한다. 타일링으로 표를 통째로 만들지 않는 것과 함께, 메모리가 시퀀스 길이에 비례해서만 늘게 된다
- 후속작 FlashAttention-2(arXiv:2307.08691)는 GPU 안에서의 일 분배를 다듬어 같은 하드웨어에서 처리량을 더 끌어올렸다
○ 타일링을 4 x 4 표로 따라가기
- 1주차의 4토큰 점수표(4 x 4 = 16칸)를 다시 꺼내자. 일반 계산은 16칸 전체를 한꺼번에 창고에서 조리대로 옮겨 계산하고, 결과를 다시 창고로 보낸다
- 타일링은 표를 2 x 2 조각 4개로 나눈다. 조리대에는 한 번에 4칸만 올린다. 조각 1을 계산해 결과를 정리하고, 조각 2, 3, 4를 차례로 처리한다
- 조리대(빠른 메모리)는 작아도 괜찮아진다. 한 번에 필요한 공간이 16칸에서 4칸으로 줄었기 때문이다
- 궁금한 점: softmax는 가로줄 전체의 합이 1이 되게 하는 계산인데, 조각으로 나눠도 되나? 조각을 하나 처리할 때마다 지금까지의 합계 정보를 넘겨받아 앞의 결과를 고쳐 나가기 때문에, 최종 결과는 한꺼번에 계산한 것과 같다
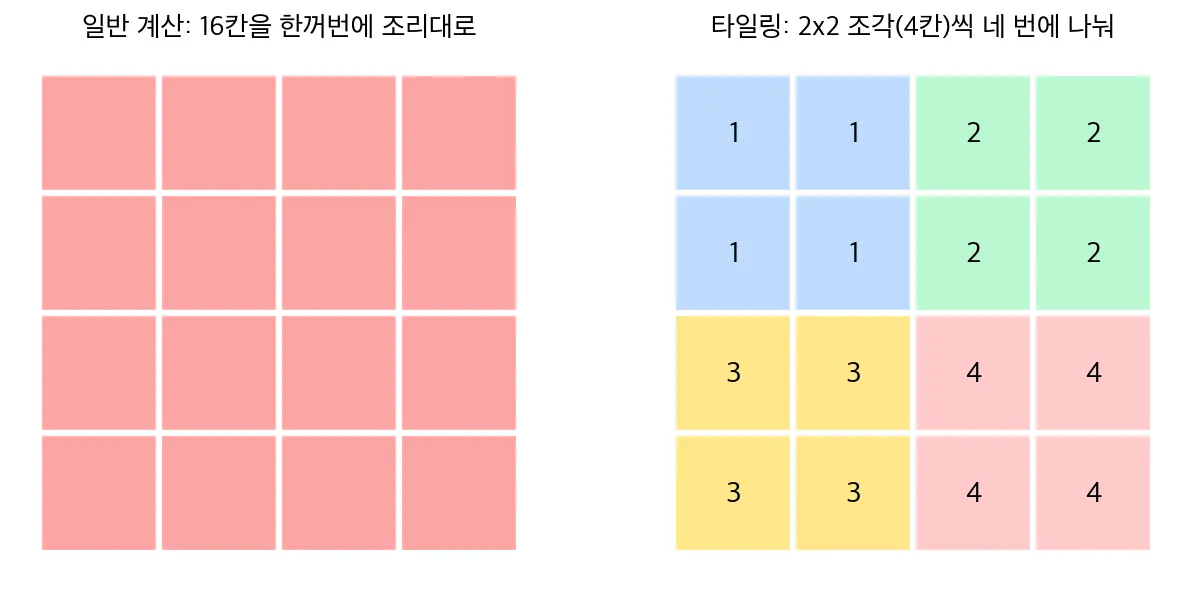
- 실제 크기로 옮겨 보자. 토큰 4,096개의 점수표 한 장은 16,777,216칸, 64MiB다. 설명용으로 조각을 256 x 256으로 자르면 조각 하나는 65,536칸, 65,536 x 4바이트 = 0.25MiB다. 조각 수는 (4,096 / 256) x (4,096 / 256) = 16 x 16 = 256개다
- 64MiB짜리 표를 한 번에 옮기는 대신 0.25MiB 조각을 조리대 안에서 차례로 처리한다. 실제 조각 크기는 GPU의 빠른 메모리 크기에 맞춰 정해진다
○ 재계산이 아끼는 양
- 1주차에서 12층, 층마다 12헤드 모델에 토큰 4,096개를 넣으면 점수표 144장, 약 9GiB가 필요하다고 계산했다
- 역전파(2주차 온라인에서 본 거꾸로 따라가기)를 하려면 원래 이 표들을 저장해 둬야 한다. 재계산은 표를 버리고, 출력과 표를 되살리는 데 필요한 작은 값만 남긴다. 역전파 때 조각 단위로 표를 다시 계산한다
- 계산을 한 번 더 하는 손해가 있지만, 창고 왕복이 줄어서 전체 시간은 오히려 빨라질 수 있다는 것이 FlashAttention의 요점이다. 그리고 결과는 근사가 아니라 원래 어텐션과 같은 계산이다
□ 우리 수업과의 연결
- “같은 모델인데 왜 이 환경에서는 느린가”의 답 절반은 수식이 아니라 커널과 메모리에 있다
- 우리가 커널을 직접 짤 일은 없다. 라이브러리가 이미 만들어 둔 최적화를 알고 선택하는 것이 실무 역량이다. 도내 소규모 조직처럼 장비가 부족한 조건일수록 이 선택이 비용을 가른다
최신 사례 - DeepSeek-V4.1-Flash의 어텐션 효율화
Section titled “최신 사례 - DeepSeek-V4.1-Flash의 어텐션 효율화”□ 왜 이 사례를 보는가
- FlashAttention은 같은 계산을 더 빠르게 하는 방법이었다. 2026년 9월에 공개된 DeepSeek-V4.1-Flash는 한 걸음 더 나가서, 어텐션이 무엇을 기억하고, 누구와 나눠 쓰고, 얼마나 촘촘히 적을지를 크게 다시 설계했다
- 이 절의 내용은 공개 기술 보고서 v1과 고정판 모델 설정 파일에서 가져왔다. 보고서에 없는 숫자는 설정 값으로 직접 계산한 것이며, 그때마다 계산 과정을 보인다
- 출처 확인일: 2026-10-11. 설정 revision
2cba9e42aa026125f3ed06c6d98c1db82f7ca027, 층·창 설정은text_config기준. 보고서 수치·설정 계산과 수업 노트북 실측의 구분 - 결과부터 보자. 보고서가 밝힌 핵심 숫자는 다음과 같다
| 항목 | 보고서 수치 |
|---|---|
| 토큰 하나당 전역 KV 캐시 | 890바이트 (이전 세대 V4-Flash의 약 1/4) |
| 오래 보관하는 KV 캐시 (SSD 등) | V4-Flash의 약 1/8 |
| 최대 문맥 길이 | 100만 토큰 |
| 문맥을 4K에서 1M으로 256배 늘릴 때 토큰 하나 생성 계산량 | 약 1/4만 증가 |
| 모델 구성 | 40개 층 (인코더 20 + 디코더 20), 토큰당 활성 파라미터 입력 처리 8B / 생성 16B |
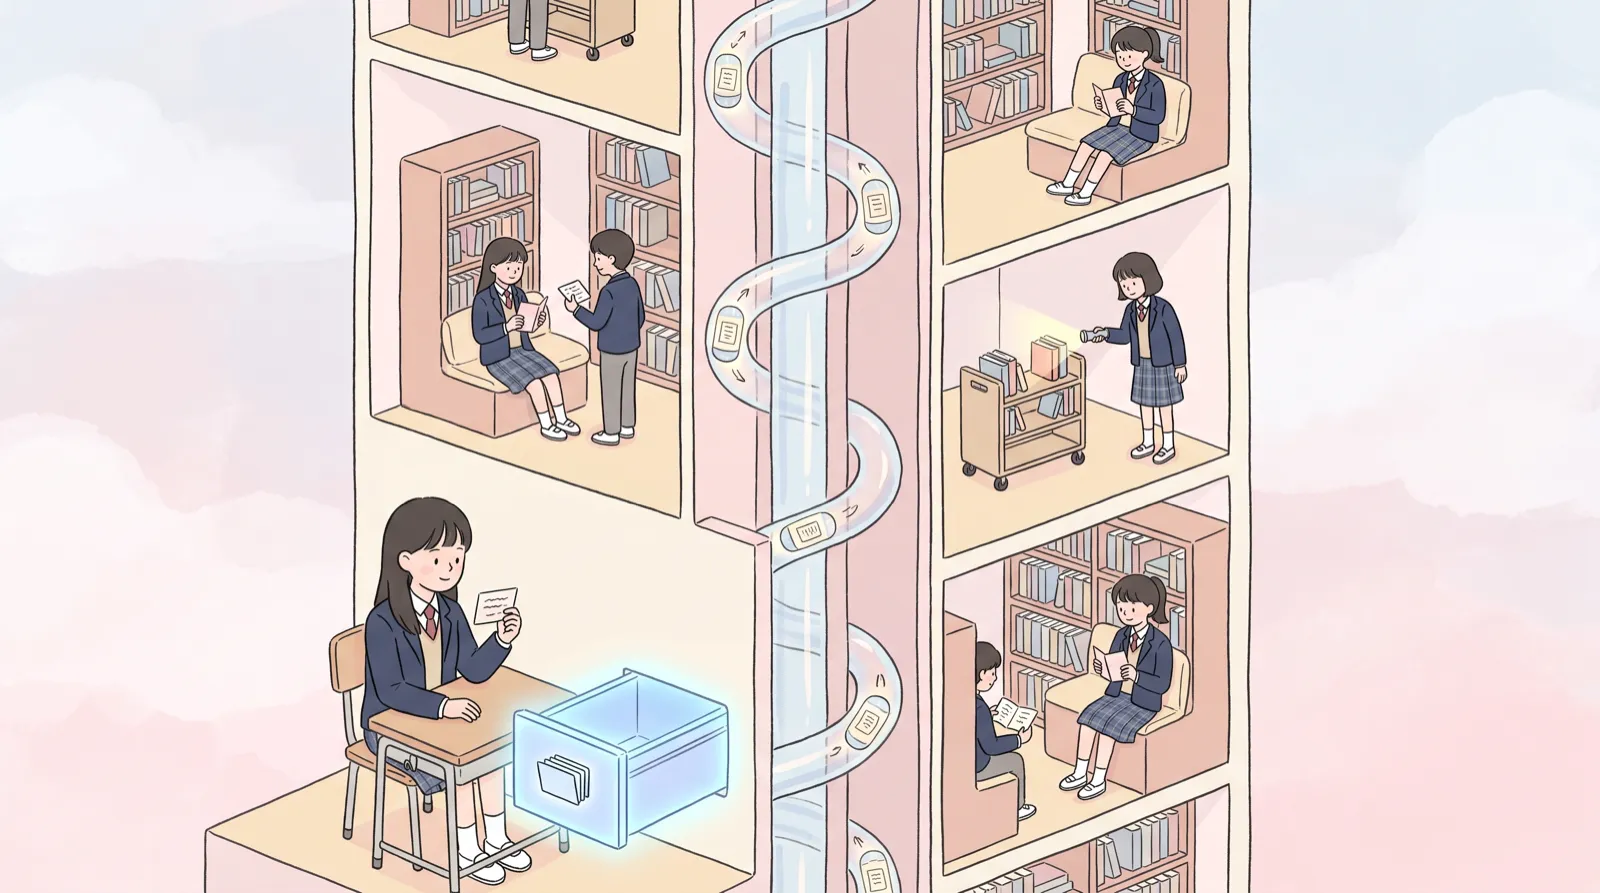
- 네 가지 기법을 차례로 본다. 그림 한 장으로 요약하면 “1층에서 쓴 요약 카드를 위층이 나눠 읽고(층 간 공유), 필요한 책만 미리 추린 카트에서 고르고(희소 선택), 카드는 작은 글씨로 적고(FP4), 위층은 처음부터 다시 읽지 않는다(인코더-디코더)“이다
□ 준비 - 두 종류의 어텐션과 두 곳의 저장소
- 이 모델의 층은 대부분 어텐션을 두 갈래로 함께 쓴다
- 슬라이딩 윈도 어텐션(SWA): 바로 앞 128개 토큰만 보는 창문이다. 창문 크기가 고정이라 문맥이 아무리 길어져도 메모리가 늘지 않는다
- 전역 어텐션: 문맥 전체에서 필요한 것을 찾아본다. 1주차에서 본 KV 캐시(앞 토큰들의 Key·Value 메모장)가 여기서 생긴다
- 메모장을 두는 곳도 두 군데다. 지금 계산 중인 것은 GPU에 붙은 HBM(이번 주의 “창고”. 칩 안 SRAM보다는 느리지만 SSD보다는 훨씬 빠르다)에, 다음에 같은 앞부분이 들어오면 재사용하려는 것은 SSD나 서버 메모리에 오래 보관한다
- 어느 쪽이 큰지 보자. 전역 KV는 토큰당 890바이트라서 문맥이 길수록 정비례로 커진다. 100만 토큰이면 890 x 1,000,000 = 약 849MiB다. 반면 SWA KV는 층마다 창문 128칸만 들고 있어 문맥 길이와 상관없이 크기가 고정이다. 그래서 보고서도 “문맥이 충분히 길면 전역 KV가 KV 메모리의 대부분을 차지한다”고 설명한다. 긴 문맥에서 줄여야 할 것은 전역 KV다
□ 기법 1 - CSA2: 압축하고, 골라 읽고, 층끼리 나눠 쓴다
- CSA2(Compressed Sparse Attention 2)는 KV 캐시 비용을 세 방향에서 동시에 줄인다. 보고서가 정리한 세 방향은 다음과 같다
- 항목 크기 줄이기: KV 한 칸에 담는 숫자 묶음을 작게 한다. 이 모델의 main KV는 512채널짜리 묶음 하나를 모든 헤드가 함께 쓴다
- 시퀀스 방향 줄이기: 토큰 여러 개를 KV 항목 하나로 압축한다. 인코더의 CSA2 층은 압축 비율이 2라서 토큰 2개가 항목 1개가 된다. 1주차의 “요약본” 아이디어를 조금 섞은 셈이다
- 층 방향 줄이기: 층마다 따로 메모장을 만들지 않고 앞 층의 메모장을 빌려 쓴다. 이전 연구에도 있던 아이디어지만, CSA2는 세 방향을 한꺼번에 쓰고 메모장 공유와 선택 재사용을 따로 켤 수 있게 했다
○ 골라 읽기 - 인덱서와 Top-512
- 전역 KV 항목이 수십만 개여도 각 쿼리는 전부 읽지 않는다. 가벼운 인덱서(색인기)가 모든 항목에 점수를 매기고 점수가 높은 512개만 고른다
- 인덱서는 도서관의 목록 카드와 같다. 내 검색어(Indexer Q)와 카드(Indexer K)를 비교해 읽을 책 512권을 추리고, 실제 책 내용(main KV)은 그 512권만 펼친다
- 각 쿼리가 실제로 읽는 것은 고른 512개와 최근 SWA 128개를 합한 640개다. 100만 토큰 문맥이라면 전부 읽을 때의 1,000,000 / 640 = 약 1,560분의 1이다
- 보고서에 따르면 이 희소 어텐션은 처음부터(길이 64K에서) 희소한 상태로 학습했고, 모든 토큰을 보는 어텐션으로 먼저 익히는 단계를 거치지 않았다
○ 나눠 쓰기 - 세 가지 모드
- CSA2 층은 학습 전에 정해 둔 세 모드 중 하나로 동작한다. 모든 모드에서 자기 질문(Main Q)과 SWA KV는 직접 계산하고, 나머지를 얼마나 빌리느냐가 다르다
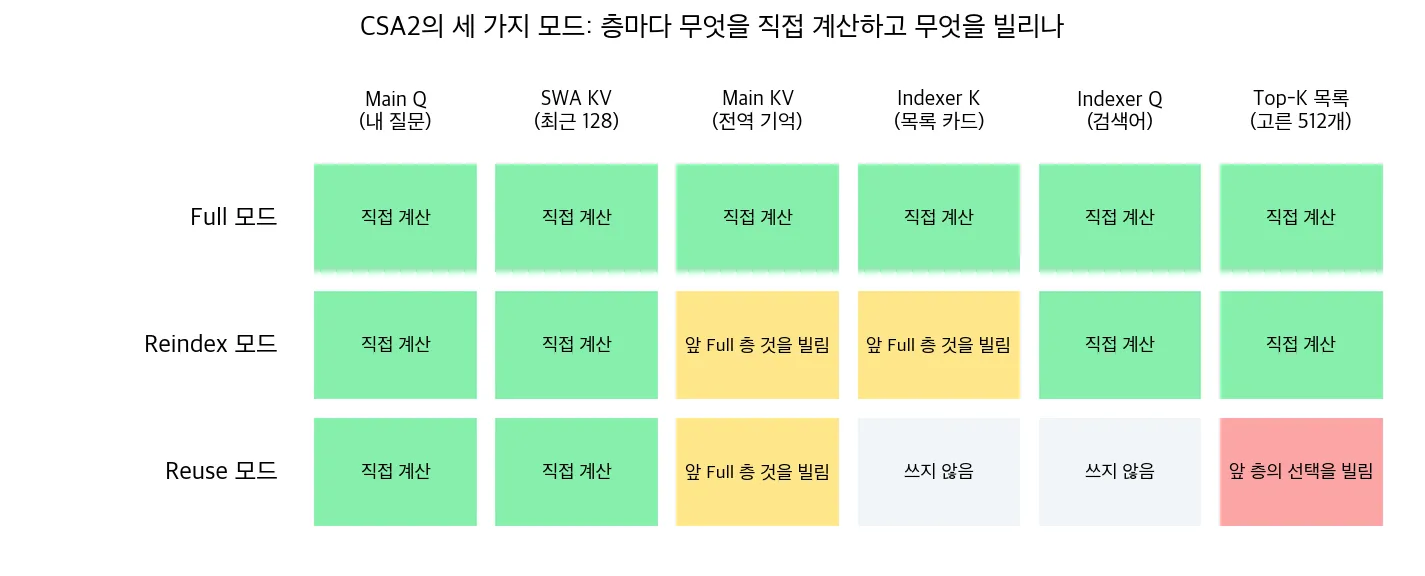
- Full 모드: 전역 KV와 목록 카드를 직접 만들고, 직접 검색해 512개를 고른다. 모든 일을 스스로 하는 층이다
- Reindex 모드: 전역 KV와 목록 카드는 앞의 Full 층 것을 빌린다. 대신 자기 검색어로 다시 검색해서 자기만의 512개를 고른다. 같은 책장을 쓰되 층마다 필요한 책이 다를 수 있기 때문이다
- Reuse 모드: 전역 KV도, 고른 512개 목록도 앞 층 것을 그대로 쓴다. 검색을 아예 하지 않으니 가장 가볍다
- 비유로 정리하면, Full은 필기를 직접 하는 학생, Reindex는 친구 필기를 빌려서 형광펜만 자기가 긋는 학생, Reuse는 친구가 형광펜까지 그어 둔 필기를 그대로 보는 학생이다
○ 40개 층은 어떻게 배치됐나
- 설정 파일의 값을 층 번호(0부터 셈)대로 펼치면 다음과 같다
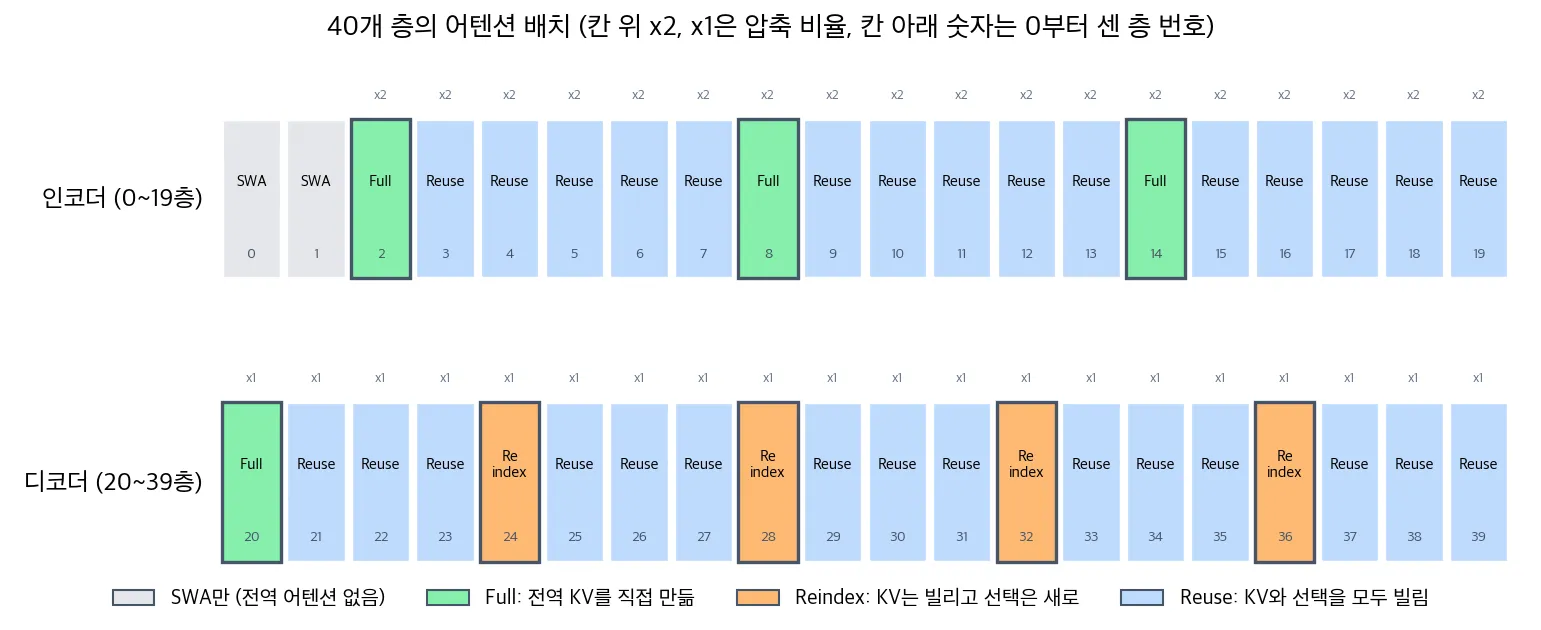
- 인코더 20층: 맨 앞 2개 층은 SWA만 쓰고, 2, 8, 14층이 Full, 나머지 15개 층이 Reuse다. CSA2를 쓰는 18개 층의 압축 비율은 모두 2다
- 디코더 20층: 20층이 Full, 24, 28, 32, 36층이 Reindex, 나머지 15개 층이 Reuse다. 압축 비율은 1(압축 없음)이다
- 전역 KV를 실제로 만드는 층은 40개 중 4개(2, 8, 14, 20층)뿐이다. 나머지 34개의 전역 어텐션 층은 이 네 층의 메모장을 빌려 쓴다
○ 890바이트를 손으로 맞춰 보기
- 보고서가 밝힌 “토큰당 890바이트” 중에서, 보고서와 설정 파일에 형식이 적힌 main KV 부분을 직접 계산해 보자
- main KV 항목 하나: 보고서는 512채널짜리 main KV를 4비트(E2M1)로 적고 16채널마다 8비트 보조 눈금(E4M3)을 하나씩 붙인다고 밝혔다. 512 x 0.5 = 256바이트, 보조 눈금 512 / 16 = 32바이트. 합계 288바이트
- 인코더 Full 층 3개: 압축 비율 2라 토큰 하나당 항목 0.5개. 288 x 0.5 x 3 = 432바이트
- 디코더 Full 층 1개: 압축 없음. 288바이트
- main KV 합계는 432 + 288 = 720바이트다. 890바이트에서 남는 170바이트는 목록 카드(Indexer K) 등의 몫이다. 보고서가 목록 카드의 저장 형식을 자세히 밝히지 않아서, 이 부분은 뺄셈으로만 구하고 더 쪼개지 않는다
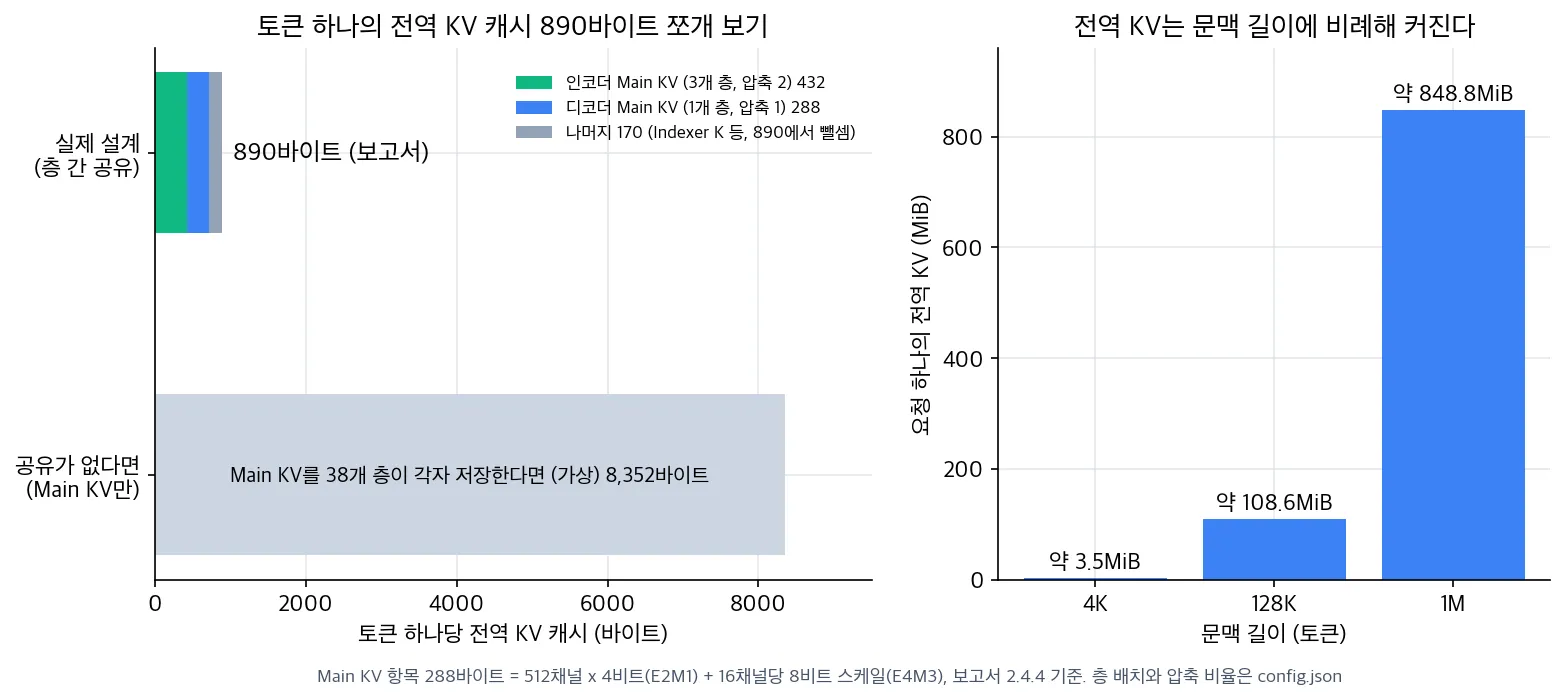
- 공유가 없다면 어떨까. main KV만 따져서, 전역 어텐션이 있는 38개 층이 모두 자기 main KV를 가진다고 가정하자. 인코더 18개 층 x 144바이트 = 2,592바이트, 디코더 20개 층 x 288바이트 = 5,760바이트, 합계 8,352바이트다. 실제 720바이트의 약 11.6배다. 층 간 공유 하나로 main KV가 10분의 1 아래로 줄어든 것이다
□ 기법 2 - 계층형 희소 인덱서: 1차 서류 심사로 후보를 추린다
- 골라 읽기 덕분에 어텐션은 가벼워졌지만, 고르는 일(인덱서 채점)은 여전히 문맥 전체를 훑는다. 100만 토큰이면 검색할 때마다 100만 개에 점수를 매겨야 한다
- 디코더에서는 이 문제를 1차 심사와 면접처럼 푼다
- 1차 심사: 디코더의 첫 Full 층(20층)이 문맥 전체에 점수를 매긴다. 자기 Top-512를 고르는 동시에, 위치 8개씩 묶은 블록마다 안에 든 위치 중 최고 점수를 블록 점수로 삼고, 점수가 가장 높은 블록을 최대 2,048개 뽑는다. 이 블록들이 덮는 위치, 최대 2,048 x 8 = 16,384개가 후보 풀이다
- 면접: 뒤의 Reindex 층(24, 28, 32, 36층)은 전체가 아니라 후보 풀 16,384개 안에서만 다시 채점해 각자 512개를 고른다
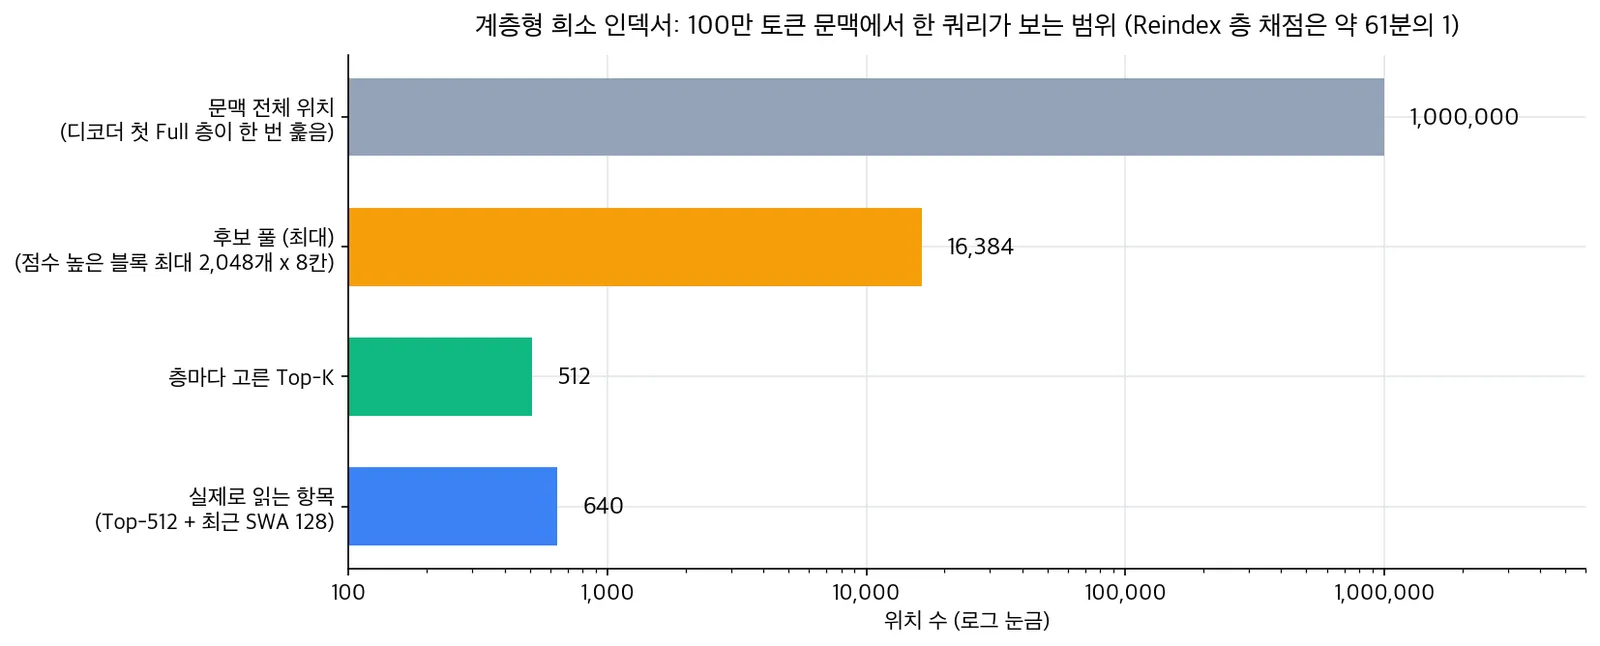
- 효과: 뒤 층의 채점 대상이 문맥 길이와 상관없이 최대 16,384개로 제한된다. 100만 토큰이면 1,000,000 / 16,384 = 약 61분의 1이다. 문맥이 25만 토큰이든 100만 토큰이든 뒤 층의 채점 수는 최대 16,384개로 같다
- 대신 첫 Full 층은 여전히 전체를 한 번 훑는다. 그리고 이 제한은 사후 학습 단계에서 학습 때도 똑같이 적용해서, 뒤 층 인덱서가 “후보 풀 안에서만 고르는” 상황에 익숙해지도록 했다
□ 기법 3 - FP4 KV 캐시: 메모장을 작은 글씨로
- 3주차에서 자세히 배울 양자화를 미리 맛본다. 숫자를 적는 비트 수를 줄이면 저장 공간이 준다
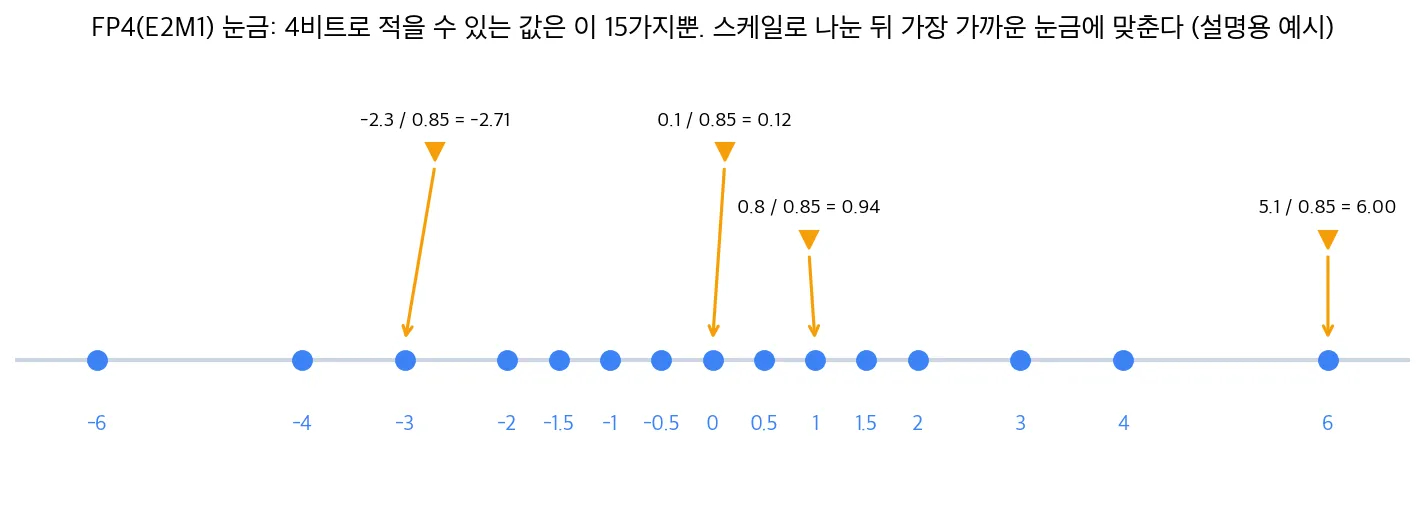
- 이 모델은 main KV를 4비트(E2M1 형식)로 저장한다. 4비트로 적을 수 있는 값은 0, 0.5, 1, 1.5, 2, 3, 4, 6과 그 음수, 모두 15가지뿐이다. 그래서 채널 16개마다 보조 눈금(스케일, 8비트 E4M3 형식) 하나를 붙여 “이 묶음은 몇 배로 읽어라”를 함께 적는다
○ 숫자 4개로 따라 하기 (설명용 예시)
- 저장할 값이 [0.8, -2.3, 5.1, 0.1]이라고 하자
- 1단계, 보조 눈금 정하기: 절댓값이 가장 큰 5.1이 눈금의 끝인 6에 오도록 5.1 / 6 = 0.85로 정한다 (실제로는 보조 눈금도 8비트라 0.875 같은 가까운 값으로 맞추지만, 계산을 쉽게 하려고 0.85를 쓴다)
- 2단계, 나누기: 0.8 / 0.85 = 0.94, -2.3 / 0.85 = -2.71, 5.1 / 0.85 = 6.00, 0.1 / 0.85 = 0.12
- 3단계, 가장 가까운 눈금에 맞추기: 0.94 → 1, -2.71 → -3, 6.00 → 6, 0.12 → 0
- 4단계, 되살리기: 1 x 0.85 = 0.85, -3 x 0.85 = -2.55, 6 x 0.85 = 5.1, 0 x 0.85 = 0. 원래 값 [0.8, -2.3, 5.1, 0.1]과 조금씩 다르다. 이 차이가 정밀도 손실이다
○ 보고서가 밝힌 주의점
- 손실을 줄이려고 학습 중에 4비트 저장을 흉내 내는 방식(QAT, 양자화 인식 학습)으로 사후 학습했다. 모델이 거친 눈금에 미리 적응하게 하는 것이다
- 이전 세대의 8비트(FP8) main KV와 비교해 저장 공간이 거의 절반이 됐다
- 표현할 수 있는 가장 큰 값은 보조 눈금 최대 448 x 6 = 2,688이다. 이 모델의 KV 값은 이론상 최대 약 22.6, 학습 중 실제로는 약 10이라서 여유가 충분하다
- 모든 것을 4비트로 바꾸지는 않았다. SWA KV는 양자화에 민감해서 8비트를 유지했다. 줄일 곳과 지킬 곳을 나눈 것이다
□ 기법 4 - 인과 인코더-디코더와 SWA 제한 재생: 위층은 처음부터 다시 읽지 않는다
- 에이전트는 도구를 부를 때마다 긴 입력을 새로 처리(prefill)한다. 메모장을 재사용하지 못하면 매번 긴 입력 전체를 40개 층에 통과시켜야 한다
- 인과 인코더-디코더(CED): 아래 20층을 인코더, 위 20층을 디코더로 나눈다. 디코더의 전역 KV는 디코더 층을 계산해서 얻지 않는다. 디코더의 Full 층(20번 층)이 인코더 마지막 층(19번 층)의 출력에서 바로 뽑아내고(투영), 나머지 디코더 층은 기법 1에서 본 대로 그것을 빌려 쓴다
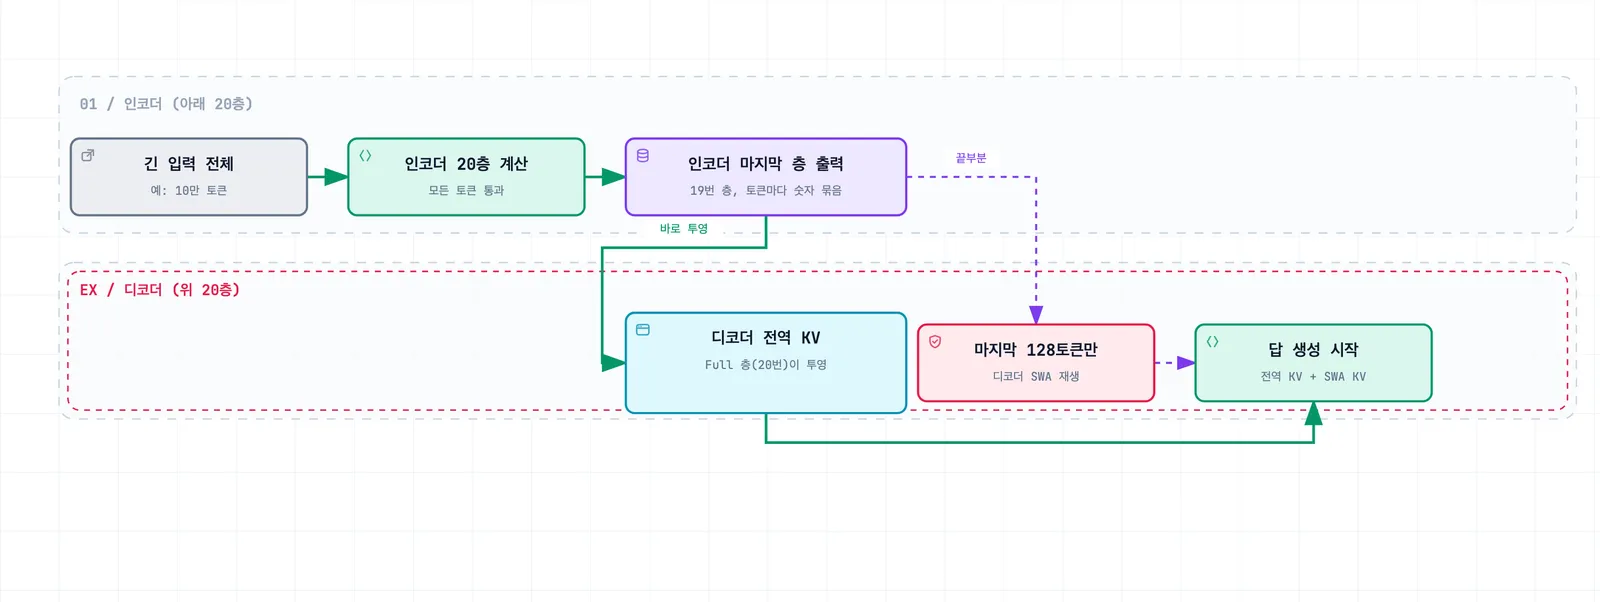
- 계산으로 확인해 보자. 입력 100,000토큰, 층 40개, 창문 128이라고 하면 기존 방식의 “층 x 토큰” 계산은 100,000 x 40 = 4,000,000이다
- CED는 입력 전체가 인코더 20층만 지나고(100,000 x 20 = 2,000,000), 디코더는 끝부분 128토큰만 지난다(128 x 20 = 2,560). 합계 2,002,560, 기존의 절반(약 50%)이다. 보고서도 입력 처리 계산이 거의 절반으로 준다고 밝혔다
○ 왜 끝부분 128토큰만 다시 읽어도 되나 - SWA 제한 재생
- 문제는 SWA다. SWA는 층마다 자기 계산이 필요해서, 정확히 복원하려면 층이 쌓인 만큼 더 앞까지 봐야 한다. 창문 128칸이 층마다 겹겹이 이어지기 때문이다
- 정확한 복원: 40층 전체라면 40 x 128 = 5,120토큰을 다시 계산해야 한다 (디코더만이면 20 x 128 = 2,560토큰)
- 제한 재생(Bounded Replay): 마지막 128토큰만 다시 계산하고, 그보다 앞은 없는 셈 친다. 결과는 정확한 값이 아니라 근사지만, 보고서의 실험에서는 답변 품질 저하가 거의 없었다. 디코더 쪽 재생은 안전을 위해 사후 학습 때도 흉내 냈다
- 이 근사 덕분에 저장 전략도 바뀌었다. 이전 세대에서는 오래 보관하는 캐시의 거의 절반이 SWA KV였다. 이제 인코더 SWA KV는 SSD에 보관하지 않고 서버 메모리의 10%를 쓰는 공간에 몇 분만 두며, 사라지면 128토큰만 다시 계산한다. 디코더 SWA KV는 아예 보관하지 않고 매번 재생으로 만든다. 전역 KV는 72시간 이상 보관한다
- 그래서 오래 보관하는 캐시가 약 1/8이 됐다. SWA KV를 빼서 거의 절반, 남은 전역 KV가 1/4이므로 1/2 x 1/4 = 1/8이다
□ 한 장으로 정리
| 기법 | 줄이는 것 | 핵심 아이디어 | 대가 또는 주의 |
|---|---|---|---|
| 압축 + Top-512 선택 | 어텐션이 읽는 양 | (인코더) 토큰 2개를 항목 1개로, 512개 + 최근 128개만 읽기 | 인덱서가 잘 골라야 한다 |
| CSA2 층 간 공유 | 전역 KV 저장 | 40개 층 중 4개 층만 메모장을 만든다 | 공유 구조로 학습해야 하고, 분산 학습에 추가 장치가 든다 |
| 계층형 희소 인덱서 | 인덱서 채점 | 뒤 층은 최대 16,384개 후보 풀 안에서만 | 첫 Full 층은 여전히 전체를 훑는다 |
| FP4 main KV | 항목 하나의 크기 | 4비트 + 16채널당 보조 눈금 | 정밀도 손실, QAT 필요, SWA KV는 8비트 유지 |
| 인과 인코더-디코더 | 입력 처리 계산 | 디코더 전역 KV를 인코더 출력에서 투영 | 디코더 SWA를 재생해야 한다 |
| SWA 제한 재생 | 재계산과 장기 저장 | 128토큰만 다시 계산 | 결과가 근사다 |
- 이 기법들과 다른 구조 개선(mHC, Engram, DSpark 등)이 모두 합쳐져서, 문맥을 4K에서 1M으로 256배 늘려도 토큰 하나를 만드는 계산량은 약 1/4만 늘어난다고 보고서는 밝혔다 (8비트·4비트 계산을 가볍게 치는 가중치를 적용한 수치)
□ FlashAttention과 무엇이 다른가
- FlashAttention: 수식은 그대로, 계산 순서와 메모리 사용만 바꿨다. 결과는 원래 어텐션과 같다
- DeepSeek-V4.1-Flash: 무엇을 읽을지(512개 선택), 누가 기억할지(층 간 공유), 얼마나 촘촘히 적을지(4비트), 얼마나 다시 계산할지(128토큰 재생)를 바꿨다. 일부 결과가 근사가 되는 대신 비용을 크게 줄였다
- 그래서 판단 기준이 달라진다. “정확한가”만이 아니라 “근사로 잃는 품질이 아낀 비용에 비해 작은가”를 물어야 한다. 보고서는 품질 저하가 미미하다고 밝혔지만, 이는 개발사 자체 평가다. 우리 과제에 쓸 때는 직접 확인한다. 긴 문맥 추론은 7주차에서 더 깊이 다룬다
온라인에서 막힌 지점 공동 해결
Section titled “온라인에서 막힌 지점 공동 해결”- 사전에 수집한 질문을 화면 공유로 함께 재현하고 고친다
- 흔한 지점: 라이브러리 버전 차이, 파일 경로, 텐서 모양(shape) 불일치. 오류 메시지 마지막 줄 읽는 습관을 반복한다
[이론] 자동미분과 역전파가 학습 루프에서 도는 순서를 그림으로 따라가며 확인. 온라인 강의의 손계산 예시(loss=9, dw=-18)를 자기 숫자로 한 번 더 재현한다
[구현] 동작하는 학습 루프 코드를 받아 그대로 실행해 손실이 낮아지는 것을 먼저 확인하고, 손실 계산 한 줄만 바꿔 결과가 어떻게 달라지는지 관찰. 이후 모든 주차가 이 코드를 재사용하므로 이 주차는 전원이 끝까지 돌려보는 것을 목표로 함
[실무] 교수 작성 방언·표준어 예시로 토큰 비용 차이를 관찰하고, 실제 AI Hub 「한국어 방언 발화(제주도)」 JSON이 확보되면 제공된 로더로 대응쌍을 자동 추출하여 비교
- 공식 데이터 설명의
utterance배열과dialect_form,standard_form필드 기준 로더 제공 - 실제 다운로드 접근과 원본 파일 추출은 아직 검증하지 않음. 파일이 없으면 실제 말뭉치 측정 미실행 표기
- 노트북의 작은 문장 예시는 교수 작성이며 AI Hub 추출 샘플 아님. 코드에 대응쌍을 직접 채우는 추가 구현 요구 없음
- 아래 토큰 수는 해당 예시의 측정이며 실제 말뭉치 전체의 방언 비용 경향으로 일반화하지 않기
□ 토크나이저가 글자를 자르는 모습 (실측)
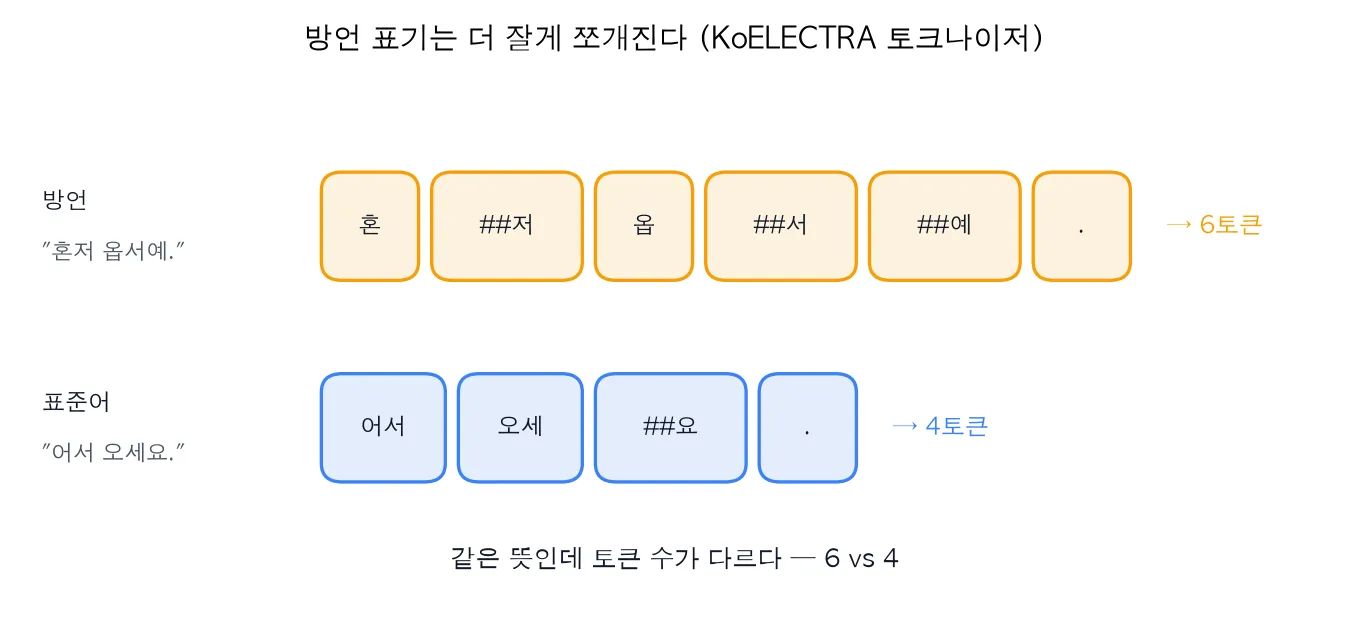
- 토크나이저는 자주 본 글자 덩어리는 통째로, 낯선 덩어리는 잘게 쪼갠다. 사전학습 토크나이저는 표준어 글을 많이 읽고 만들어졌으므로, 제주 방언 표기는 낯설어서 더 잘게 쪼개지는 경향이 있다
□ 노트북 샘플 실측값 (KoELECTRA 토크나이저 기준)
| 방언 | 토큰 수 | 표준어 | 토큰 수 | 차이 |
|---|---|---|---|---|
| 혼저 옵서예. | 6 | 어서 오세요. | 4 | +2 |
| 고맙수다 | 3 | 고맙습니다 | 3 | 0 |
| 하르방 | 2 | 할아버지 | 1 | +1 |
-
비교쌍의 의미·문법 기능은 문맥 기준으로 확인. 국립국어원 정승철, 제주 방언의 특징에 대하여(1998), 각주 8은
마씀의 상대 존대 기능을 설명. 형태가 닮은 표준어 명사를 대응시켜 얻은 토큰 수는 동일 의미 비교의 근거가 아님 -
어휘 대응 근거: 고맙수다 공식 대역 용례, 하르방 공식 구술 용례. 해당 문맥의 어휘 대응으로 해석
-
인사 원전의 직접 대역은
혼저 옵서/어서 오세요. 현재혼저 옵서예.는 교수 작성 변형으로, 원문에서 그대로 추출한 문자열과 구분 -
토큰 수 증가는 곧 입력 길이·연산·비용의 증가다. 1주차의 제곱 법칙과 만나면 차이는 더 커진다
-
같은 뜻인데 표기만 다르다고 비용이 달라진다면, 방언 화자를 대상으로 한 서비스의 단가는 어떻게 산정해야 하는가. 이 질문이 실무 활동의 출발점이다
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. 학습률을 크게 하면 더 빨리 배우는 것 아닌가?
어느 정도까지는 그렇다. 하지만 위의 표에서 lr = 1.05는 20걸음 뒤 손실이 9에서 407로 오히려 커졌다. 한 걸음이 너무 크면 골짜기 바닥을 건너뛰어 반대편 언덕으로 올라가고, 그 반복이 점점 커진다. 손실이 줄지 않거나 폭발하면 학습률을 먼저 낮춰 본다.
Q2. 손실이 0이 되면 완벽한 모델인가?
학습에 쓴 데이터에서는 완벽하게 맞췄다는 뜻일 뿐이다. 처음 보는 데이터에서도 잘하는지는 따로 확인해야 한다. 그래서 실습에서는 학습용과 평가용 데이터를 나누고, 평가 점수를 함께 본다.
Q3. “새로 초기화되었다”는 경고가 뜨면 뭔가 잘못 불러온 것인가?
분류 과제에서는 정상이다. 사전학습 체크포인트에는 “긍정/부정 판정 부품”(분류 헤드)이 없어서 빈 부품을 새로 만든다는 안내다. 이 부품은 이번 주와 3주차 학습에서 채워진다. 반대로 모델 본체의 가중치까지 새로 초기화됐다는 경고라면 모델 이름이나 경로를 다시 확인한다.
Q4. FlashAttention을 쓰면 결과가 조금 달라지는 근사 계산인가?
아니다. 계산 순서와 메모리 사용 방식을 바꿀 뿐, 수식은 원래 어텐션과 같다. 그래서 “정확한 어텐션”이라고 부른다. 달라지는 것은 속도와 메모리다.
Q5. 오류 메시지가 너무 길어서 읽기 싫다. 어디부터 봐야 하나?
마지막 줄부터 본다. 위쪽의 긴 목록은 “어떤 함수들을 거쳐 여기까지 왔나”라는 경로이고, 진짜 원인은 마지막 줄에 있다. shape 오류라면 괄호 안의 두 모양을 비교하는 것으로 대부분 해결된다.
Q6. 512개만 골라 읽으면 중요한 정보를 놓치지 않나?
놓칠 가능성은 있다. 그래서 두 가지 장치가 함께 있다. 첫째, 인덱서도 학습되기 때문에 “무엇이 중요한가”를 고르는 능력 자체를 익힌다. 둘째, 바로 앞 128토큰은 SWA로 항상 본다. 그래도 근사는 근사이므로, 보고서의 “품질 저하가 미미하다”는 결과는 개발사 자체 평가라는 점을 기억하고 내 과제에서 확인한다.
스스로 점검
Section titled “스스로 점검”- 반 4개, 반마다 학생 25명, 과목 5개의 점수를 담은 텐서의 shape와 전체 칸 수는?
[[1, 2], [3, 4]]와[[5, 6], [7, 8]]의 곱에서 둘째 줄 첫째 칸(43)은 어떻게 계산되는가?loss = (w - 3)^2에서 w = 1.464, lr = 0.1이면 다음 w는 얼마인가?- 오차가 [2, -2, 0]일 때 MSE와 MAE는 각각 얼마인가?
- 데이터 2,400건을 배치 크기 32로 학습하면 한 에폭은 몇 step인가?
- DeepSeek-V4.1-Flash의 인코더 Full 층 하나(압축 비율 2)가 토큰 1,000개에 대해 저장하는 main KV는 몇 바이트인가? (항목 하나 288바이트)
- 후보 풀이 최대 16,384개일 때, 문맥이 250,000토큰이면 Reindex 층의 채점 수는 전체를 훑는 경우의 약 몇 분의 1인가? 1,000,000토큰이면?
정답 보기
- shape는 (4, 25, 5), 칸 수는 4 x 25 x 5 = 500
- 왼쪽 둘째 줄 [3, 4]와 오른쪽 첫째 세로줄 [5, 7]을 짝지어 3 x 5 + 4 x 7 = 15 + 28 = 43
- 기울기 2 x (1.464 - 3) = -3.072, 새 w = 1.464 - 0.1 x (-3.072) = 1.7712
- MSE = (4 + 4 + 0) / 3 = 2.667, MAE = (2 + 2 + 0) / 3 = 1.333
- 2,400 / 32 = 75 step
- 토큰 1,000개가 항목 1,000 / 2 = 500개, 500 x 288 = 144,000바이트
- 250,000 / 16,384 = 약 15분의 1, 1,000,000 / 16,384 = 약 61분의 1. 문맥이 4배가 되어도 채점 수는 최대 16,384개로 같아서, 문맥이 길수록 아끼는 비율이 커진다
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 한 줄 뜻 |
|---|---|
| 텐서 | 숫자를 담는 상자. 스칼라·벡터·행렬을 모두 포함하는 이름 |
| shape | 텐서의 크기표. 방향별 칸 수 |
| 행렬 곱셈 | 왼쪽 가로줄과 오른쪽 세로줄을 짝지어 곱해 더하는 계산 |
| 손실 (loss) | 예측이 정답과 얼마나 다른지 나타낸 숫자 하나 |
| 그래디언트 | 가중치를 조금 바꿀 때 손실이 얼마나, 어느 쪽으로 변하는지 |
| 자동미분 | 연산 기록을 거꾸로 따라가며 그래디언트를 구해 주는 기능 |
| 경사하강법 | 그래디언트의 반대 방향으로 한 걸음씩 가중치를 고치는 방법 |
| 학습률 (lr) | 한 걸음의 크기 |
| MSE / MAE | 오차를 제곱해 평균 / 절댓값으로 평균 낸 손실 |
| 배치 / step / 에폭 | 한 번에 넣는 묶음 / 묶음 하나 처리 / 데이터 전체 한 바퀴 |
| 토크나이저 | 글을 조각내 번호로 바꾸는 부품 |
| 체크포인트 | 미리 학습해 저장해 둔 가중치 파일 |
| 분류 헤드 | 문장 표현을 판정 점수로 바꾸는 마지막 부품 |
| SRAM / HBM | GPU의 작고 빠른 메모리 / 크고 느린 메모리 |
| 타일링 / 재계산 | 표를 조각내 처리하기 / 저장 대신 필요할 때 다시 계산하기 |
| 슬라이딩 윈도 어텐션 (SWA) | 바로 앞 몇 개(여기서는 128개) 토큰만 보는 어텐션 |
| 인덱서 / Top-K | 전역 KV 항목에 점수를 매기는 가벼운 검색기 / 점수 상위 K개 선택 |
| CSA2 Full / Reindex / Reuse | 메모장과 선택을 직접 만들기 / 메모장만 빌리기 / 둘 다 빌리기 |
| 후보 풀 | 디코더 첫 Full 층의 인덱서가 추려 뒤 층의 검색 범위로 넘기는 위치 모음 |
| FP4 | 숫자를 4비트로 적는 형식. 보조 눈금(스케일)과 함께 쓴다 |
| QAT | 학습 중에 양자화를 흉내 내어 모델이 거친 눈금에 적응하게 하는 방법 |
| 인과 인코더-디코더 (CED) | 디코더 전역 KV를 인코더 마지막 층 출력에서 바로 뽑아 입력 처리를 거의 절반으로 줄이는 구조 |
| SWA 제한 재생 | 사라진 SWA KV를 마지막 128토큰만 다시 계산해 근사로 되살리기 |
실습 노트북
Section titled “실습 노트북”
학습 루프를 끝까지 돌려 손실이 낮아지는 것을 확인하고, 방언·표준어 표기가 토크나이저에서 다른 비용으로 이어지는 것을 실측한다.